Esta página explora los resultados de nuestro MongoDB búsqueda vectorial benchmark de rendimiento. MongoDB ofrece una gama de soluciones que admiten diversas necesidades de implementación. Los clientes pueden elegir los niveles de rendimiento y precisión que se adaptan a su configuración empresarial específica.
Resumen de resultados
Con 15.3M de vectores que utilizan
voyage-3-largeincrustaciones en 2048 dimensiones, MongoDB Vector Search con la cuantificación configurada mantiene una precisión del 90-95% con una latencia de query inferior a 50ms.La cuantización binaria ofrece una solución más económica, a aproximadamente una cuarta parte del costo de generar el índice. Dado que recalcula la puntuación con vectores de máxima fidelidad, puede ser una opción preferible para muchas cargas de trabajo a gran escala, aunque recomendamos realizar pruebas con el conjunto de datos de muestra para garantizar que el rendimiento se ajuste a sus necesidades.
Recomendamos más de 1024 dimensiones al ejecutar cargas de trabajo más grandes con cuantización.
Los filtros selectivos pueden mejorar o empeorar el rendimiento dependiendo del valor seleccionado para
numCandidates.El costo adicional de recalificación para la cuantización binaria se manifiesta en un rendimiento reducido al ejecutar cargas de trabajo altamente concurrentes.
El particionamiento mejora ligeramente el rendimiento, pero seguimos recomendando escalar la cantidad de Nodos de Búsqueda o el número de núcleos disponibles en un Nodo de Búsqueda para mejorar el rendimiento.
Recuperación y análisis de latencia en referencia a un benchmark multidimensional
El primer conjunto de resultados muestra las pruebas que ejecutamos contra un conjunto de datos de documentos 5.5M que contiene múltiples dimensionalidades de vectores (256, 512, 1024, 2048), todos producidos utilizando voyage-3-large, dentro de cada documento.
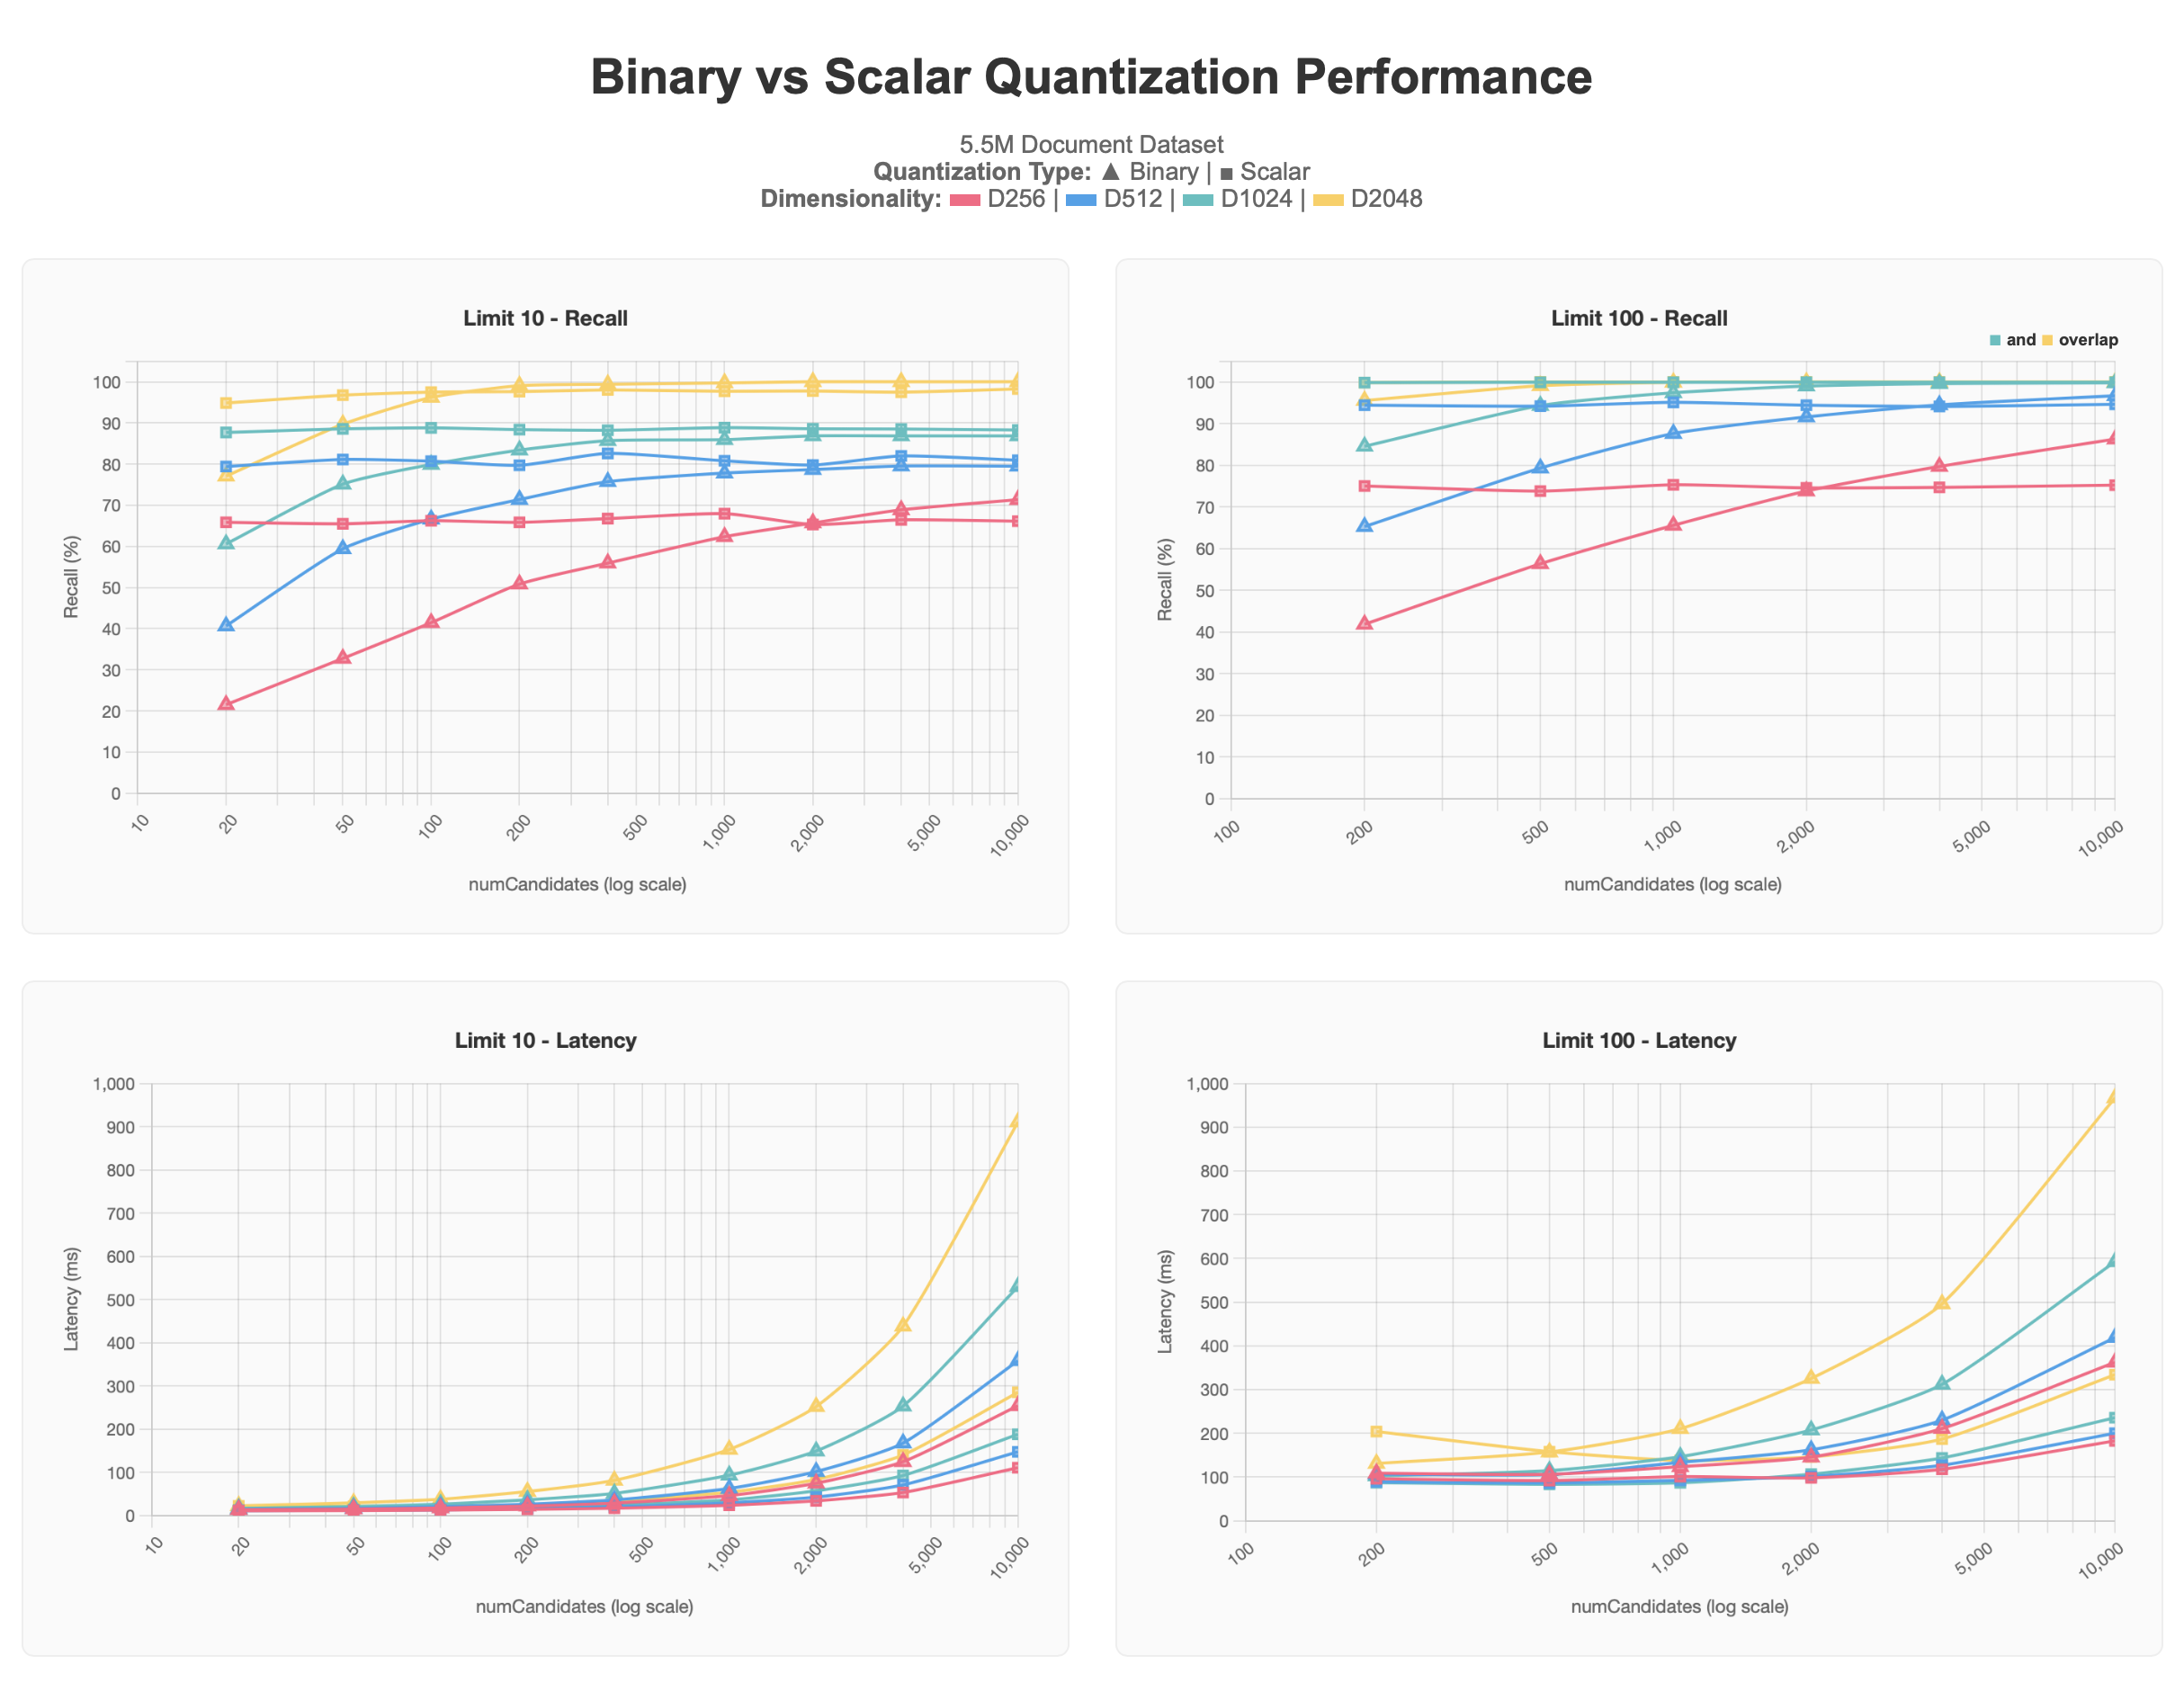
Los resultados de cuantificación escalar comienzan todos en niveles más altos que los resultados de cuantificación binaria, pero se mantienen en su nivel asintótico incluso cuando numCandidates aumenta. Por el contrario, las consultas de cuantificación binaria producen resultados más precisos a medida que se solicitan más numCandidates, acercándose a la asíntota de la cuantificación escalar y, en algunos casos, superándola, a costa de una mayor latencia, especialmente por encima de numCandidates de 1000.
Los valores más bajos de limit generalmente requieren un numCandidates más alto para acercarse a una precisión del 100%, porque la query es más selectiva sobre los resultados principales. Este efecto es particularmente visible en el gráfico de cuantificación binaria. Los vectores de mayor dimensión (1024d y superiores) alcanzan el rango objetivo del 90-95% con un numCandidates más bajo, ya que la representación más rica facilita la distinción de los vecinos cercanos. Las pruebas que limit los resultados a 100 alcanzan el rango objetivo del 90-95% con un numCandidates más bajo que las pruebas que limit los resultados a 10, porque el conjunto de resultados más grande le da a la búsqueda más oportunidades para mostrar vecinos relevantes.
Dada esta información, determinamos que cuando se trabaja con un gran conjunto de datos, recomendamos tener una dimensionalidad de al menos 1024d y aplicar cuantización para escalar en lugar de tener menor dimensionalidad y no usar cuantización, y la cantidad de vectores solicitados para el caso de uso también juega un papel.
Resultados de benchmark más grandes
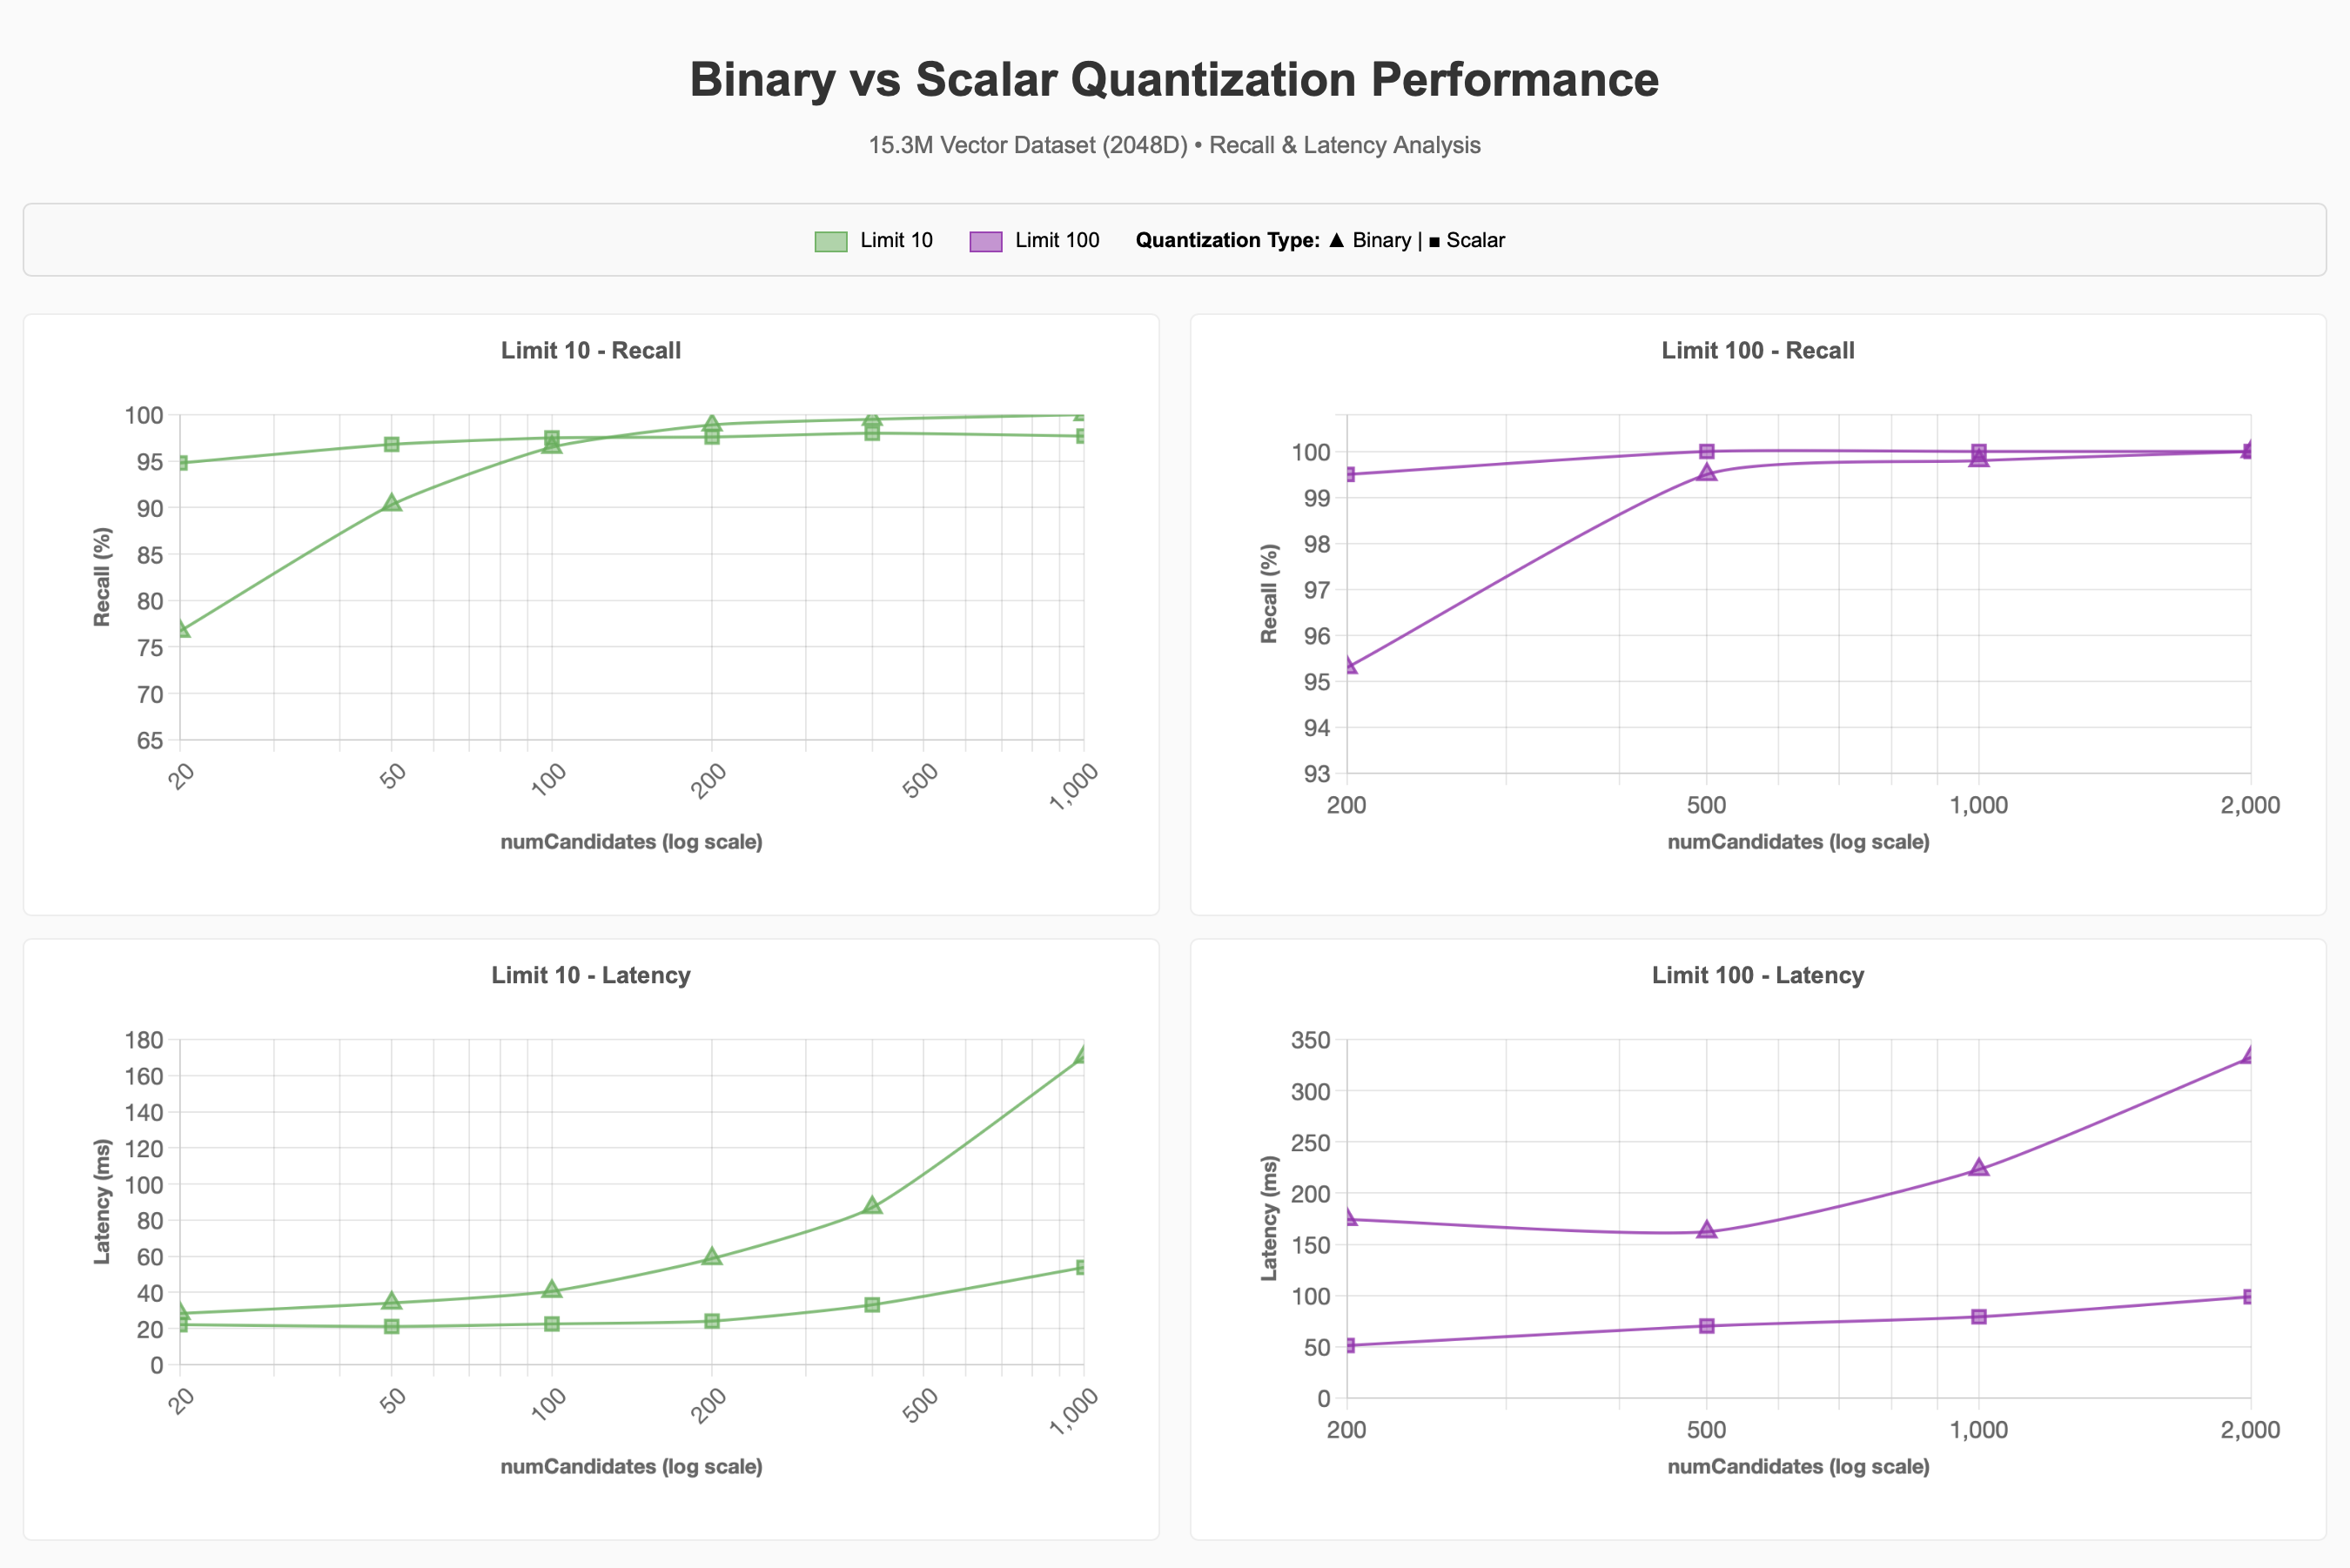
Para el conjunto de datos vectoriales 15.3M más grande, fijamos la dimensionalidad a 2048d y examinamos el impacto de la cuantización, el filtrado y la concurrencia en el rendimiento. Elegimos usar 2048d basándonos en los resultados de la prueba anterior, que mostraban que dimensiones superiores mantenían el recall de manera más favorable, aunque 1024d probablemente habría servido igual de bien para alcanzar el objetivo de recall del 90-95%.
Análisis de recuperación de datos y latencia
Observamos que se necesita significativamente más numCandidates al utilizar cuantificación binaria para alcanzar el objetivo de recall del 90-95% en comparación con la línea base. Una mayor numCandidates generalmente significa una mayor latencia, pero esto puede variar.
Filtrado
Observamos lo que sucede con la recuperación y la latencia al usar un filtro selectivo en el conjunto de datos para aproximadamente500mil elementos de los 15.3M de elementos que se encuentran en la Categoría de Suministros para mascotas (aproximadamente3% del corpus):
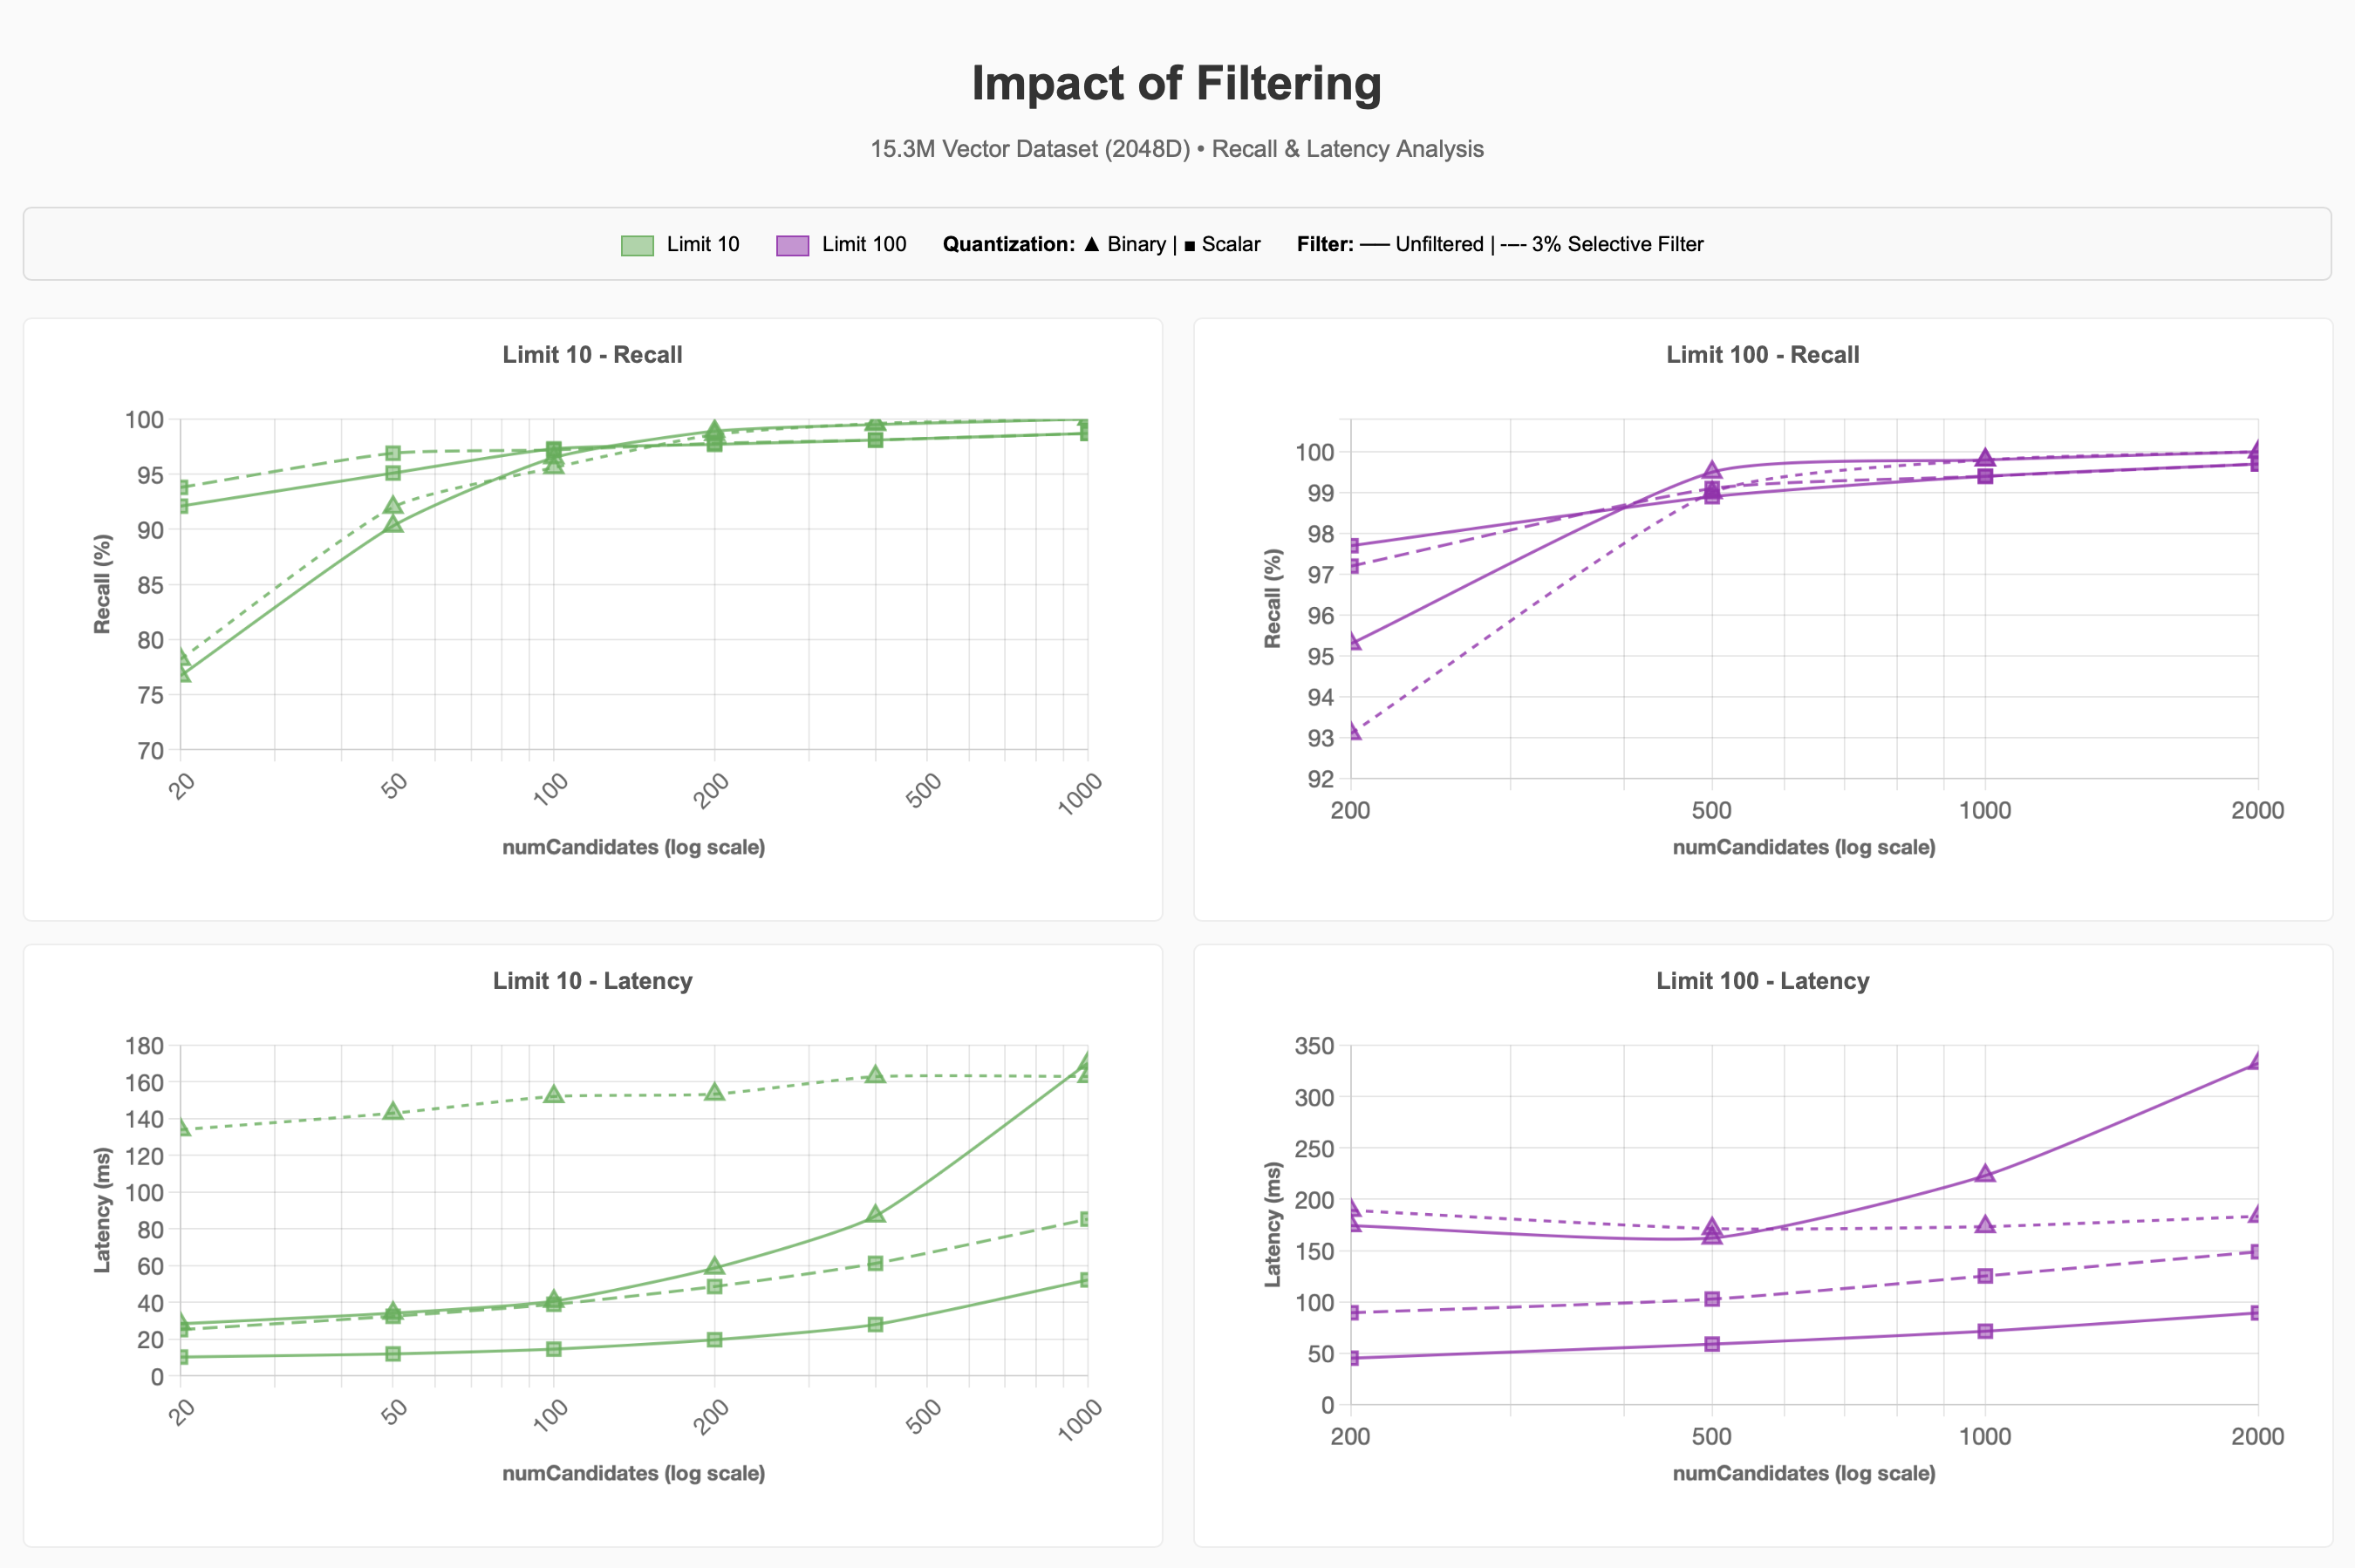
Un filtro selectivo es un filtro que solo coincide con una pequeña parte de los datos (en este caso, ~3%). Debido a que el motor de búsqueda ahora debe encontrar los vecinos más cercanos dentro de este pequeño subconjunto, tiene que explorar más del índice y evaluar más candidatos para alcanzar la misma recuperación. Cada query realiza más trabajo que una query sin filtrar.
Como se anticipó, podemos ver que el filtro selectivo 3% puede hacer que las consultas realicen más trabajo. Para la cuantización binaria en valores limit más bajos, esto requirió aproximadamente 4 veces más trabajo para lograr una recuperación del 90-95% en comparación con las consultas sin filtrar.
Las mejoras futuras en Lucene 10, que admitan estrategias de búsqueda Acorn-1 para Mundos pequeños jerárquicamente navegables, podrían mejorar este proceso. Sin embargo, realizar ENN cuando el número de candidatos solicitados supera el número de vectores que coinciden con el filtro de metadatos en un segmento demuestra que la selectividad del filtro desempeña un papel importante en el rendimiento de la query, independientemente del régimen de cuantificación seleccionado.
Simultaneidad
Estas pruebas escalan las solicitudes simultáneas entre 1, 10 y 100 en los diversos valores limit al usar cuantización escalar y binaria. numCandidates se seleccionan eligiendo valores que permiten alcanzar un 90-95% de recall:
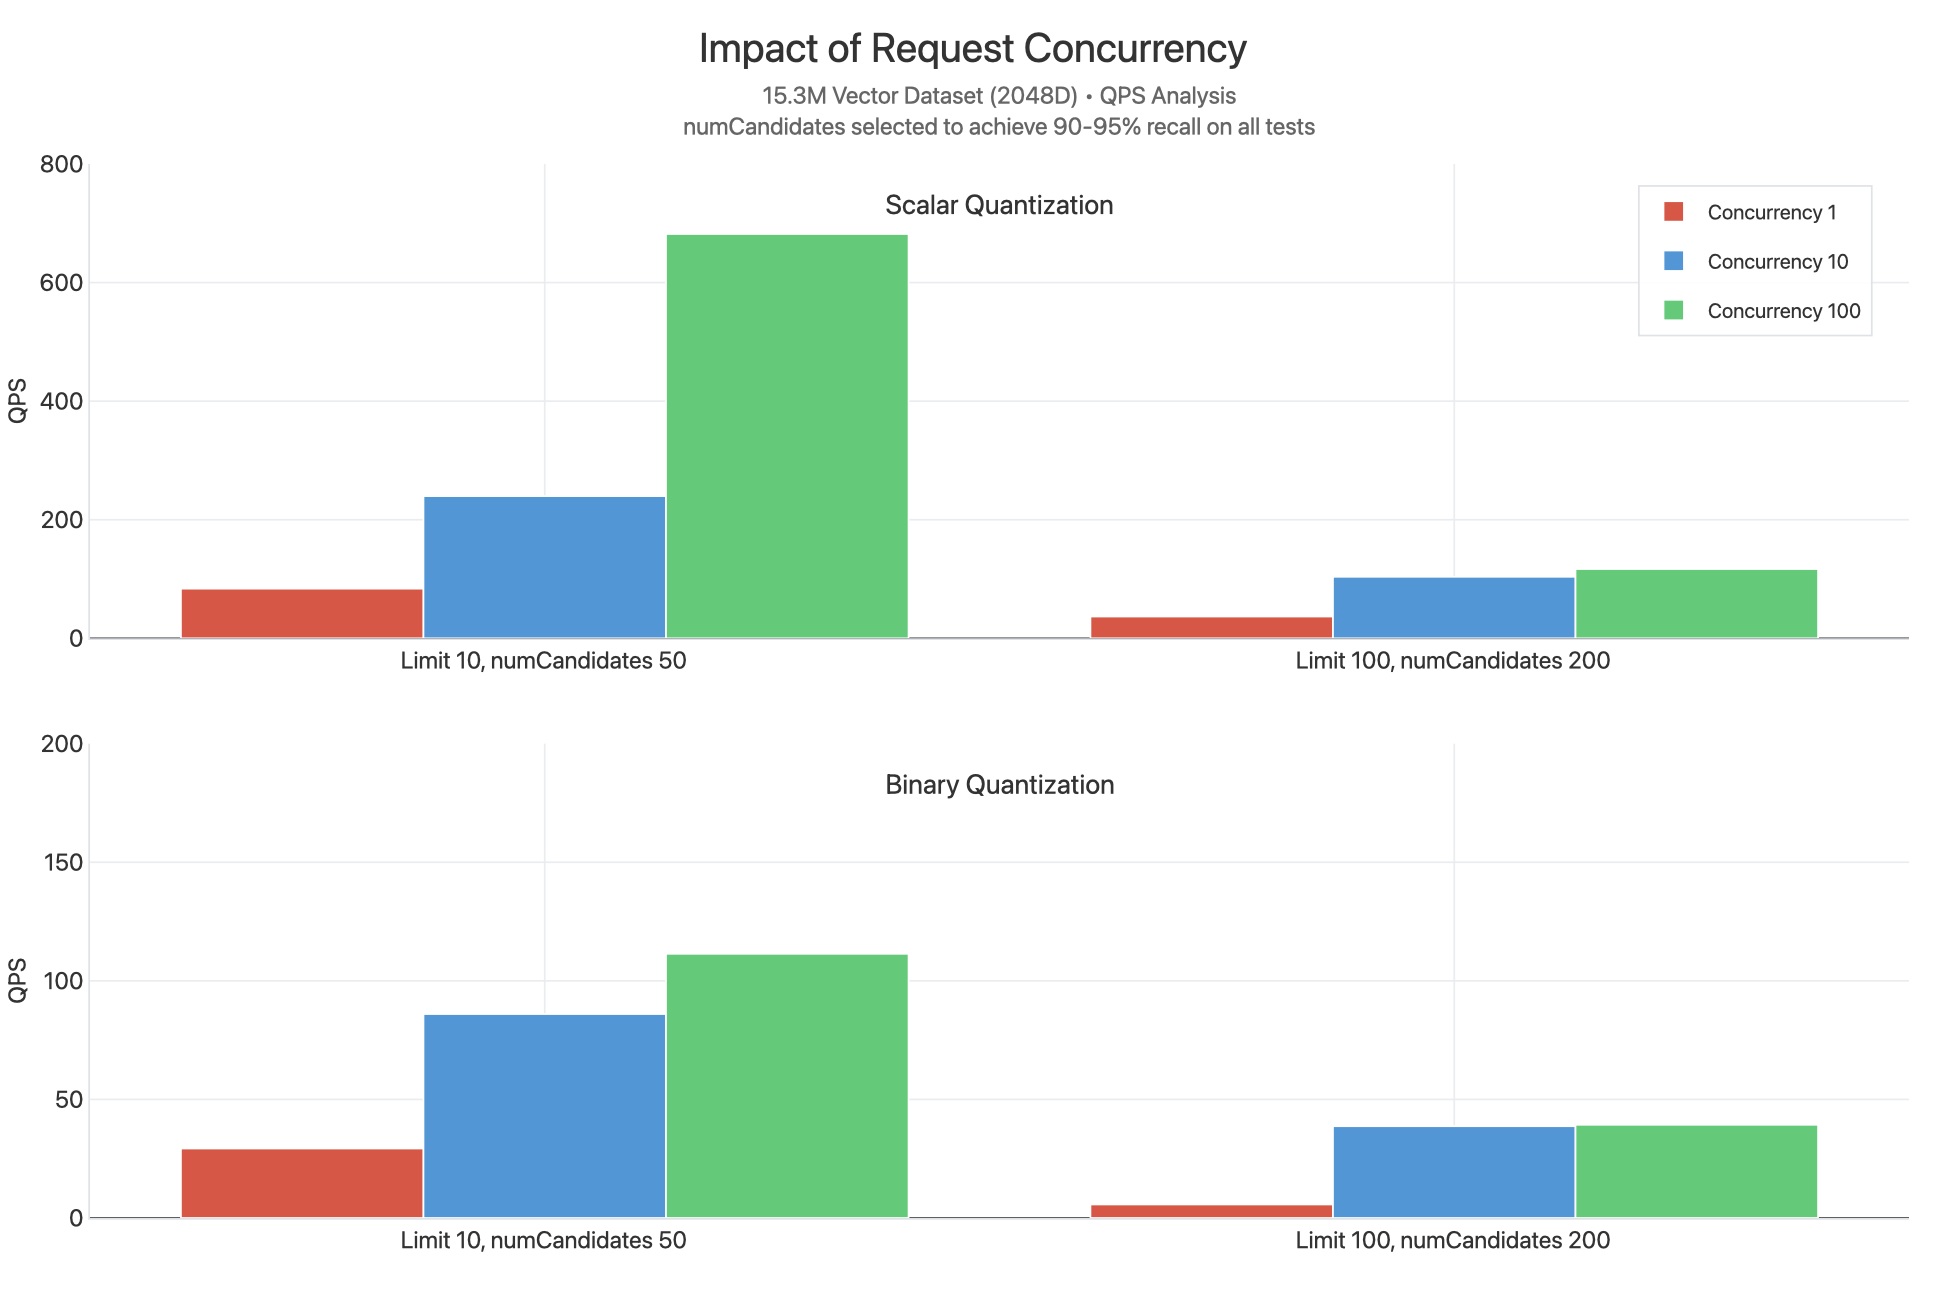
Observamos que la cuantización escalar logra un QPS más alto para todos los valores de limit, probablemente porque cada consulta puede completarse con un numCandidates menor y sin repuntuación. Con niveles de concurrencia más altos, las curvas de QPS para la concurrencia 10 y la concurrencia 100 están muy próximas, lo que sugiere que el sistema está utilizando eficientemente los recursos de CPU disponibles y que la concurrencia adicional afecta principalmente a la latencia.
Un dato excepcional es el límite 10, concurrencia 100 para la cuantización escalar, que produce un QPS significativamente mayor. Esto probablemente se deba a que la ausencia de repuntuación y los valores limit más bajos implican que se realizan menos comparaciones para esta consulta, lo que permite que cada solicitud se procese más rápidamente y que los núcleos estén disponibles para atender otras consultas.
Escalar el número de vCPU disponibles para servir solicitudes, ya sea escalando el nivel de nodo de búsqueda o escalando el número de nodos de búsqueda desde el mínimo de 2 hasta 32 nodos, podría ayudar a resolver los cuellos de botella de la simultaneidad y permitir escalar hasta miles de QPS.
particionado
También observamos lo que sucedería si el clúster y la colección se particionaran (en _id) y se emitieran queries sin filtrar sobre un índice cuantificado binario.
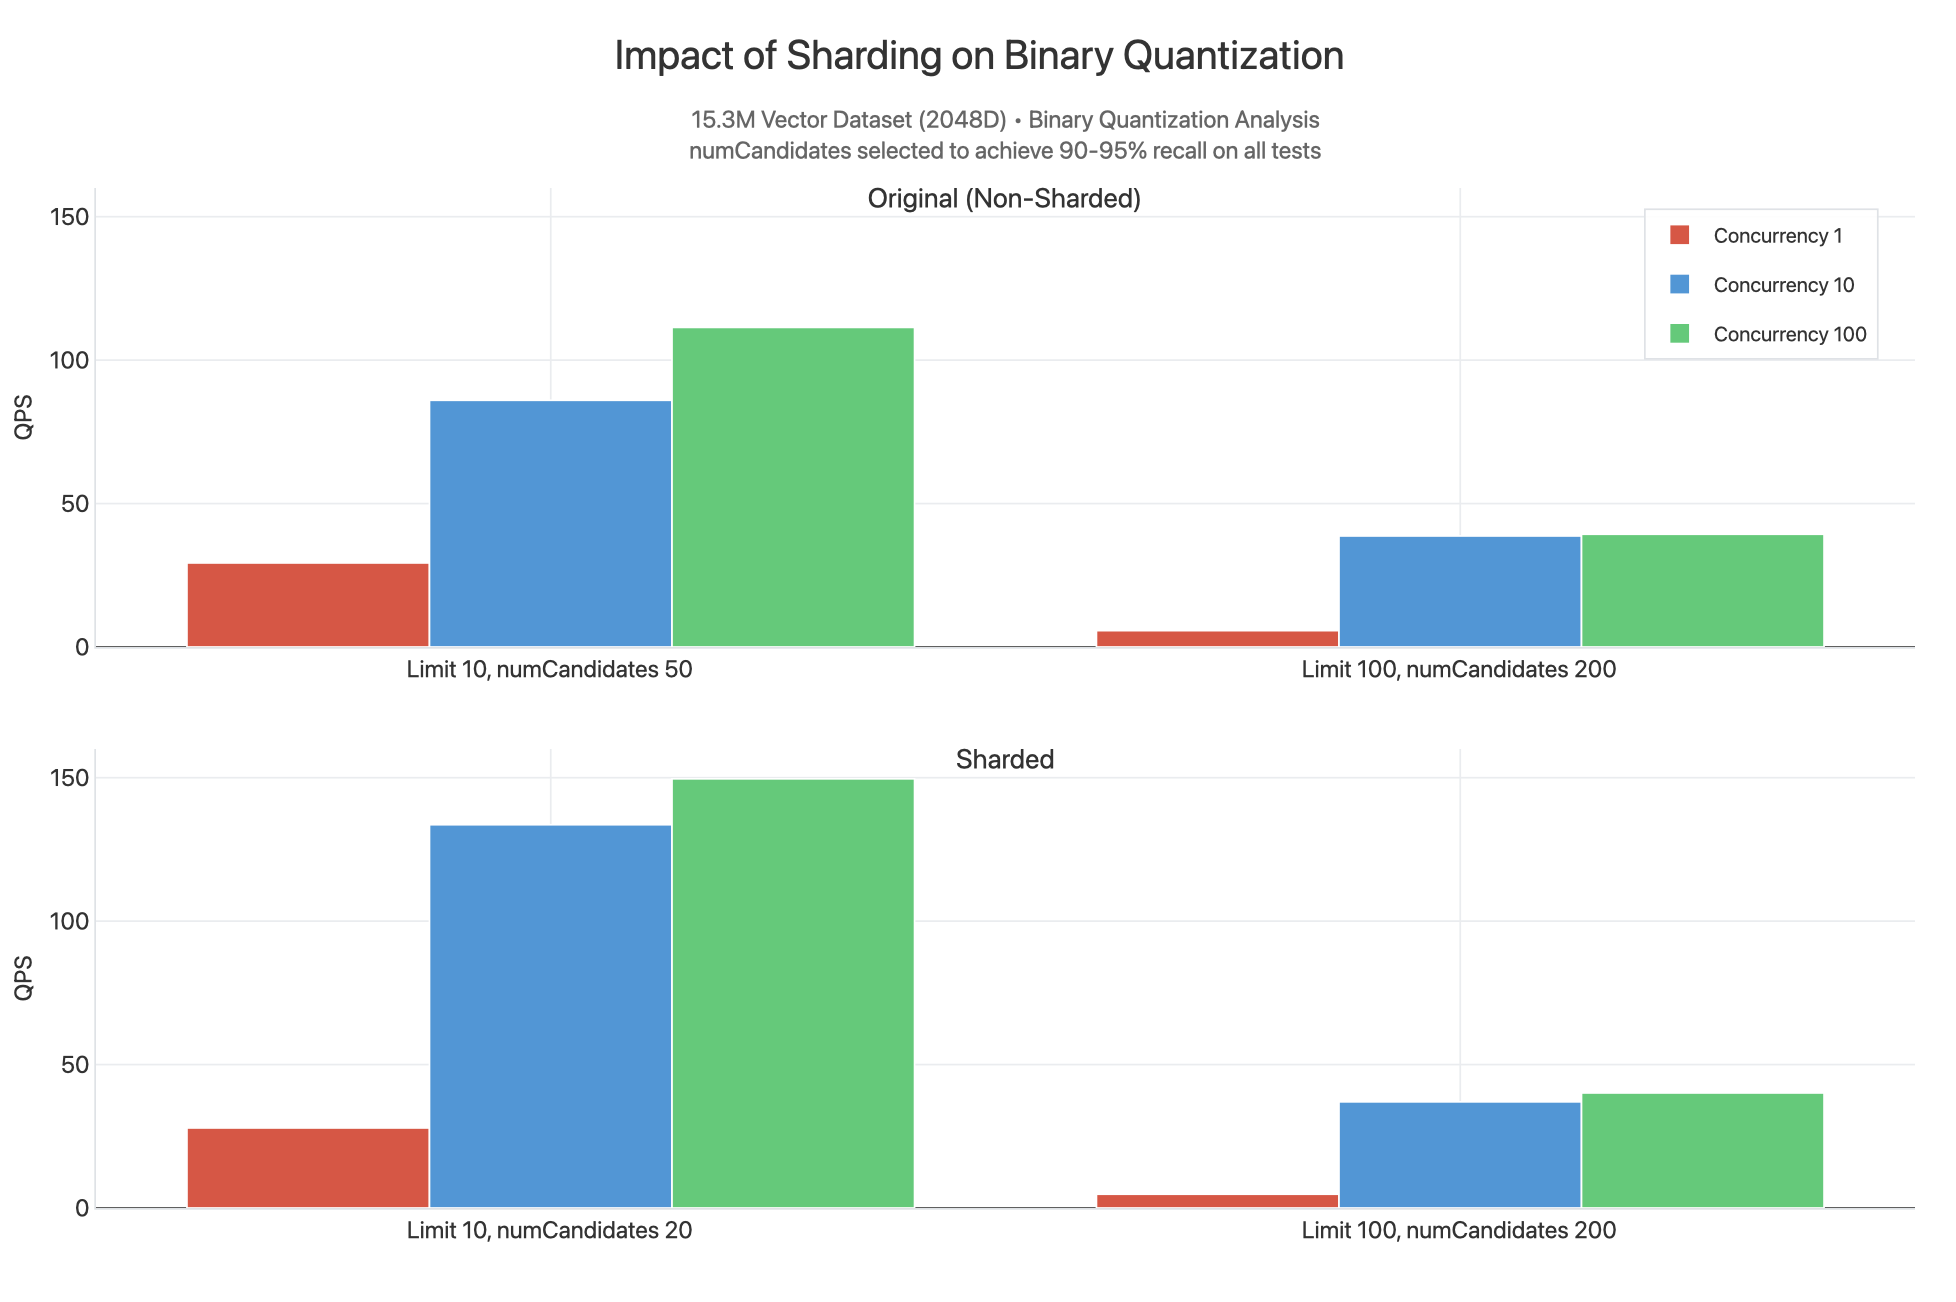
Aquí vemos que los resultados fragmentados tienen un QPS más alto en el límite 10 ya que se puede proporcionar un valor más bajo de numCandidates para producir resultados en el rango de recuperación 90-95%. Esto se debe a que el conjunto de datos 15.3M se divide en tres fragmentos, cada uno de los cuales tiene sus propios índices llenos con vectores 5.1M distribuidos en segmentos que contienen gráficos HNSW. Funcionalmente estamos haciendo una búsqueda menos avanzada donde es más probable que cada dispersión de consulta reunida en 3 fragmentos simultáneamente pueda encontrar los vectores n más cercanos. Por esta razón, el QPS es ligeramente más alto cuando se fragmenta, ya que se puede reducir numCandidates y tener más núcleos disponibles para atender consultas, pero la diferencia no es muy significativa. Dado que el rendimiento de la búsqueda de vectores sigue siendo fiable, no es necesario fragmentar el clúster para escalar su rendimiento.
Nota
Los valores son similares para limit 100, numCandidates 200. Podríamos esperar que esto funcione mejor para queries filtradas con una coincidencia de clave de partición inteligente utilizada como filtro.