Definición
$densifyNuevo en la versión 5.1.
Crea nuevos documentos en una secuencia de documentos donde faltan ciertos valores en un campo.
Puedes usar
$densifypara:Rellene los vacíos en los datos de series de tiempo.
Agrega valores faltantes entre grupos de datos.
Llene sus datos con un rango especificado de valores.
Sintaxis
La etapa $densify tiene esta sintaxis:
{ $densify: { field: <fieldName>, partitionByFields: [ <field 1>, <field 2> ... <field n> ], range: { step: <number>, unit: <time unit>, bounds: < "full" || "partition" > || [ < lower bound >, < upper bound > ] } }}La etapa $densify toma un documento con estos campos:
Campo | Necesidad | Descripción |
|---|---|---|
Requerido | El campo para densificar. Los valores de la Los documentos que no contienen el Para especificar un Para conocer las restricciones, consulte | |
Opcional | El conjunto de campos que actúan como clave compuesta para agrupar los documentos. En la etapa Si omite este campo, Para un ejemplo, consulta Densificación con particiones. Para conocer las restricciones, consulte | |
Requerido | Un objeto que especifica cómo se densifican los datos. | |
Requerido | Puedes especificar
Si
Si
Si
| |
Requerido | La cantidad en la que se incrementará el valor del campo en cada documento. Si se especifica rango.unit, | |
Obligatorio si campo es una fecha. | La unidad que se aplicará al campo step al incrementar valores de fecha en field. Puedes especificar uno de los siguientes valores para
Para ver un ejemplo, consulte Densificar datos de series de tiempo. |
Comportamiento y restricciones
field Restricciones
Para documentos que contengan el campo especificado, $densify produce errores si:
Cualquier documento en la colección tiene un valor
fieldde tipo fecha y el campo unit no está especificado.Cualquier documento en la colección tiene un valor
fielddel tipo numérico y se especifica el campo de unidad.El nombre
fieldcomienza con$. Tienes que renombrar el campo si deseas densificarlo. Para cambiar el nombre de los campos, usa$project.Nuevo en la versión 8.1:
fieldcomparte su prefijo con cualquier campo del arreglopartitionByFields. Por ejemplo, las siguientes combinaciones defieldypartitionByFieldsdan como resultado un error:field: "timestamp",partitionByFields: ["timestamp"]field: "timestamp",partitionByFields: ["timestamp.hours"]field: "timestamp.hours",partitionByFields: ["timestamp"]
partitionByFields Restricciones
$densify Errores si algún nombre de campo en el arreglo:
Evalúa a un valor que no es una cadena.
Comienza con
$.
range.bounds Comportamiento
Si range.bounds es un arreglo:
El límite inferior indica el valor inicial para los documentos añadidos, independientemente de los documentos que ya estén presentes en la colección.
El límite inferior es inclusivo.
El límite superior es exclusivo.
Nota
A partir de MongoDB 8.0, $densify trata los límites con una cota superior e inferior igual como un conjunto vacío y no genera un documento con ese valor para el campo.
En versiones anteriores, $densify trata los límites con un límite inferior y superior iguales como un intervalo cerrado y genera un documento con el valor del límite como valor de campo si la colección aún no contiene un documento con el valor del límite.
Por ejemplo, un rango.bounds de [10, 10] genera un documento extra con el valor de campo 10 en versiones anteriores a 8.0, pero no genera dicho documento en 8.0 ni posteriores.
Límite de generación de documentos
$densify devuelve un error si genera más documentos que el límite establecido por el parámetro internalQueryMaxAllowedDensifyDocs. Por defecto, este límite es de 500,000 documentos.
Para permitir más documentos generados, aumente el valor del parámetro internalQueryMaxAllowedDensifyDocs.
Orden de salida
$densify no garantiza el orden de clasificación de los documentos que produce.
Para garantizar el orden de clasificación, utiliza $sort en el campo por el que quieras clasificar.
Ejemplos
Densificar datos de series de tiempo
Crear una colección de weather que contenga lecturas de temperatura durante intervalos de cuatro horas.
db.weather.insertMany( [ { "metadata": { "sensorId": 5578, "type": "temperature" }, "timestamp": ISODate("2021-05-18T00:00:00.000Z"), "temp": 12 }, { "metadata": { "sensorId": 5578, "type": "temperature" }, "timestamp": ISODate("2021-05-18T04:00:00.000Z"), "temp": 11 }, { "metadata": { "sensorId": 5578, "type": "temperature" }, "timestamp": ISODate("2021-05-18T08:00:00.000Z"), "temp": 11 }, { "metadata": { "sensorId": 5578, "type": "temperature" }, "timestamp": ISODate("2021-05-18T12:00:00.000Z"), "temp": 12 }] )Este ejemplo utiliza la etapa $densify para completar los intervalos de cuatro horas y lograr una granularidad horaria en los puntos de datos:
db.weather.aggregate( [ { $densify: { field: "timestamp", range: { step: 1, unit: "hour", bounds:[ ISODate("2021-05-18T00:00:00.000Z"), ISODate("2021-05-18T08:00:00.000Z") ] } } }] )En el ejemplo:
La fase
$densifyrellena los vacíos de tiempo entre las temperaturas registradas.field: "timestamp"densifica el campotimestamp.
range:step: 1incrementa el campotimestampen 1 unidad.unit: hourdensifica el campotimestamppor hora.bounds: [ ISODate("2021-05-18T00:00:00.000Z"), ISODate("2021-05-18T08:00:00.000Z") ]establece el rango de tiempo que se densifica.
En el siguiente resultado, la etapa $densify llena los espacios de tiempo entre las horas de 00:00:00 y 08:00:00.
[ { _id: ObjectId("618c207c63056cfad0ca4309"), metadata: { sensorId: 5578, type: 'temperature' }, timestamp: ISODate("2021-05-18T00:00:00.000Z"), temp: 12 }, { timestamp: ISODate("2021-05-18T01:00:00.000Z") }, { timestamp: ISODate("2021-05-18T02:00:00.000Z") }, { timestamp: ISODate("2021-05-18T03:00:00.000Z") }, { _id: ObjectId("618c207c63056cfad0ca430a"), metadata: { sensorId: 5578, type: 'temperature' }, timestamp: ISODate("2021-05-18T04:00:00.000Z"), temp: 11 }, { timestamp: ISODate("2021-05-18T05:00:00.000Z") }, { timestamp: ISODate("2021-05-18T06:00:00.000Z") }, { timestamp: ISODate("2021-05-18T07:00:00.000Z") }, { _id: ObjectId("618c207c63056cfad0ca430b"), metadata: { sensorId: 5578, type: 'temperature' }, timestamp: ISODate("2021-05-18T08:00:00.000Z"), temp: 11 } { _id: ObjectId("618c207c63056cfad0ca430c"), metadata: { sensorId: 5578, type: 'temperature' }, timestamp: ISODate("2021-05-18T12:00:00.000Z"), temp: 12 }]Densificación con particiones
Crea una colección de coffee que contenga datos de dos variedades de granos de café:
db.coffee.insertMany( [ { "altitude": 600, "variety": "Arabica Typica", "score": 68.3 }, { "altitude": 750, "variety": "Arabica Typica", "score": 69.5 }, { "altitude": 950, "variety": "Arabica Typica", "score": 70.5 }, { "altitude": 1250, "variety": "Gesha", "score": 88.15 }, { "altitude": 1700, "variety": "Gesha", "score": 95.5, "price": 1029 } ] )Densificar el rango completo de valores
Este ejemplo utiliza $densify para densificar el campo altitude para cada café variety:
db.coffee.aggregate( [ { $densify: { field: "altitude", partitionByFields: [ "variety" ], range: { bounds: "full", step: 200 } } }] )La agregación de ejemplo:
Divide los documentos por
varietypara crear un agrupamiento paraArabica Typicay otro paraGeshacafé.Especifica un rango
full, lo que significa que los datos se densifican en todo el rango de documentos existentes para cada partición.Especifica un
stepde200, lo que significa que se crean nuevos documentos en intervalos dealtitudede200.
La agregación genera los siguientes documentos:
[ { _id: ObjectId("618c031814fbe03334480475"), altitude: 600, variety: 'Arabica Typica', score: 68.3 }, { _id: ObjectId("618c031814fbe03334480476"), altitude: 750, variety: 'Arabica Typica', score: 69.5 }, { variety: 'Arabica Typica', altitude: 800 }, { _id: ObjectId("618c031814fbe03334480477"), altitude: 950, variety: 'Arabica Typica', score: 70.5 }, { variety: 'Gesha', altitude: 600 }, { variety: 'Gesha', altitude: 800 }, { variety: 'Gesha', altitude: 1000 }, { variety: 'Gesha', altitude: 1200 }, { _id: ObjectId("618c031814fbe03334480478"), altitude: 1250, variety: 'Gesha', score: 88.15 }, { variety: 'Gesha', altitude: 1400 }, { variety: 'Gesha', altitude: 1600 }, { _id: ObjectId("618c031814fbe03334480479"), altitude: 1700, variety: 'Gesha', score: 95.5, price: 1029 }, { variety: 'Arabica Typica', altitude: 1000 }, { variety: 'Arabica Typica', altitude: 1200 }, { variety: 'Arabica Typica', altitude: 1400 }, { variety: 'Arabica Typica', altitude: 1600 }]Esta imagen muestra los documentos creados con $densify:
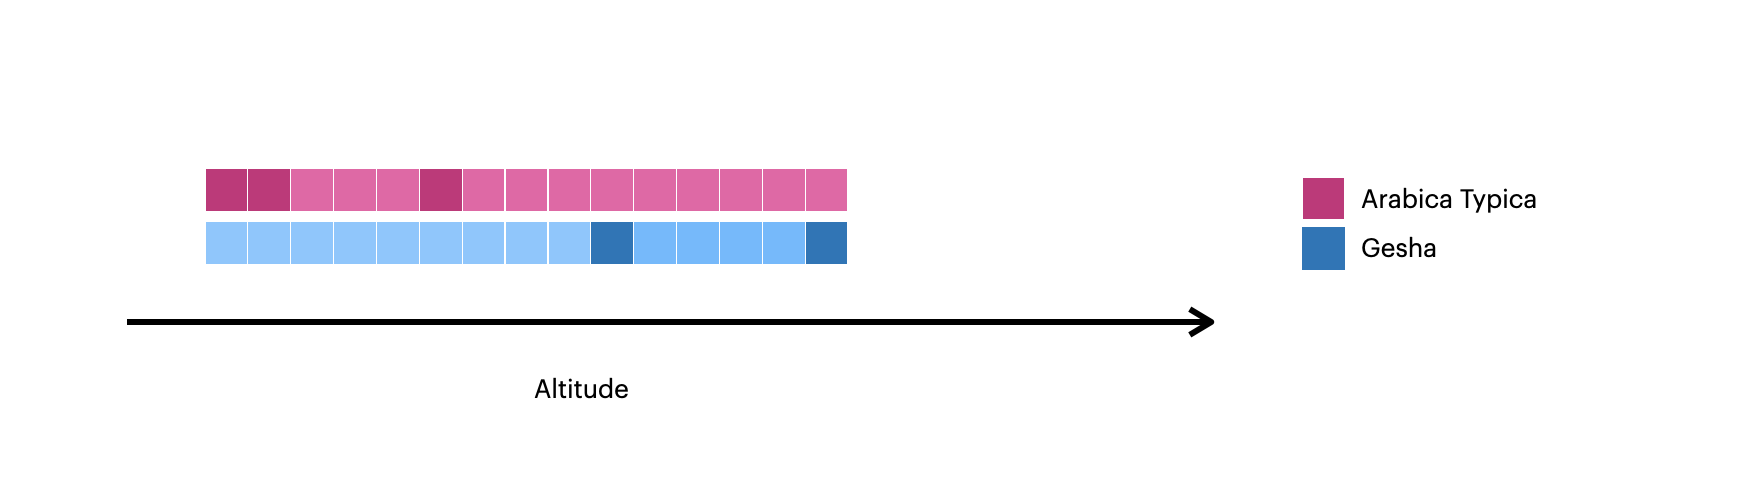
Los cuadros más oscuros representan los documentos originales de la colección.
Los cuadros más claros representan los documentos creados con
$densify.
Densificar valores dentro de cada partición
Este ejemplo utiliza $densify solo para densificar los huecos en el campo altitude dentro de cada variety:
db.coffee.aggregate( [ { $densify: { field: "altitude", partitionByFields: [ "variety" ], range: { bounds: "partition", step: 200 } } }] )La agregación de ejemplo:
Divide los documentos por
varietypara crear un agrupamiento paraArabica Typicay otro paraGeshacafé.Se especifica un rango
partition, lo que significa que los datos se densifican dentro de cada partición.Para la partición
Arabica Typica, el rango es600-950.Para la partición
Gesha, el rango es1250-1700.
Especifica un
stepde200, lo que significa que se crean nuevos documentos en intervalos dealtitudede200.
La agregación genera los siguientes documentos:
[ { _id: ObjectId("618c031814fbe03334480475"), altitude: 600, variety: 'Arabica Typica', score: 68.3 }, { _id: ObjectId("618c031814fbe03334480476"), altitude: 750, variety: 'Arabica Typica', score: 69.5 }, { variety: 'Arabica Typica', altitude: 800 }, { _id: ObjectId("618c031814fbe03334480477"), altitude: 950, variety: 'Arabica Typica', score: 70.5 }, { _id: ObjectId("618c031814fbe03334480478"), altitude: 1250, variety: 'Gesha', score: 88.15 }, { variety: 'Gesha', altitude: 1450 }, { variety: 'Gesha', altitude: 1650 }, { _id: ObjectId("618c031814fbe03334480479"), altitude: 1700, variety: 'Gesha', score: 95.5, price: 1029 }]Esta imagen muestra los documentos creados con $densify:
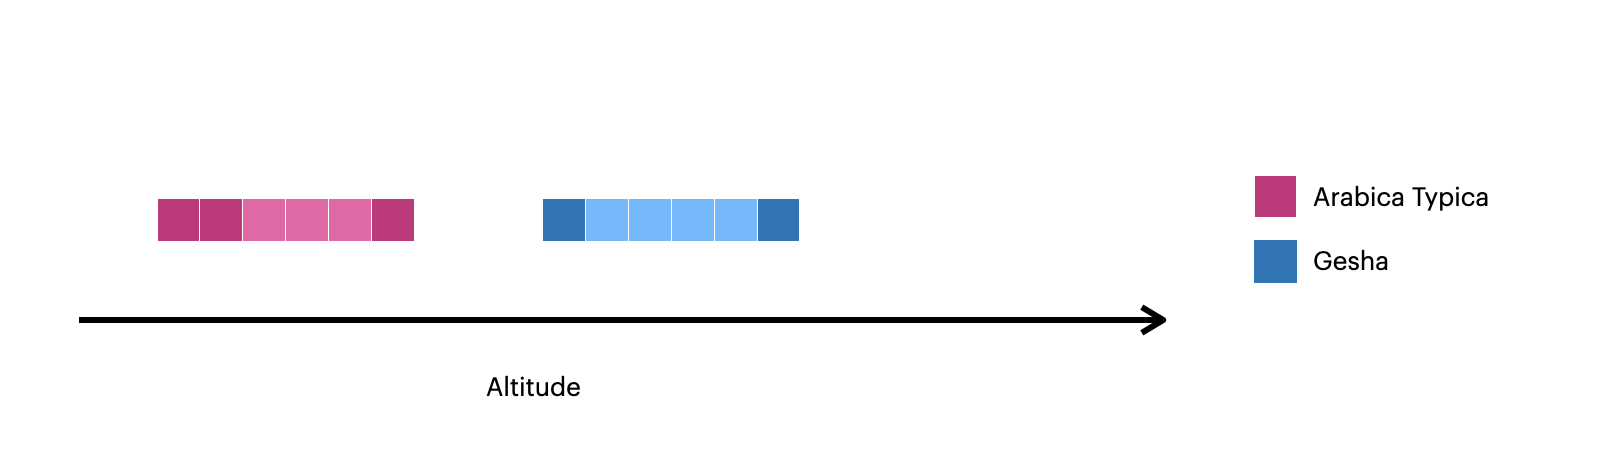
Los cuadros más oscuros representan los documentos originales de la colección.
Los cuadros más claros representan los documentos creados con
$densify.
Los ejemplos de C# en esta página utilizan la colección sample_weatherdata.data de los conjuntos de datos de muestra de Atlas. Para aprender a crear un clúster gratuito de MongoDB Atlas y cargar los conjuntos de datos de muestra, consulta Empezar en la documentación del driver de MongoDB .NET/C# .
Las siguientes clases Weather y Point modelan los documentos en la colección sample_weatherdata.data:
[BsonIgnoreExtraElements]public class Weather{    [BsonId]    public ObjectId Id { get; set; }
    [BsonElement("position")]    public Point Position { get; set; } = null!;
    [BsonElement("ts")]    public DateTime Timestamp { get; set; }}
public class Point{    [BsonElement("type")]    public string Type { get; set; } = null!;
    [BsonElement("coordinates")]    public double[] Coordinates { get; set; } = null!;}
Para utilizar el controlador de MongoDB .NET/C# para añadir una etapa $densify a una canalización de agregación, llame al método UnionWith() en un objeto PipelineDefinition.
El siguiente ejemplo crea una etapa de pipeline que filtra documentos en las coordenadas [-47.9, 47.6] y luego añade un documento a cada intervalo de 15minutos entre los dos documentos de origen. El código separa los documentos según los valores de su campo Position.Coordinates.
var matchFilter = Builders<Weather>.Filter.Eq(    w => w.Position.Coordinates,    new double[] { -47.9, 47.6 });
var densifyTimeRange = new DensifyDateTimeRange(    new DensifyLowerUpperDateTimeBounds(        lowerBound: new DateTime(1984, 3, 5, 13, 0, 0, DateTimeKind.Utc),        upperBound: new DateTime(1984, 3, 5, 14, 0, 0, DateTimeKind.Utc)    ),    step: 15,    unit: DensifyDateTimeUnit.Minutes);
var pipeline = new EmptyPipelineDefinition<Weather>()    .Match(matchFilter)    .Densify(        field: w => w.Timestamp,        range: densifyTimeRange,        partitionByFields: [w => w.Position.Coordinates]);
La etapa de agregación anterior genera los siguientes documentos destacados en la colección:
{ _id: ObjectId("..."), position: { type: "Point", coordinates: [-47.9, 47.6] }, ts: 1984-03-05T13:00:00Z, ... }{ position: { coordinates: [-47.9, 47.6] }, ts: 1984-03-05T13:15:00Z }{ position: { coordinates: [-47.9, 47.6] }, ts: 1984-03-05T13:30:00Z }{ position: { coordinates: [-47.9, 47.6] }, ts: 1984-03-05T13:45:00Z }{ _id: ObjectId("..."), position: { type: "Point", coordinates: [-47.9, 47.6] }, ts: 1984-03-05T14:00:00Z, ... }Los ejemplos de Node.js en esta página utilizan la colección sample_weatherdata.data de los conjuntos de datos de muestra de Atlas. Para aprender a crear un clúster gratuito de MongoDB Atlas y cargar los conjuntos de datos de muestra, se puede consultar Primeros pasos en la documentación del driver de MongoDB Node.js.
La colección sample_weatherdata.data contiene los siguientes documentos, que incluyen mediciones para el mismo campo position con una diferencia de una hora:
{_id: new ObjectId(...), ts: 1984-03-05T13:00:00.000Z, position: {type: 'Point', coordinates: [-47.9, 47.6]}, ... },{_id: new ObjectId(...), ts: 1984-03-05T14:00:00.000Z, position: {type: 'Point', coordinates: [-47.9, 47.6]}, ... }Para utilizar el controlador de MongoDB Node.js para agregar una etapa de $densify a una canalización de agregación, utilice el Operador $densify en un objeto de canalización.
El siguiente ejemplo crea una etapa de pipeline que añade un documento cada intervalo de 15minutos entre los dos documentos anteriores. A continuación, el código agrupa estos documentos según los valores de su campo position.coordinates. Luego, el ejemplo ejecuta la pipeline de agregación:
const pipeline = [  {    $densify: {      field: "ts",      partitionByFields: ["position.coordinates"],      range: {        step: 15,        unit: "minute",        bounds: [new Date(1984, 3, 5, 8, 0, 0), new Date(1984, 3, 5, 9, 0, 0)]      }    }  }];
const cursor = collection.aggregate(pipeline);return cursor;
La etapa de agregación anterior genera los siguientes documentos destacados en la colección:
{ _id: new ObjectId(...), ts: 1984-03-05T13:00:00.000Z, position: {type: 'Point', coordinates: [-47.9, 47.6]}, ... },{ position: { coordinates: [-47.9, 47.6] }, ts: 1984-03-05T13:15:00.000Z },{ position: { coordinates: [-47.9, 47.6] }, ts: 1984-03-05T13:30:00.000Z },{ position: { coordinates: [-47.9, 47.6] }, ts: 1984-03-05T13:45:00.000Z },{ _id: new ObjectId(...), ts: 1984-03-05T14:00:00.000Z, position: {type: 'Point', coordinates: [-47.9, 47.6]}, ... }