Atlas Core es la base de datos en la nube totalmente administrada, junto con su base de datos asociada, construida sobre una arquitectura donde el procesamiento y el almacenamiento se ejecutan en el mismo nodo. Está disponible en clústeres gratuitos, clústeres Flex y niveles de clúster dedicados.
Para obtener información sobre las distintas ediciones de bases de datos y sus diferencias, consulte la sección Ediciones de bases de datos. Para una comparación lado a lado, consulte el diagrama comparativo de ediciones.
La documentación existente del clúster Atlas describe Atlas Core de forma predeterminada. Esta página es el punto de partida para Atlas Core y le ayuda a identificar a qué edición se aplica el contenido existente.
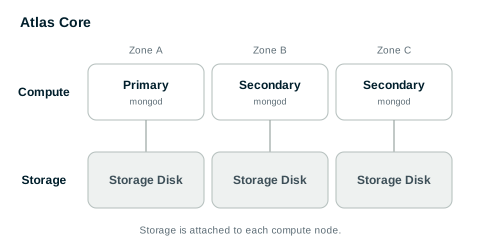
En este ejemplo de configuración, un clúster Atlas Core ejecuta un nodo principal y dos nodos secundarios, y cada nodo tiene su propio almacenamiento conectado.
Arquitectura
Los clústeres Atlas Core proporcionan capacidad de procesamiento y almacenamiento de forma acoplada. Cada nodo que contiene datos se ejecuta en una máquina virtual con almacenamiento conectado.
Características arquitectónicas
Las siguientes características describen cómo Atlas Core aprovisiona y escala los recursos:
Escalabilidad de cómputo por nivel de clúster: La capacidad de cómputo de un nodo se modifica seleccionando un nivel de clúster diferente. La capacidad de cómputo y la de almacenamiento están vinculadas en el mismo nodo, por lo que Atlas reinicia los nodos del clúster al cambiar de nivel. En clústeres dedicados, Atlas realiza un reinicio gradual sin tiempo de inactividad previsto.
Atlas proporciona almacenamiento por clúster: Atlas proporciona capacidad de almacenamiento para el clúster, y su aplicación puede utilizar esa capacidad en cualquier momento.
Los límites de almacenamiento dependen del nivel del clúster: en clústeres dedicados, la capacidad de almacenamiento y las IOPS de un nodo se escalan independientemente de su capacidad de procesamiento, hasta alcanzar la capacidad máxima de almacenamiento del nivel del clúster. Para añadir capacidad de almacenamiento más allá de ese máximo, se escala el clúster a un nivel superior.
La recuperación de nodos requiere una sincronización inicial: cuando Atlas reemplaza un nodo, el nuevo nodo realiza una sincronización inicial para copiar los datos de la aplicación desde los demás nodos antes de procesar las consultas.
Las cargas de trabajo grandes pueden requerir fragmentación: cuando los datos de su aplicación se acercan a la capacidad de procesamiento o almacenamiento de una sola partición, se fragmenta el clúster para escalar horizontalmente.
Las cargas de trabajo de análisis, búsqueda e inteligencia artificial se ejecutan en sistemas separados: cada tipo de carga de trabajo se ejecuta en su propio sistema con su propia copia de los datos.
Para obtener más información sobre seguridad, elasticidad, dimensionamiento, copias de seguridad, rendimiento y métricas en Atlas Core, consulte:
Acerca de esta documentación
La mayor parte de la documentación de Atlas se aplica tanto a Atlas Core como a Atlas Infinite, ya que la interfaz, los controladores, las API y la mayoría de los flujos de trabajo operativos de Atlas son los mismos en ambas ediciones. La documentación describe a qué ediciones se aplica cada página o sección, como se indica a continuación:
Aplicable a ambas ediciones: a menos que una página indique lo contrario, su contenido se aplica tanto a Atlas Core como a Atlas Infinite.
Aplicable a una sola edición: Cuando el contenido se aplica a una sola edición, la página identifica esa edición en su título o texto.
No compatible con Atlas Infinite: Cuando una función no está disponible en Atlas Infinite durante la vista previa pública, la página incluye una nota y enlaces a las funciones compatibles.
En Atlas Infinite, el comportamiento es diferente: cuando un flujo de trabajo o una opción difiere entre ediciones, la página o sección resalta la diferencia en el lugar indicado.