caso de uso: Artificial Intelligence, Content Management, Intelligent Search
Industrias: Manufactura
Productos: MongoDB Atlas Search, MongoDB Atlas Vector Search, Hybrid Search in MongoDB Atlas
Descripción general de la solución
The CMVR are the rules issued under India's Motor Vehicles Act. They set the technical and safety requirements a vehicle must meet before it can be manufactured, sold, or registered in the country. The AIS comprises the technical standards, developed and maintained by the ARAI. They specify how a vehicle or component must be tested to show it meets a given CMVR requirement. An OEM building a car for the Indian market uses these documents: the CMVR specifies what safety requirements the vehicle must satisfy, and the matching AIS establishes how that satisfaction gets tested and certified.
El contenido normativo y de estándares solo es valioso cuando las personas pueden encontrar el requisito correcto en el momento adecuado. Piense en un ingeniero de un proveedor de componentes que está terminando un conjunto de faros para un OEM indio. Antes de que la pieza vaya a ARAI para su certificación, el ingeniero debe confirmar la revisión actual de AIS-xyz y comprobar si la "regla abc" del CMVR se ha modificado desde la última presentación. Buscar esa cláusula en una carpeta de notificaciones del boletín oficial y PDF de estándares lleva horas, y citar una revisión obsoleta significa una certificación rechazada y un lanzamiento retrasado.
Esta solución describe una implementación de MongoDB para buscar contenido CMVR e IA, que:
Utiliza material de origen como el texto de las normas CMVR, las normas IA y las notificaciones de sus modificaciones.
Convierte este material en registros que se pueden buscar.
Recupera el documento o la sección relevante para una query de usuario.
Devuelve el contexto del resultado: el título, el número de sección o regla, el origen y la versión del documento.
La aplicación utiliza MongoDB Search para hacer coincidir una query con el texto de la regla y la sección, y devuelve el pasaje coincidente junto con su localizador de origen.
The same problem shows up anywhere a manufacturer sells into more than one market. A supplier shipping to Europe checks UNECE regulations, a supplier shipping to the United States checks FMVSS, and a supplier shipping to China checks the GB standards. Each regulatory body has its own amendment cycle, its own numbering, and its own effective dates. The pattern in this solution, preserving section, version, and source locator alongside searchable text, applies to these regulatory bodies.
Esta solución ayuda a los usuarios a localizar y verificar el material de origen que podría dar una respuesta a una pregunta específica del dominio. A un alto nivel, la solución utiliza el siguiente flujo de trabajo:
Ingesta: Lea el texto de la norma CMVR, las normas IA y las notificaciones del boletín oficial o las circulares ARAI que las modifican.
Preparar: Normalice cada fuente en un registro que contenga el número de documento, sección o regla, el número de enmienda, la fecha de entrada en vigor y los metadatos del localizador necesarios para rastrear un pasaje hasta su origen.
Recuperar: Aplicar la ruta de MongoDB Search, los filtros y la lógica de clasificación, respetando qué enmienda o revisión está actualmente en vigor.
Presente: Devuelve el contenido coincidente junto con su número de regla, identificador estándar, versión y contexto de origen, para que un ingeniero de cumplimiento pueda confirmar que está leyendo el texto actual.
Las consultas representativas que la aplicación gestiona incluyen un identificador estándar (como IA-xyz), un número de regla o abreviatura de CMVR, un requisito en lenguaje natural (como "cuál es el requisito del cinturón de seguridad trasero para vehículos de pasajeros") y una query restringida por categoría o fecha de modificación. Estas consultas concretan el vocabulario de búsqueda y dan al trabajo de evaluación un punto de partida.
Por qué la búsqueda de regulaciones y estándares es difícil
Las normas CMVR se modifican mediante notificaciones G.S.R. publicadas en la gaceta oficial, y una sola norma puede contener varias enmiendas superpuestas al texto original. Las normas IA pasan por su propio ciclo de revisión, seguido por ARAI con letras de revisión como IA-xyz Rev B. Un ingeniero de cumplimiento que busca por palabra clave no tiene una forma fiable de saber si el pasaje que encontró refleja la versión actual o una posterior. Presentar documentación contra una cláusula derogada puede activar una solicitud de homologación rechazada y retrasar el lanzamiento de un vehículo semanas. Añade el costo de una segunda ronda de certificación.
Terminology adds a second layer of difficulty. Engineers, suppliers, and regulators often refer to the same requirement in different words: a supplier might search for "headlamp beam pattern" while the standard itself uses "photometric requirements for dipped beam." A search built only on exact keyword matching misses these connections. Lexical search matches words, prefixes, or identifiers. Semantic search matches meaning through vector embeddings, numerical representations of text. By using these search methods together, a RAG pipeline can provide the right context to the LLM.
La misma dificultad aparece fuera del sector automotriz. Un suscriptor que revisa una reclamación de seguro de automóvil debe verificar qué estándar de pruebas de choque se aplicó cuando se fabricó un automóvil, ya que la revisión de la IA puede cambiar la cobertura de la póliza. Un OEM que vende en Europa, Estados Unidos y China al mismo tiempo necesita rastrear las revisiones de la UNECE, la FMVSS y la GB en paralelo, cada una con su propio historial de enmiendas y fechas de entrada en vigor. En todos los casos, el requisito subyacente es el mismo: conservar la sección, la versión y el localizador de origen junto con el texto que se puede buscar. Este patrón informa a los usuarios lo que dice el requisito y cuándo se aplica.
Arquitecturas de Referencia
La solución ayuda a los equipos de ingeniería, certificación y cumplimiento a encontrar contenido autorizado de CMVR e IA sin perder el contexto de revisión y origen necesario para validar un resultado. Utiliza un patrón de recuperación híbrido: la búsqueda léxica admite búsquedas de alta precisión de identificadores como un número de regla CMVR o un estándar de IA, mientras que la búsqueda vectorial muestra pasajes relevantes cuando un usuario describe un requisito en lenguaje sencillo.
Cada documento entrante se somete a un proceso de ingesta que analiza el texto hasta unidades granulares, como reglas específicas, secciones o fragmentos individuales. Durante la transformación, se anexan metadatos de procedencia y validez, que abarcan el ID de origen, el localizador exacto de la sección o cláusula, la categoría, la versión/revisión del documento, la fecha de entrada en vigor y el estado actual del ciclo de vida. MongoDB, a continuación, almacena e indexa tanto datos textuales para la búsqueda por palabras clave como incrustaciones vectoriales para la búsqueda semántica. Por último, el sistema fusiona candidatos de query léxicos y semánticos para generar y presentar un resultado clasificado y verificable basado en el material de origen.
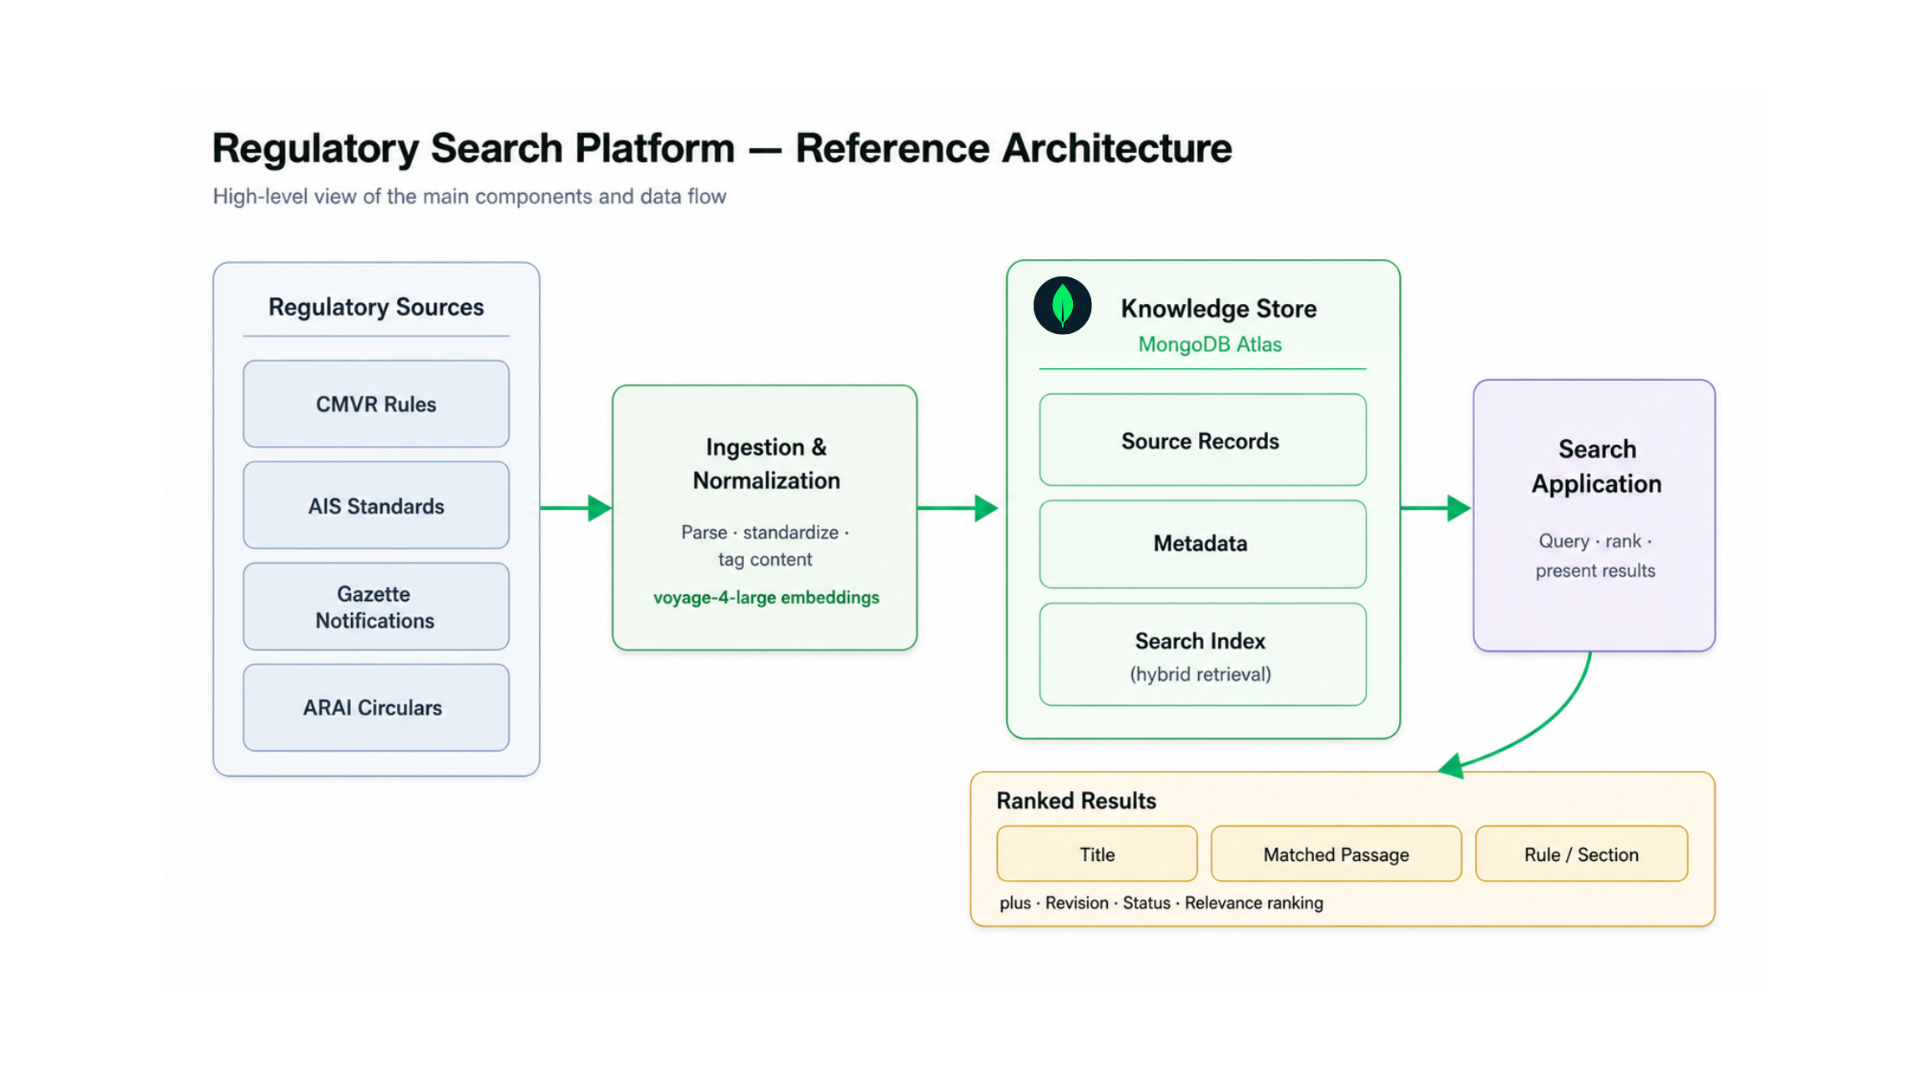
Figura 1. Diagrama de arquitectura de referencia integral
Una query como AIS-[standard identifier], un número de regla CMVR o “requisito de cinturón de seguridad trasero para vehículos de pasajeros” sigue la misma ruta de alto nivel:
La aplicación identifica los términos de búsqueda aplicables y los filtros opcionales, como la categoría, la revisión, la fecha de entrada en vigor o el estado activo.
MongoDB Search recupera coincidencias léxicas para identificadores exactos, abreviaturas y términos en el texto de origen.
MongoDB búsqueda vectorial recupera pasajes semánticamente similares para requisitos de lenguaje natural y variaciones de terminología.
La aplicación fusiona y clasifica los conjuntos de candidatos, aplica filtros de ciclo de vida y proyecta los campos de procedencia necesarios para la verificación.
La vista de resultados presenta el pasaje coincidente junto con su contexto de origen.
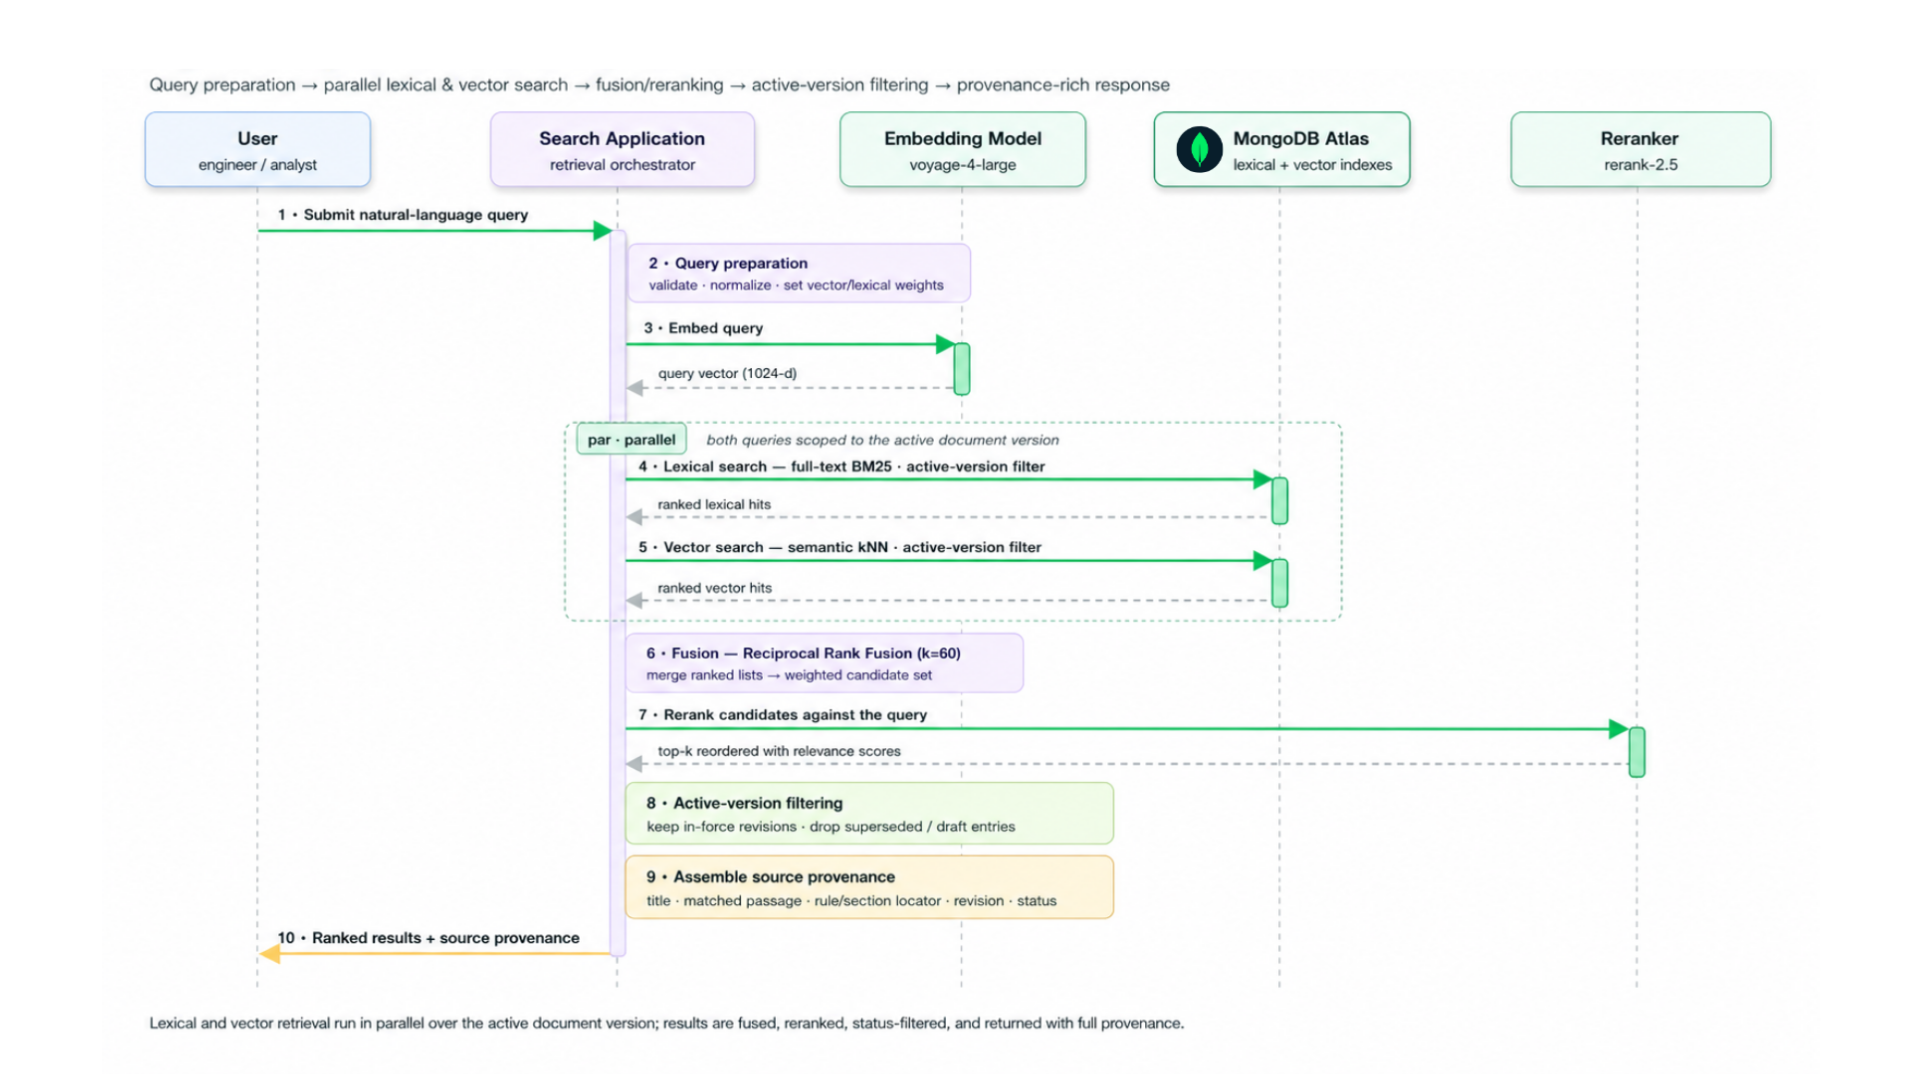
Figura 2. Diagrama de secuencia de recuperación híbrida
Enfoque de modelo de datos
Un registro que se pueda buscar debe contener tanto el texto que se recupera como el contexto que hace que ese texto sea verificable. Para un corpus normativo, la aplicación debe conservar la identidad del documento, la jerarquía de secciones o reglas, la revisión que se indexó y un localizador estable que remita al material original.
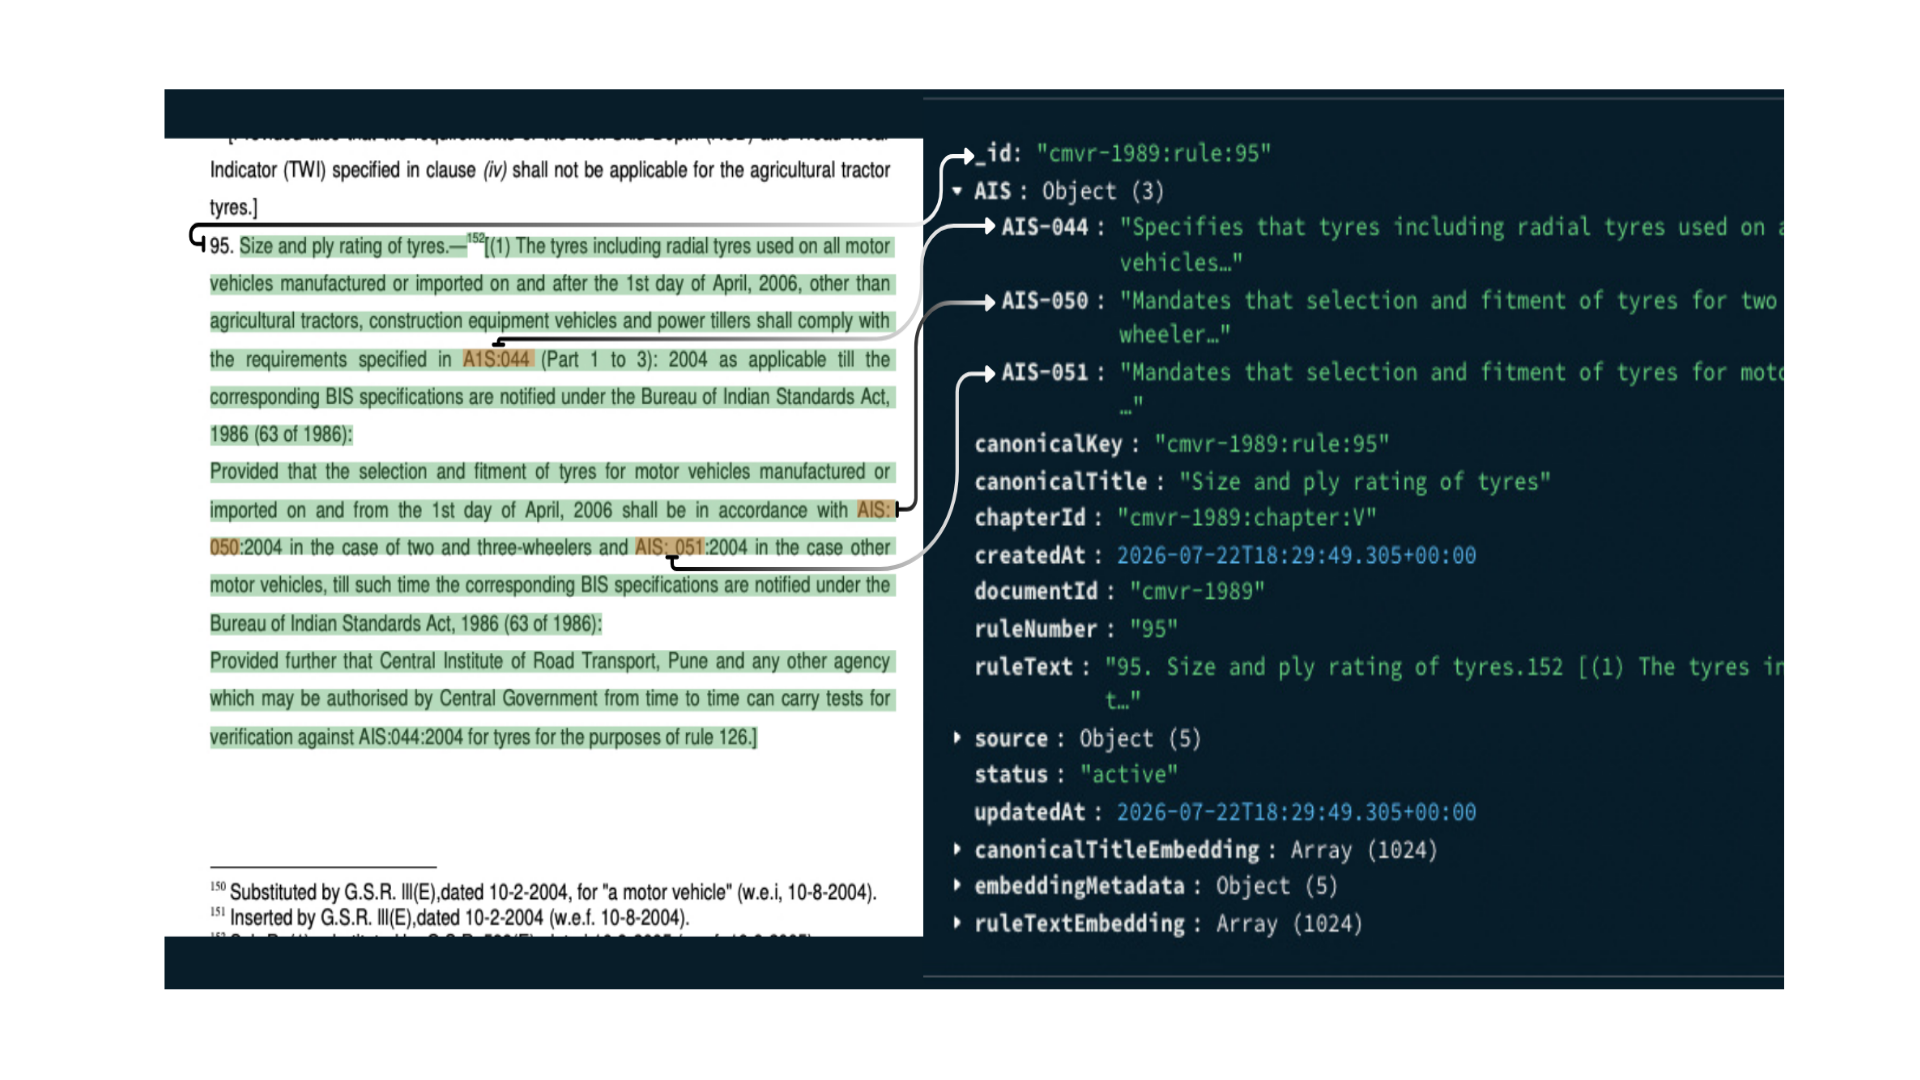
Figura 3. Visual de transformación de documento a registro
El siguiente es solo un esquema ilustrativo.
{ _id: '<documentId>:rule:<ruleNumber>', AIS: { 'AIS-XXX': 'Summary of what this standard requires.', 'AIS-YYY': 'Summary of another referenced standard.' }, canonicalKey: '<documentId>:rule:<ruleNumber>', canonicalTitle: '<Short descriptive title of the rule>', chapterId: '<documentId>:chapter:<chapterNumber>', createdAt: ISODate('<YYYY-MM-DDTHH:mm:ss.sssZ>'), documentId: '<documentId>', ruleNumber: '<ruleNumber>', ruleText: '<Full rule text, including sub-rules, provisos, tables and footnotes>', source: { documentName: '<Official title of the source document>', pdfFile: '<source-file>.pdf', pages: [], chunkCount: NumberInt('<numberOfChunksExtracted>'), extractionModel: '<extraction-model-name>' }, status: 'active', updatedAt: ISODate('<YYYY-MM-DDTHH:mm:ss.sssZ>'), ruleTextEmbedding: [/* float[<dimensions>] */] }
El campo ruleText contiene el pasaje normativo primario, mientras que canonicalTitle y ruleNumber permiten la verificación rápida del requisito. Los metadatos estructurales, incluidos documentId y chapterId, mantienen la relación entre un registro específico y la jerarquía de capítulos principal. El objeto source proporciona la procedencia necesaria para la trazabilidad al PDF original, los números de página y el modelo de extracción. Para el contexto específico de los estándares, el objeto IA captura referencias cruzadas y resúmenes de los requisitos vinculados. El ciclo de vida del registro se sigue a través de status, createdAt y updatedAt. Por último, el ruleTextEmbedding y los campos de metadatos asociados almacenan las representaciones vectoriales numéricas y los detalles del modelo que impulsan la recuperación semántica.
Compilar la solución
This section describes the build flow for the hybrid-search implementation. Access the full source code in the GitHub repository.
Preparar el corpus de origen
Recopile el texto de la regla CMVR, las normas IA y las notificaciones o circulares que cambian su aplicabilidad. Para cada fuente, capture el archivo original o la URL, el tipo de documento, el identificador, la revisión, la fecha de publicación, la fecha de entrada en vigor y el estado actual del ciclo de vida.
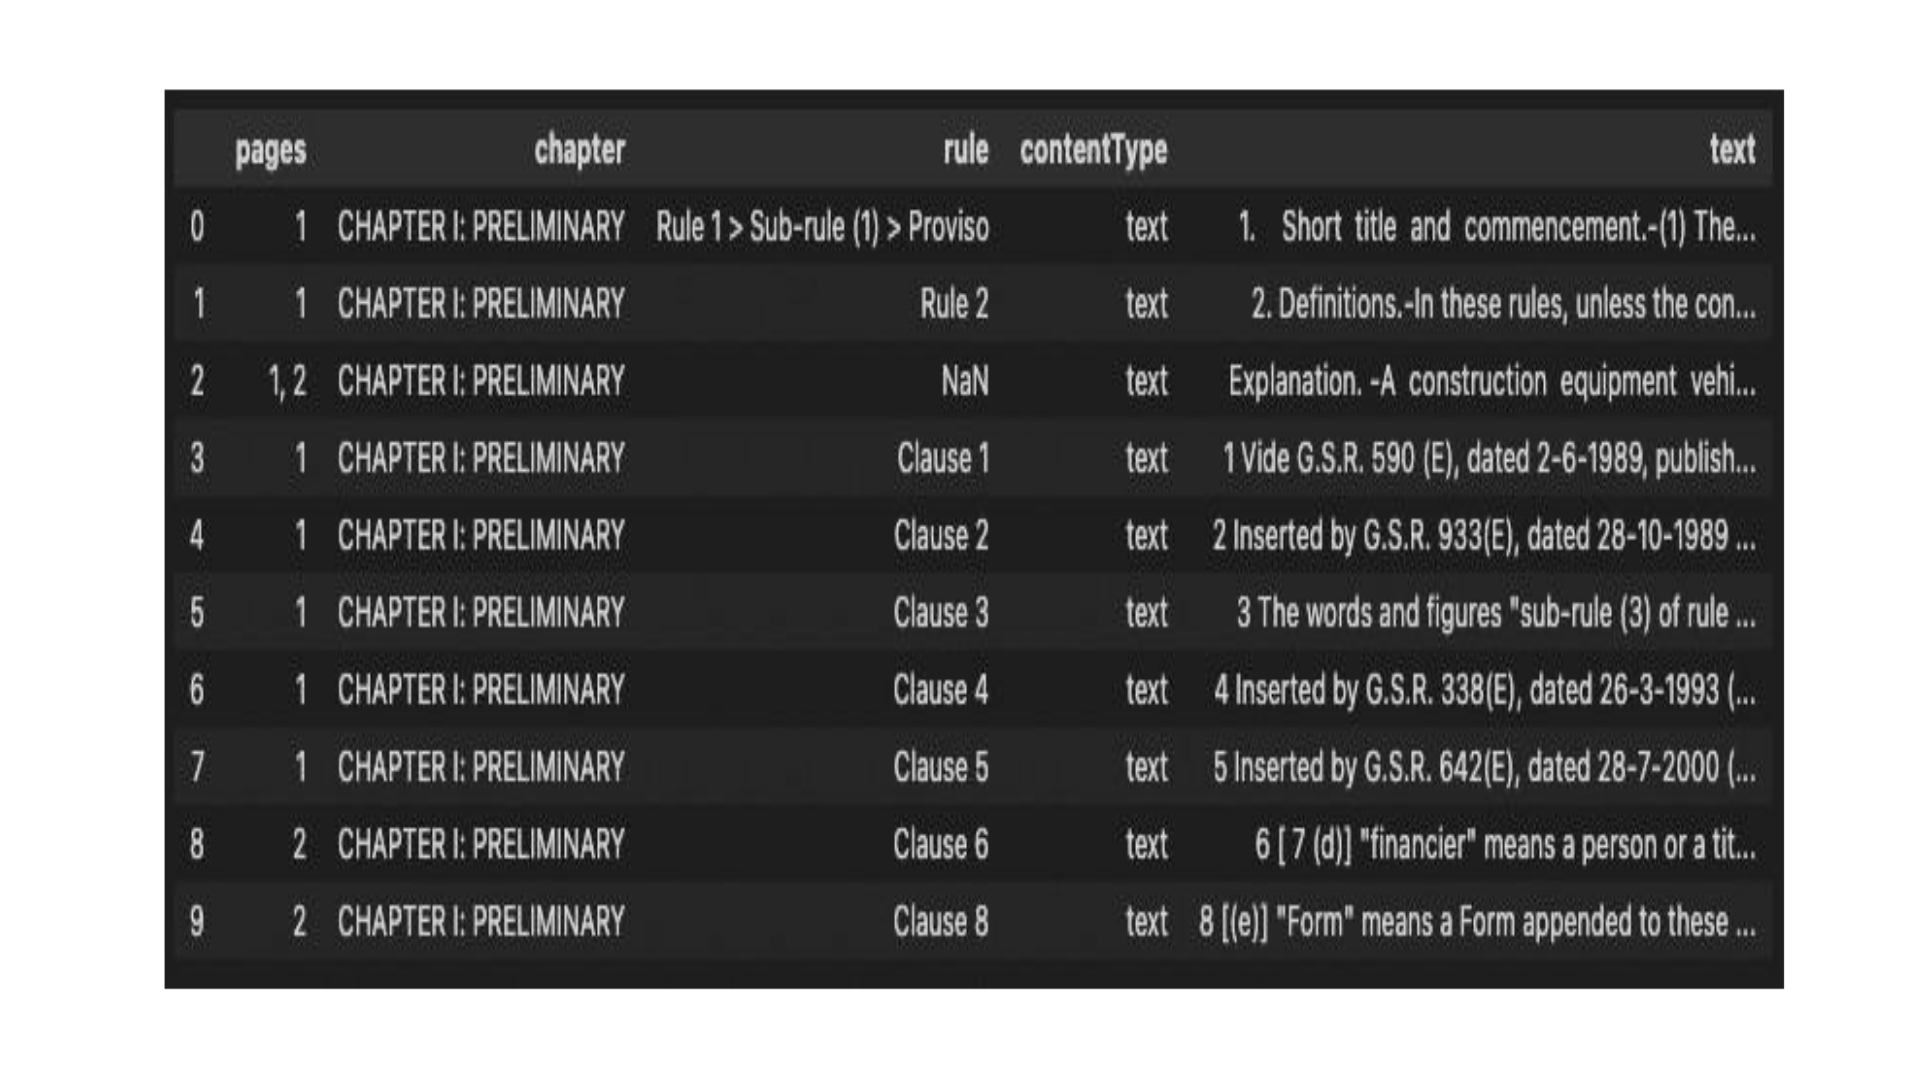
Figura 4. Información del corpus fuente
Normalizar documentos en registros de búsqueda
Extraiga texto a nivel de regla o sección, conservando la jerarquía necesaria para identificar un resultado en la fuente original. Cree registros que emparejen el contenido buscable con la procedencia, el ciclo de vida del documento y los metadatos de filtro.
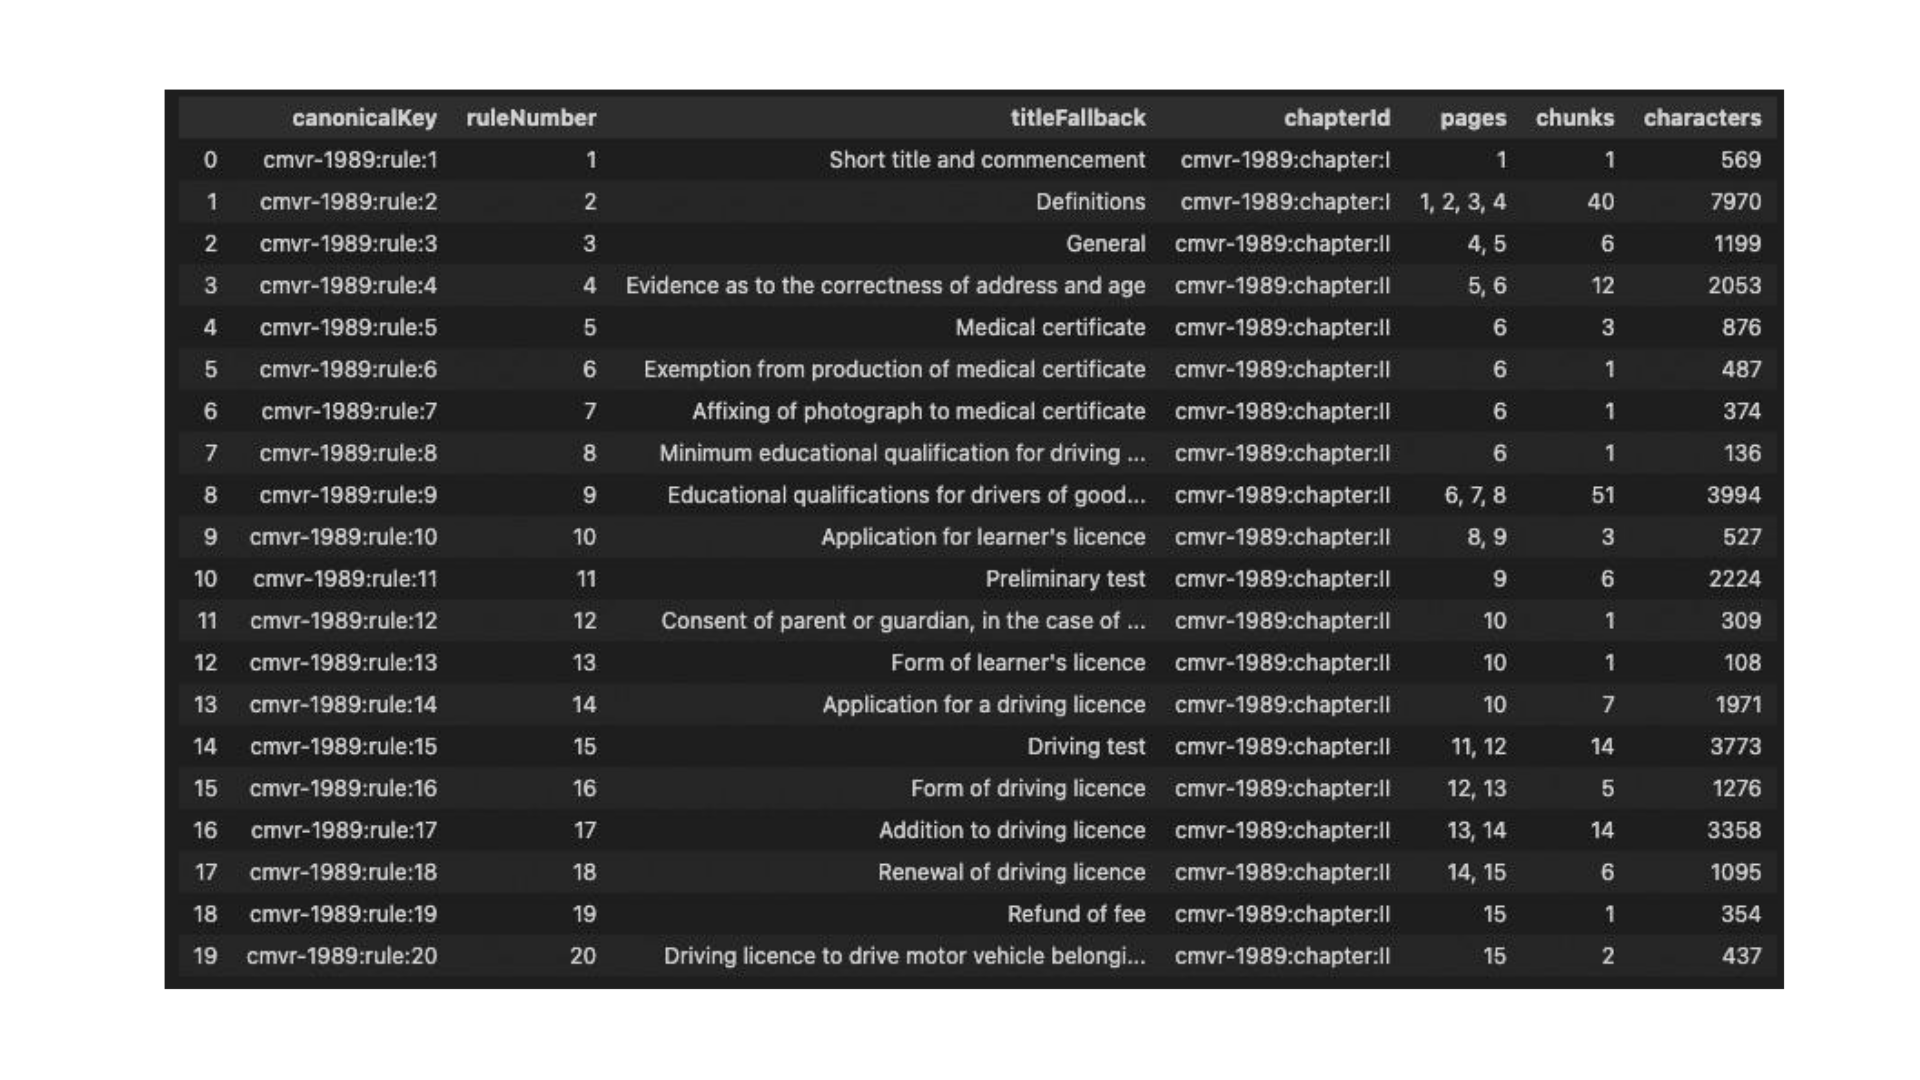
Figura 5. Estructura del esquema de documentos de IA
Crear los índices de búsqueda híbrida
Cree un índice de MongoDB Search para identificadores exactos y coincidencia textual, y un índice de MongoDB búsqueda vectorial para el campo de incrustación. Defina asignaciones, analizadores, filtros, dimensiones vectoriales y métricas de similitud a partir de la implementación verificada.
índice de búsqueda
{ mappings: { dynamic: false, fields: { canonicalTitle: { type: "string", analyzer: "lucene.english" }, ruleText: { type: "string", analyzer: "lucene.english" }, documentId: { type: "token" } } } }
Índice de búsqueda vectorial
{ fields: [ { type: "vector", path: "ruleTextEmbedding", numDimensions: 1024, similarity: "cosine" }, { type: "filter", path: "documentId" } ] }
Ejecutar recuperación léxica y semántica
Para una query de usuario, recuperar candidatos de palabras clave y candidatos de vectores, luego combinarlos con la lógica de fusión o reclasificación verificada de la aplicación. Aplicar filtros de categoría, estado, revisión o fecha de vigencia antes de devolver resultados para que un pasaje obsoleto no se represente como actual.
Devuelve resultados con procedencia
Presente el texto coincidente con el título, la referencia de la regla o sección, el localizador de origen, la revisión, la fecha de entrada en vigor y el estado del ciclo de vida. Una puntuación de relevancia puede ayudar a clasificar a los candidatos, pero no establece el cumplimiento normativo ni la corrección legal. El usuario debe poder inspeccionar el material de origen original.
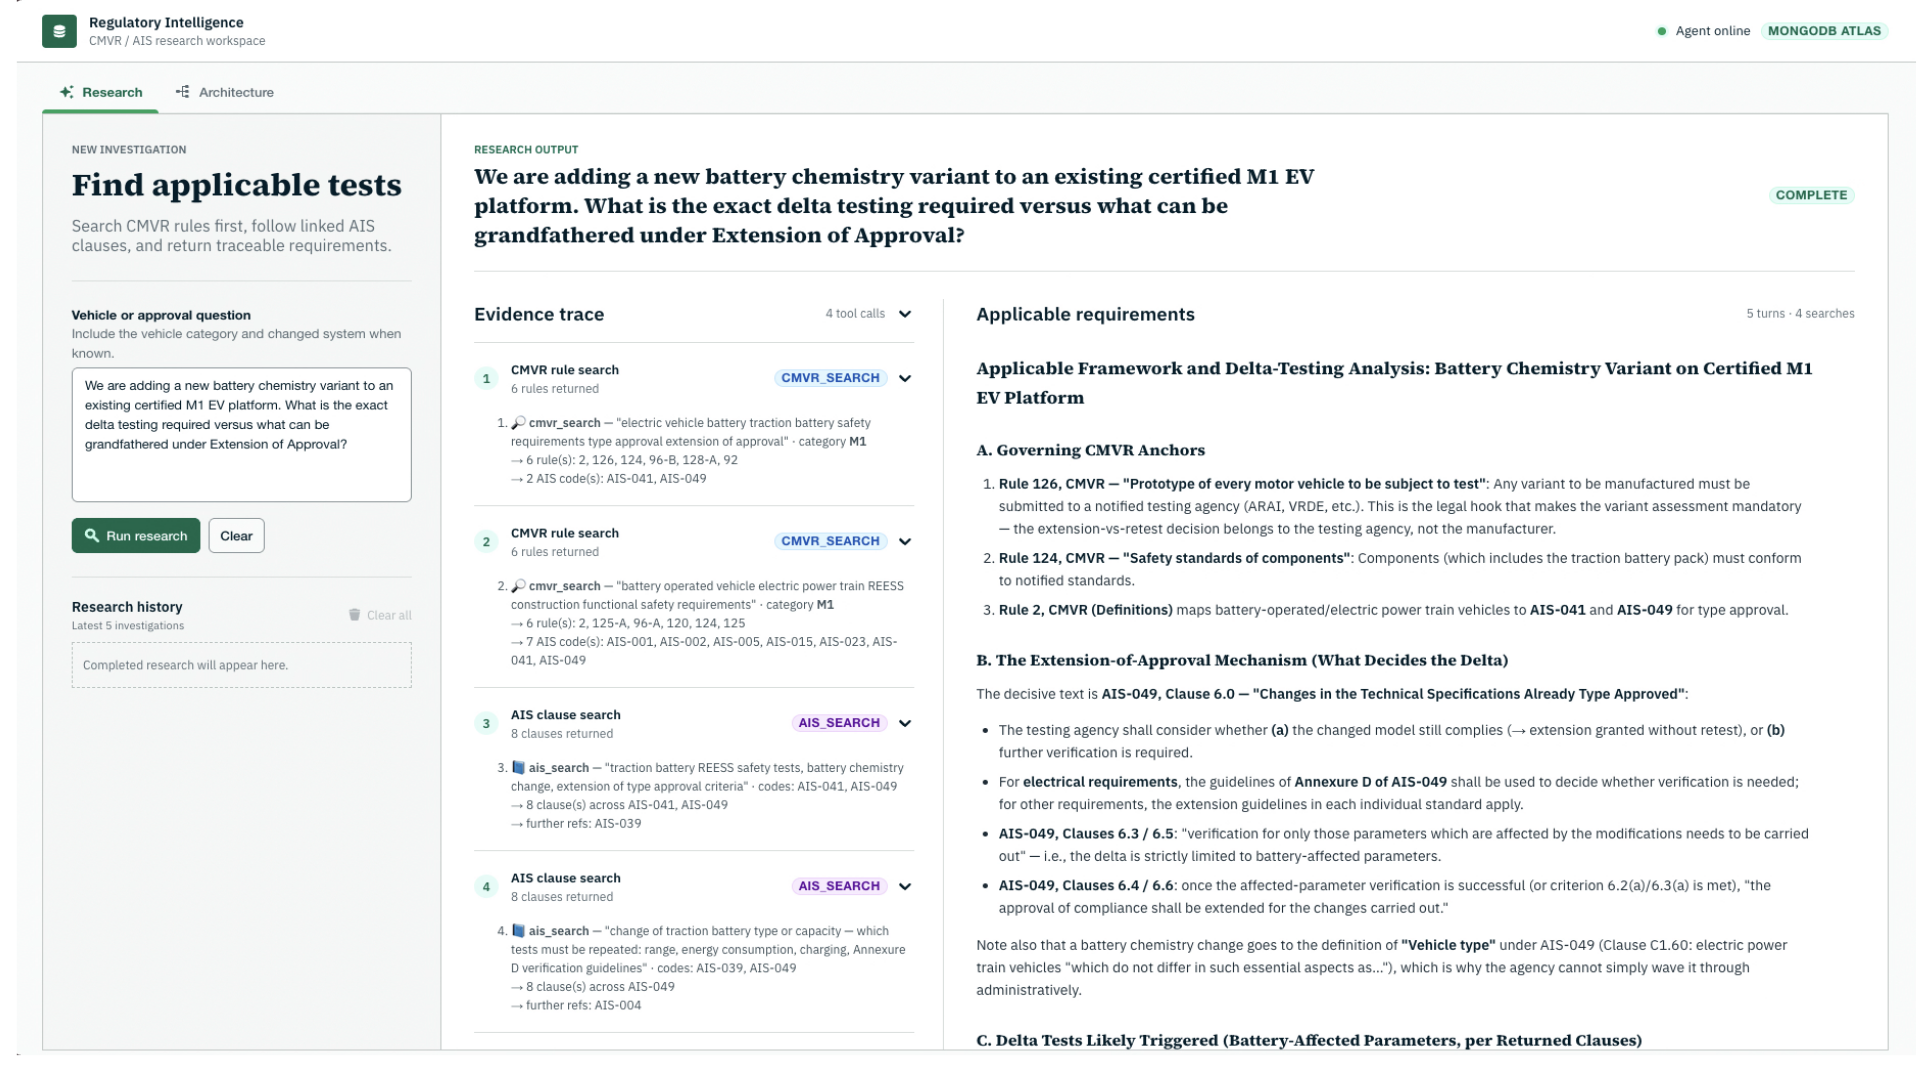
Figura 6. Captura de pantalla de la Interfaz de Usuario que muestra una query
Evaluar la calidad de recuperación y el ciclo de vida del documento
Compilar un conjunto de evaluación etiquetado que contenga búsquedas de identificadores, abreviaturas, sinónimos, requisitos de lenguaje natural, query sensibles a revisiones y casos sin resultados.
Cuando se modifica, retira o sustituye un documento, actualice sus metadatos de ciclo de vida y haga visible ese estado en los resultados de búsqueda. El sistema debe admitir la verificación de origen; no debe posicionarse como asesoramiento legal, normativo o de cumplimiento.
Lecciones clave
La búsqueda regulatoria especializada requiere más que la coincidencia de texto: La combinación de recuperación léxica y semántica sirve para identificadores estándar exactos y el lenguaje variado que los usuarios aplican al mismo requisito.
La procedencia es un requisito del producto: Cada pasaje recuperado debe conservar un identificador de origen estable, un localizador, una revisión del documento y un estado del ciclo de vida para que los usuarios puedan validar el material subyacente.
La revisión de documentos forma parte de la relevancia: Una cláusula relevante pero sustituida no debe presentarse como el requisito actual.
La búsqueda híbrida debe evaluarse en función de query de usuario representativas: Los recuentos de candidatos, los límites de resultados, las ponderaciones de fusión y los objetivos de latencia deben seleccionarse de la carga de trabajo real en lugar de copiarse por defecto.
Una experiencia de búsqueda basada en fuentes agiliza la verificación: Esta experiencia mejorada ayuda a los usuarios a localizar y verificar material más rápido; no realiza por sí misma una determinación de cumplimiento.
Autores
Utsav Talwar, Arquitecto de Soluciones, MongoDB
Humza Akhtar, CTO de campo, Industria manufacturera, MongoDB