Capture el inventario de los estantes a partir de una fotografía, almacénelo en MongoDB y sincronice las actualizaciones entre los clientes minoristas conectados y fuera de línea.
caso de uso: Edge y dispositivos móviles, inteligencia artificial
Industrias: Edge y móvil, comercio minorista
Productos: MongoDB Enterprise Advanced
emparejar: PowerSync
Descripción general de la solución
Los minoristas necesitan tener una visibilidad precisa del inventario en los estantes. En grandes instalaciones, los equipos suelen trabajar en áreas con conectividad inconsistente y dependen de comprobaciones manuales para identificar los productos que necesitan ser repuestos.
Aprende a convertir una sola imagen de estante en un registro de inventario estructurado. Un modelo de lenguaje de visión identifica y cuenta los productos, mientras que MongoDB Enterprise Advanced almacena las imágenes capturadas, el recuento de artículos y el contexto de la aplicación.
MongoDB proporciona la base para distribuir el estado del inventario en toda la red. Los flujos de cambios envían actualizaciones en tiempo real a PowerSync, que sincroniza los campos seleccionados con las bases de datos SQLite locales en los dispositivos cliente. Cuando se pierde la conectividad, los dispositivos cliente siguen trabajando sin conexión con los datos locales y se sincronizan al restablecerse la conexión.
Este flujo de trabajo centrado en MongoDB integra a la perfección la captura de imágenes, el modelado flexible de documentos y las aplicaciones de venta minorista sincronizadas. Transforma las observaciones de los estantes en datos de inventario que los equipos pueden utilizar en todas las aplicaciones de los clientes.
Arquitecturas de Referencia
MongoDB Enterprise Advanced funciona como la capa de datos operativos y la fuente de información fidedigna para el inventario en estanterías.
El navegador envía una imagen del estante a la aplicación de backend. El backend pasa la imagen al modelo de lenguaje de visión configurado, valida la respuesta estructurada y escribe el documento de inventario resultante en MongoDB.
Cada documento almacena el contexto de captura junto con los elementos detectados. MongoDB almacena metadatos como la hora de captura, el dispositivo, el operador, la tienda, el modelo, el recuento de elementos, los valores de confianza y el estado del ciclo de vida.
Al habilitar la persistencia de medios, el backend almacena la imagen original en un sistema de almacenamiento de objetos compatible con Amazon S3 y guarda la referencia del recurso en MongoDB. Este diseño separa los objetos multimedia de gran tamaño de los registros de inventario operativos, preservando al mismo tiempo sus relaciones.
Los flujos de cambios de MongoDB publican eventos que PowerSync utiliza para sincronizar los campos de inventario seleccionados con las bases de datos SQLite del cliente. PowerSync admite el acceso y la sincronización de aplicaciones locales incluso en caso de interrupciones de conectividad, mientras que MongoDB sigue siendo la fuente de información principal.
Esta arquitectura separa las responsabilidades al tiempo que mantiene una base de datos unificada:
MongoDB gestiona el registro de inventario operativo.
El sistema de backend controla las operaciones de escritura.
El modelo de visión-lenguaje (VLM) extrae datos estructurados.
El almacenamiento de objetos conserva las imágenes sin procesar.
PowerSync distribuye el estado respaldado por MongoDB a los clientes.
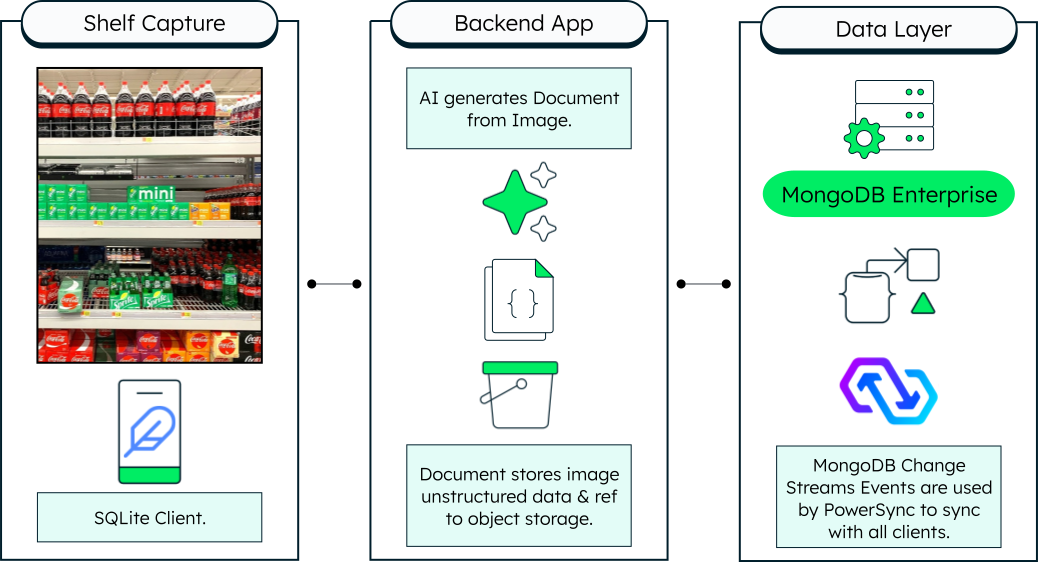
Figura 1. De la imagen del estante al inventario sincronizado: El sistema backend utiliza un modelo de lenguaje de visión para crear un documento de inventario en MongoDB. MongoDB almacena el registro operativo, el almacenamiento de objetos conserva la imagen original y los flujos de cambios impulsan la sincronización de PowerSync con SQLite del lado del cliente.
Enfoque de modelo de datos
Almacene cada captura de estante como un documento en la colección inventory_captures. Mantenga juntos el contexto de la captura y el resultado del inventario generado por el modelo para que su aplicación procese y sincronice cada captura como una sola unidad.
El documento registra metadatos que incluyen:
Captura la marca de tiempo y la ubicación.
Dispositivo y operador que realizan la presentación
Modelo utilizado para el análisis de imágenes
El estado del ciclo de vida de la captura
Incruste los productos detectados en el array items. Cada elemento contiene un nombre de producto, un recuento detectado y un nivel de confianza del modelo:
{ "_id": "108d020b-9d3c-4b36-a651-0e1be2b1e899", "captured_at": "2026-07-02T17:45:08.661249+00:00", "device_id": "web-o0its21v", "operator_id": "demo-operator", "store_id": "store-unknown", "cv_model": "qwen2.5", "items": [ { "name": "Nissin Cup Noodles", "count": 5, "confidence": 0.9 }, { "name": "Popcorn Bag", "count": 1, "confidence": 0.9 }, { "name": "Lays Chips", "count": 3, "confidence": 0.9 } ], "status": "ACTIVE", "asset": null }
La integración de los elementos detectados mantiene la salida del modelo lo más cercana posible a la captura del estante que la generó. El modelo de documento flexible de MongoDB permite que la aplicación conserve atributos adicionales de los elementos a medida que el modelo evoluciona, eliminando la necesidad de un esquema rígido para cada producto posible.
MongoDB sigue siendo la fuente de información principal para el registro de inventario. PowerSync proyecta los campos requeridos por las aplicaciones cliente en bases de datos SQLite locales, mientras que las imágenes sin procesar permanecen en el almacenamiento de objetos compatible con Amazon S3 cuando se habilita la persistencia de medios.
Explicaciones de campo
_id: Identificador único para la captura del estante.captured_at: Marca de tiempo UTC generada cuando el backend recibe la captura.device_id: Identificador del dispositivo cliente que envió la imagen.operator_id: Identificador del operador que envió la captura.store_id: Identificador del almacén asociado a la captura.cv_model: Nombre del modelo utilizado para generar el resultado del inventario.items: Matriz incrustada que contiene los productos detectados, los recuentos y los valores de confianza.status: Estado del ciclo de vida de la captura. Cuando el almacenamiento está habilitado, el flujo comienza comoPENDING_UPLOADy cambia aACTIVEdespués de que se cargan las imágenes sin procesar.asset: Metadatos opcionales de almacenamiento de objetos. Este campo esnullcuando el almacenamiento de imágenes sin procesar está deshabilitado.
Compilar la solución
Utilice el repositorio de GitHub retail-stock-take para implementar y explorar la solución.
Requisitos previos
Prepare un entorno local de Kubernetes con recursos suficientes para ejecutar:
MongoDB Enterprise Server administrado por MongoDB Ops Manager
PowerSync
backend de FastAPI
Aplicación web Next.js
Almacenamiento de objetos compatible con Amazon S3
Ollama y el modelo de lenguaje de visión configurado
Consulte la guía de configuración local en el repositorio para obtener información sobre las versiones de entorno de ejecución compatibles, los requisitos de memoria, los requisitos del modelo y el tiempo de configuración previsto.
Implementar la solución
Ejecutar el flujo de trabajo de configuración:
./scripts/setup.sh
Una vez finalizada la implementación, verifique que los siguientes servicios estén disponibles:
MongoDB Enterprise Advanced
MongoDB Ops Manager
PowerSync
Aplicación web Next.js
backend de FastAPI
Almacenamiento de objetos compatible con Amazon S3
Ejecutar el modelo de lenguaje de visión
Inicie el entorno de ejecución local de Ollama y descargue el modelo utilizado por la solución:
./scripts/pull-models.sh
Confirme que el modelo esté disponible antes de probar la captura de imágenes. El modelo analiza la imagen del estante y devuelve datos de inventario estructurados.
Capturar y verificar el inventario
Abre la aplicación web y envía una imagen de un estante. El sistema backend envía la imagen al modelo de lenguaje de visión, valida la respuesta estructurada y guarda el documento de inventario en MongoDB.
Al habilitar la persistencia de medios, el backend almacena la imagen original en un almacenamiento de objetos compatible con Amazon S3 y actualiza el estado del documento de MongoDB. Los flujos de cambios de MongoDB impulsan la sincronización de PowerSync con la aplicación cliente.
Ejecute el flujo de trabajo de verificación para validar la ruta completa de captura, almacenamiento y sincronización:
./scripts/verify.sh
MongoDB actúa como la capa de datos central en todo el flujo de trabajo. El repositorio documenta:
Componentes de despliegue y scripts de configuración
Procesamiento del modelo visión-lenguaje
Flujo de trabajo de almacenamiento de objetos
Ruta de sincronización
Lecciones clave
Capture el inventario de los estantes a partir de una imagen: utilice un modelo de lenguaje de visión para convertir una fotografía de un estante en un JSON estructurado que MongoDB almacena y que su aplicación procesa.
Modela los datos de inventario como documentos de MongoDB: Mantén juntos los metadatos de captura y los artículos detectados, de modo que cada documento represente una única comprobación de estante.
Sincroniza el estado respaldado por MongoDB en todos los dispositivos cliente: utiliza flujos de cambios de MongoDB y PowerSync para distribuir campos de inventario seleccionados sin necesidad de crear lógica de sondeo personalizada.
Separe los datos operativos de los medios sin procesar: almacene los datos de inventario y las referencias de imágenes en MongoDB, mientras que almacene el fotograma sin procesar en el almacenamiento de objetos compatible con Amazon S3 cuando habilite la persistencia de medios.
Compatibilidad con flujos de trabajo de venta minorista sin conexión: Permite que las aplicaciones cliente utilicen datos sincronizados localmente y concilien su estado al volver a conectarse.
Autores
Timothy Marland, MongoDB
Alberto Camarena Rodriguez, MongoDB
Daniel Jamir, MongoDB