Las decisiones de suscripción, reclamaciones y servicio en los seguros dependen del contexto que suele estar disperso en muchos sistemas diferentes, incluidos los sistemas de administración de pólizas, las plataformas de reclamaciones, la telemática y los datos de riesgo de terceros, entre otros. Reunir ese contexto manualmente cada vez es lento, inconsistente y difícil de auditar.
Esta arquitectura describe una capa de contexto en MongoDB Atlas, que es un nivel de datos operativos en tiempo real que ensambla el contexto de los objetos de negocio en un único objeto activo que los agentes y las aplicaciones pueden leer, guardar y actuar.
La capa de contexto se encuentra entre los sistemas de registro existentes y los flujos de trabajo de suscripción, reclamaciones y servicio impulsados por IA, por lo que las aseguradoras no necesitan reemplazar esos sistemas para que los agentes puedan utilizarlos. Combina un modelo orientado a documentos flexible, recuperación nativa de IA, propagación de cambios en tiempo real y gobernanza a nivel de campo para cumplir los requisitos de baja latencia y auditabilidad que exigen los bucles de decisión regulados y aumentados por agentes.
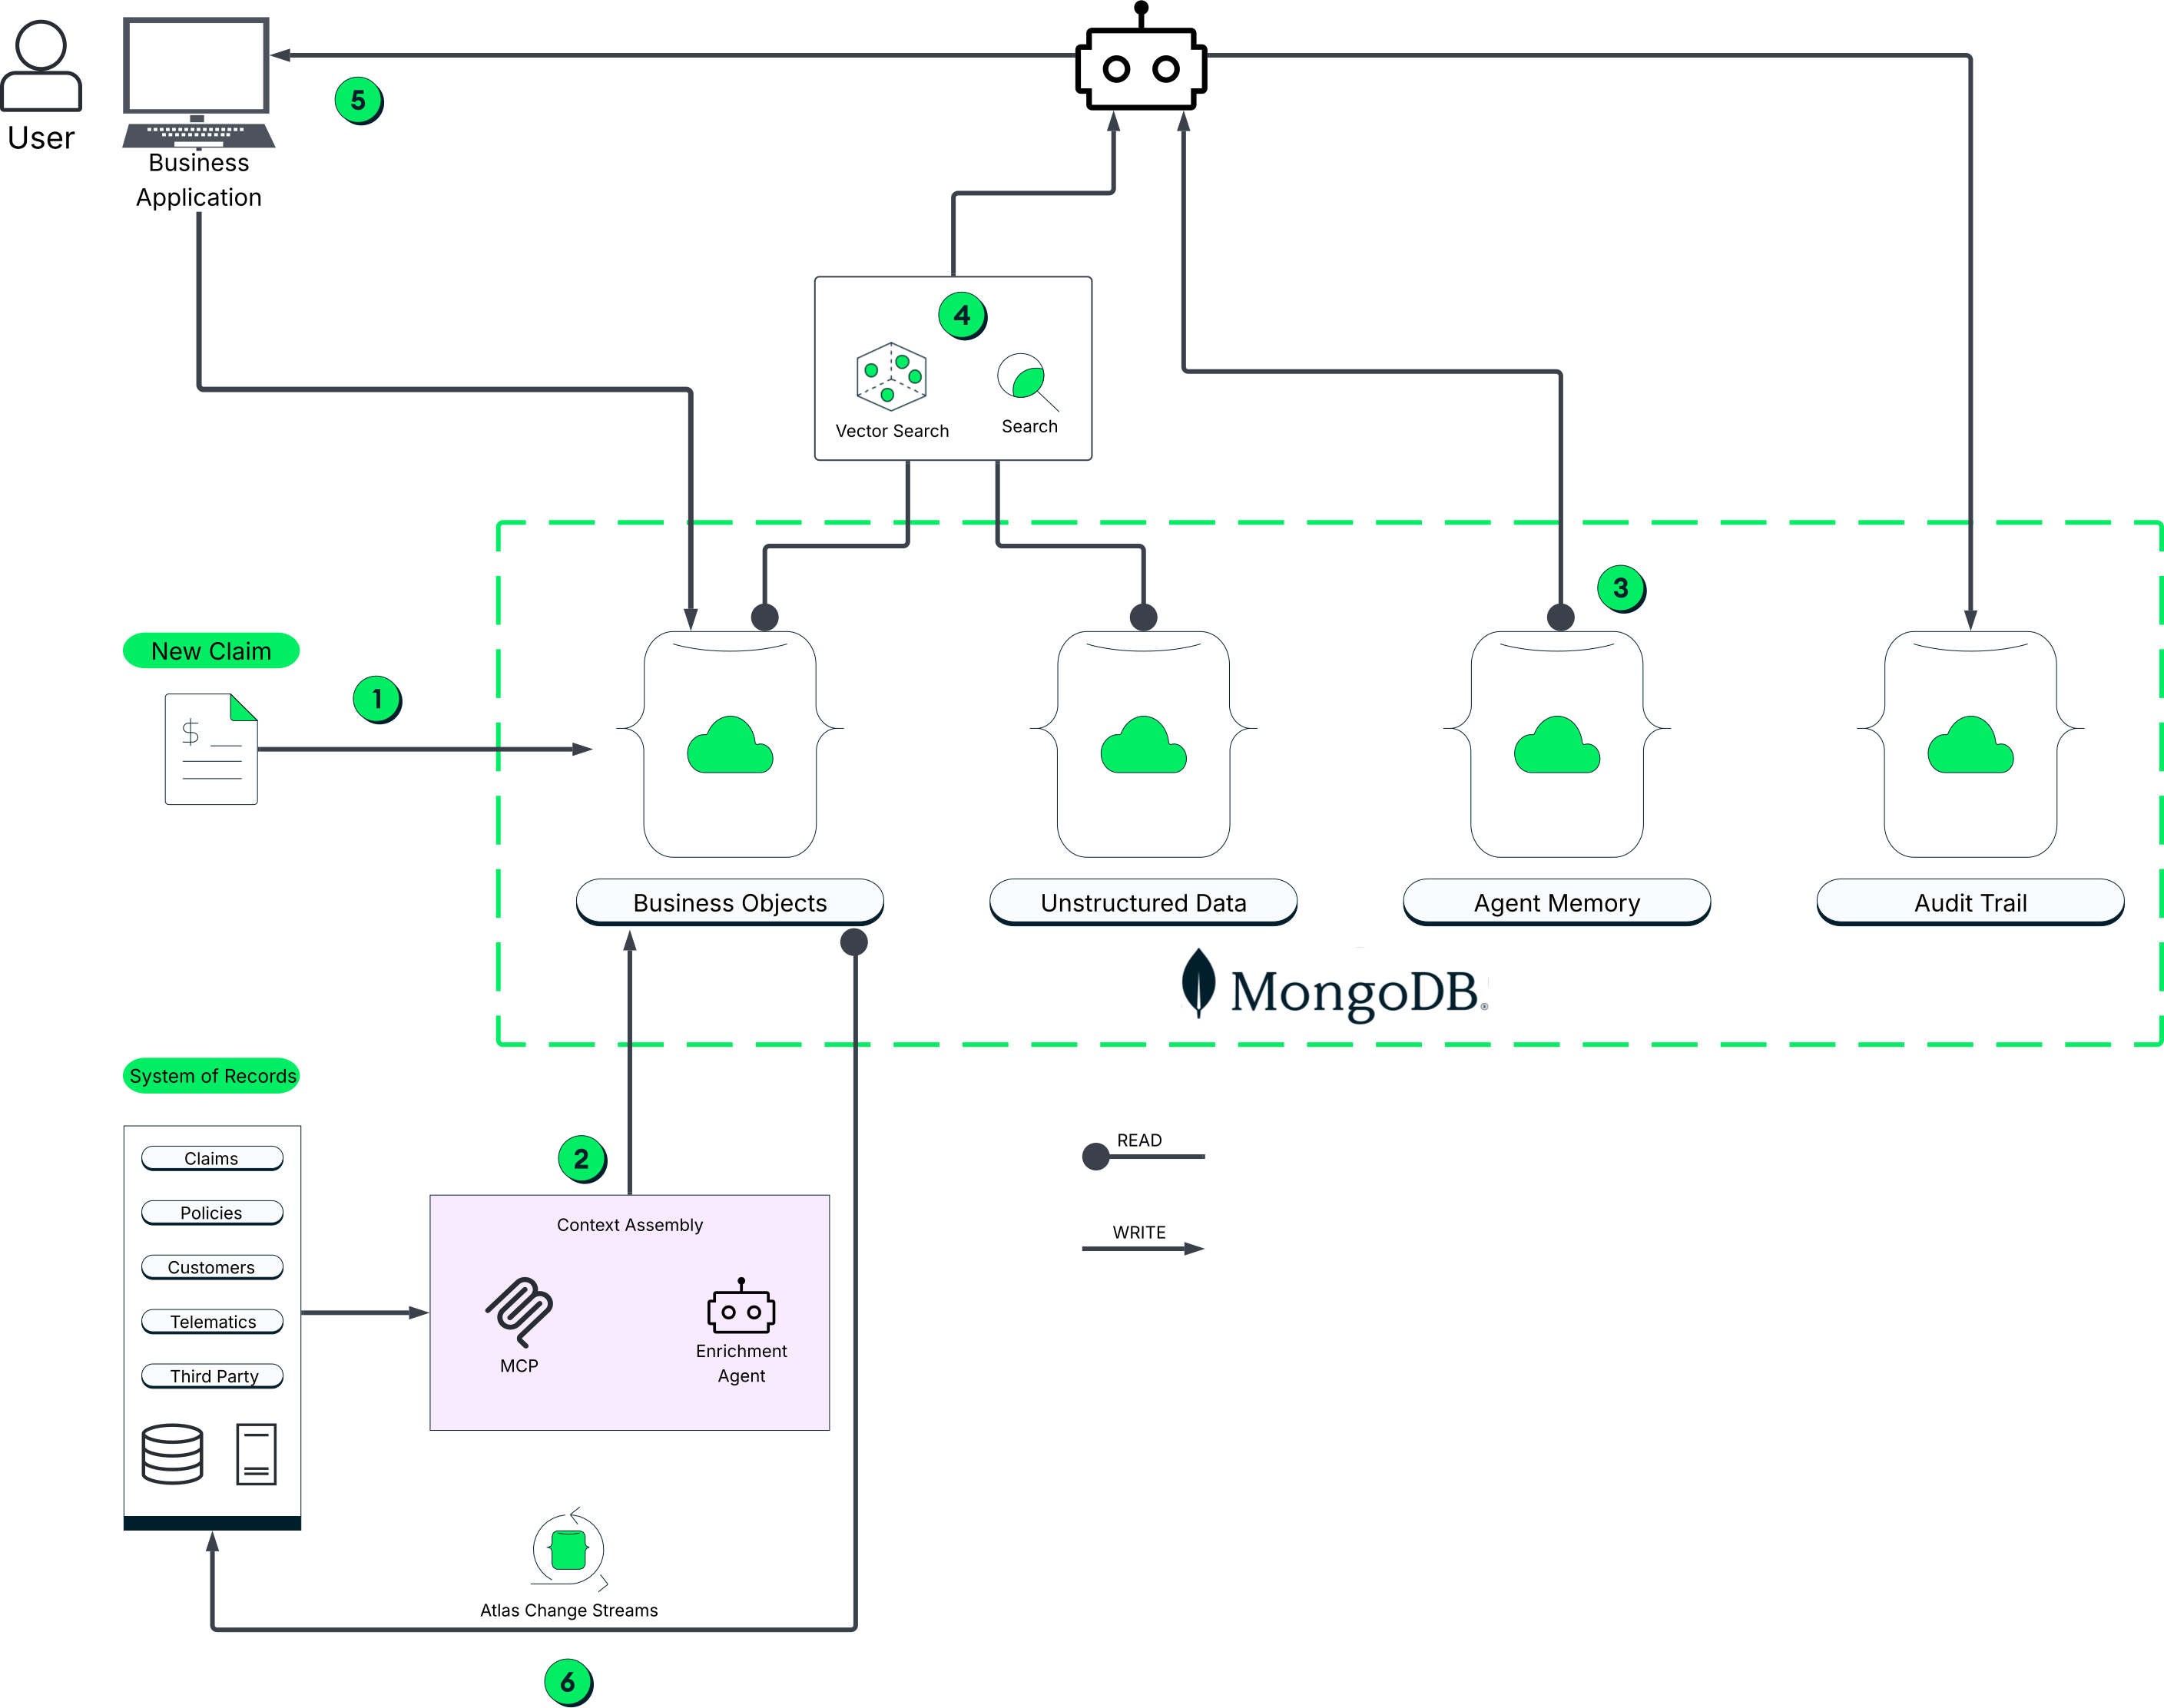
Figura 1. Arquitectura de la capa de contexto y flujo de datos del agente de IA
Flujo de datos
Los siguientes pasos rastrean una única presentación o reclamación a medida que se mueve a través de la capa de contexto, desde la recepción hasta una decisión registrada y auditable.
Recepción de envíos o reclamaciones
Llega una nueva solicitud o reclamación y el servicio de admisión captura los identificadores principales y los campos estructurados iniciales. Una vez identificada esa información, el servicio de ingesta los guarda en una colección
business_objectsen MongoDB Atlas como un único documento.Enriquecimiento y ensamblaje de contexto
Un agente de enriquecimiento especializado recopila el contexto restante que necesita el suscriptor o el gestor de reclamaciones, como los límites de cobertura, los endosos, las descripciones de pérdidas, las notas del perito y más. El agente reúne datos del sistema de registros para crear un único registro en tiempo real. Ahora, un único documento de MongoDB contiene todo lo que un suscriptor o agente de reclamaciones necesita para recopilar información, tomar una decisión y tomar acción.
Memoria del agente y recuperación de estado
Al mismo tiempo que el enriquecimiento del contexto, el servicio también recupera la memoria previa para este envío o reclamación, ya que la memoria agéntica contiene el historial de conversaciones, los rastros de decisiones, el historial de auditoría y el sentimiento para este caso específico. Esto permite que un agente de suscripción o de reclamaciones reanude el trabajo con la memoria completa de los turnos anteriores, las recomendaciones y las anulaciones humanas.
Recuperación nativa de IA sobre contenido estructurado y no estructurado
El servicio emite query híbridas
$vectorSearchy$searchcontra el objeto de negocio y artefactos no estructurados vinculados, como notas del ajustador, narrativas de pérdidas o metadatos de imágenes. Para ello, se pueden utilizar incrustaciones adaptadas al dominio y reclasificación, para que el agente vea primero el historial y los precedentes más relevantes en lugar de una lista bruta de coincidencias.Decisión del agente, el humano en el bucle y guardar de retorno
El agente realiza una revisión del contexto recopilado y realiza una acción, como emitir un presupuesto o presentar una solicitud de más información. En muchas situaciones, esta acción deberá ser revisada por el humano, manteniendo la revisión final siempre bajo control humano. Finalmente, el agente vuelve a escribir la decisión, junto con su rastro de razonamiento completo, en su propia colección de rastros de decisión en MongoDB como una entrada para auditar inmutable para garantizar el cumplimiento total, la trazabilidad y la transparencia sobre las acciones del agente.
Propagación en tiempo real con Change Streams
MongoDB Change Streams transmite actualizar a cada agente, tablero y sistema posterior que está monitoreando la presentación o reclamación. Además, el usuario humano puede introducir nuevas señales en cualquier punto, para que puedan utilizarse para activar agentes directamente, como un nuevo indicador de fraude en una reclamación que active al agente de reclamaciones de inmediato, sin un ciclo de agrupación.
Componentes
Sistemas de registro
Un sistema de registro (SoR), también conocido como sistema único de registro (SSoR), es un sistema informático único que sirve como fuente de datos autorizada para un elemento de datos crítico o un objeto de datos. El SoR contiene el "estado real" de los datos, lo que significa que es la versión más actualizada, precisa y compatible disponible para esa fuente de datos en particular.
En esta arquitectura, los sistemas de registro siguen siendo la fuente de las transacciones comerciales. Siguen manteniendo sus responsabilidades originales mientras la capa de contexto ensambla un contexto de decisión utilizable entre ellas.
Objetos de negocio y memoria del agente
Los objetos de negocio contienen la entidad operativa, ya sea un envío, una reclamación o un registro de cliente, como un único documento enriquecido continuamente. Esto garantiza que cada consumidor trabaje con la misma vista actualizada, en lugar de tener que recopilar la información de fuentes dispersas. MongoDB almacena la memoria del agente junto con este registro para que los agentes conserven el contexto y el historial de auditoría en una decisión de varios pasos.
Recuperación nativa mediante IA
La búsqueda vectorial de MongoDB combinada con la búsqueda de texto completo y la reclasificación permite a los agentes recuperar el historial de pérdidas, los precedentes o las directrices más relevantes tanto de campos estructurados como de artefactos no estructurados en una sola query, en lugar de orquestar en un almacenar de vectores independiente.
Propagación en tiempo real
MongoDB Change Streams y Stream Processing nativo mantienen cada agente y sistema descendente sincronizados con el estado actual de una presentación o reclamación, y permiten que nuevas señales o eventos activador un agente directamente en lugar de esperar un ciclo de sondeo o agrupar.
Registro de auditar
La capa de contexto mantiene un registro de auditar inmutable para cada lectura y guardar, de modo que todas las decisiones asistidas por IA sigan siendo transparentes y rastreables en todo momento. Una colección recopila toda la información sobre cada decisión, desde la identidad del usuario/agente que tomó la decisión hasta los pasos para llegar a la conclusión, el contexto, los metadatos de IA, el resultado de la decisión y mucho más.
Limitaciones
Este patrón introduce complejidad y debe adoptarse intencionalmente.
La capa operativa no siempre es la mejor para fines analíticos: Esta arquitectura no es adecuada para cargas de trabajo exclusivamente de análisis, repositorios de archivo o casos de uso en los que las decisiones no requieren ensamblaje de contexto en tiempo real, escrituras o auditabilidad. Si la necesidad primaria es el reporte o el análisis orientado a agrupar, las plataformas analíticas pueden ser suficientes sin añadir una capa de contexto operativo.
La flexibilidad del esquema requiere su propia disciplina: Este enfoque también requiere disciplina en el modelado de datos, la resolución de identidades, la gobernanza y la gestión del ciclo de vida. Una capa de contexto puede acumular objetos grandes y complejos, y esquemas en evolución; por lo tanto, los equipos deben definir los límites de los objetos, las expectativas y los patrones de actualizar desde el principio.
La complejidad del sistema ascendente no se eliminará: Reduce la fragmentación del tiempo de decisión, pero sigue dependiendo de un acceso fiable a los datos ascendentes y de la calidad de los datos. La mala calidad de la fuente o un diseño de evento débil se manifestarán dentro de la capa de contexto en lugar de desaparecer.
La arquitectura funciona mejor cuando se adapta a un caso de uso específico con un modelo de datos predefinido y luego se expande a partir de un flujo de trabajo de referencia probado.
Obtén más información
Explore las otras arquitecturas de referencia: