Esta arquitectura de referencia describe cómo crear flujos de trabajo de IA duraderos en MongoDB Atlas con Temporal para la ingesta basada en eventos, la recuperación semántica y la ejecución basada en agentes.
Admite equipos que necesitan generación aumentada de recuperación (RAG) y flujos de trabajo de IA de varios pasos para continuar de forma fiable a través de fallos, reintentos y operaciones de larga duración.
La arquitectura admite dos patrones de ingesta. En el patrón de flujo de eventos, las actualizaciones de origen fluyen a través de Kafka y Atlas Stream Processing antes de invocar Temporal. En el patrón directo, las actualizaciones de origen activan los flujos de trabajo temporales de inmediato. En ambos casos, MongoDB Atlas almacena datos operativos, conocimientos semánticos y estado de la aplicación, mientras que Temporal coordina las operaciones de extracción, fragmentación, incrustación, indexación y recuperación.
Solución 1: Ingesta a través de Kafka y Atlas Stream Processing
Este patrón se adapta a entornos que ya utilizan Kafka para el transporte de eventos, la propagación de cambios o la integración de sistemas desacoplados. Kafka proporciona una capa de entrada estándar para actualizaciones de fuentes de gran volumen o variadas, mientras que Atlas Stream Processing transforma y enruta eventos antes de invocar Temporal. Esta separación es importante cuando la ingesta debe escalar independientemente de la ejecución del flujo de trabajo, o cuando los equipos desean una columna vertebral de eventos común en múltiples consumidores posteriores además del pipeline de IA. Las actualizaciones de contenido provienen de diversas plataformas, como S3, API o un sistema de base de datos o mensajería.
Diagrama
El siguiente diagrama muestra este flujo.
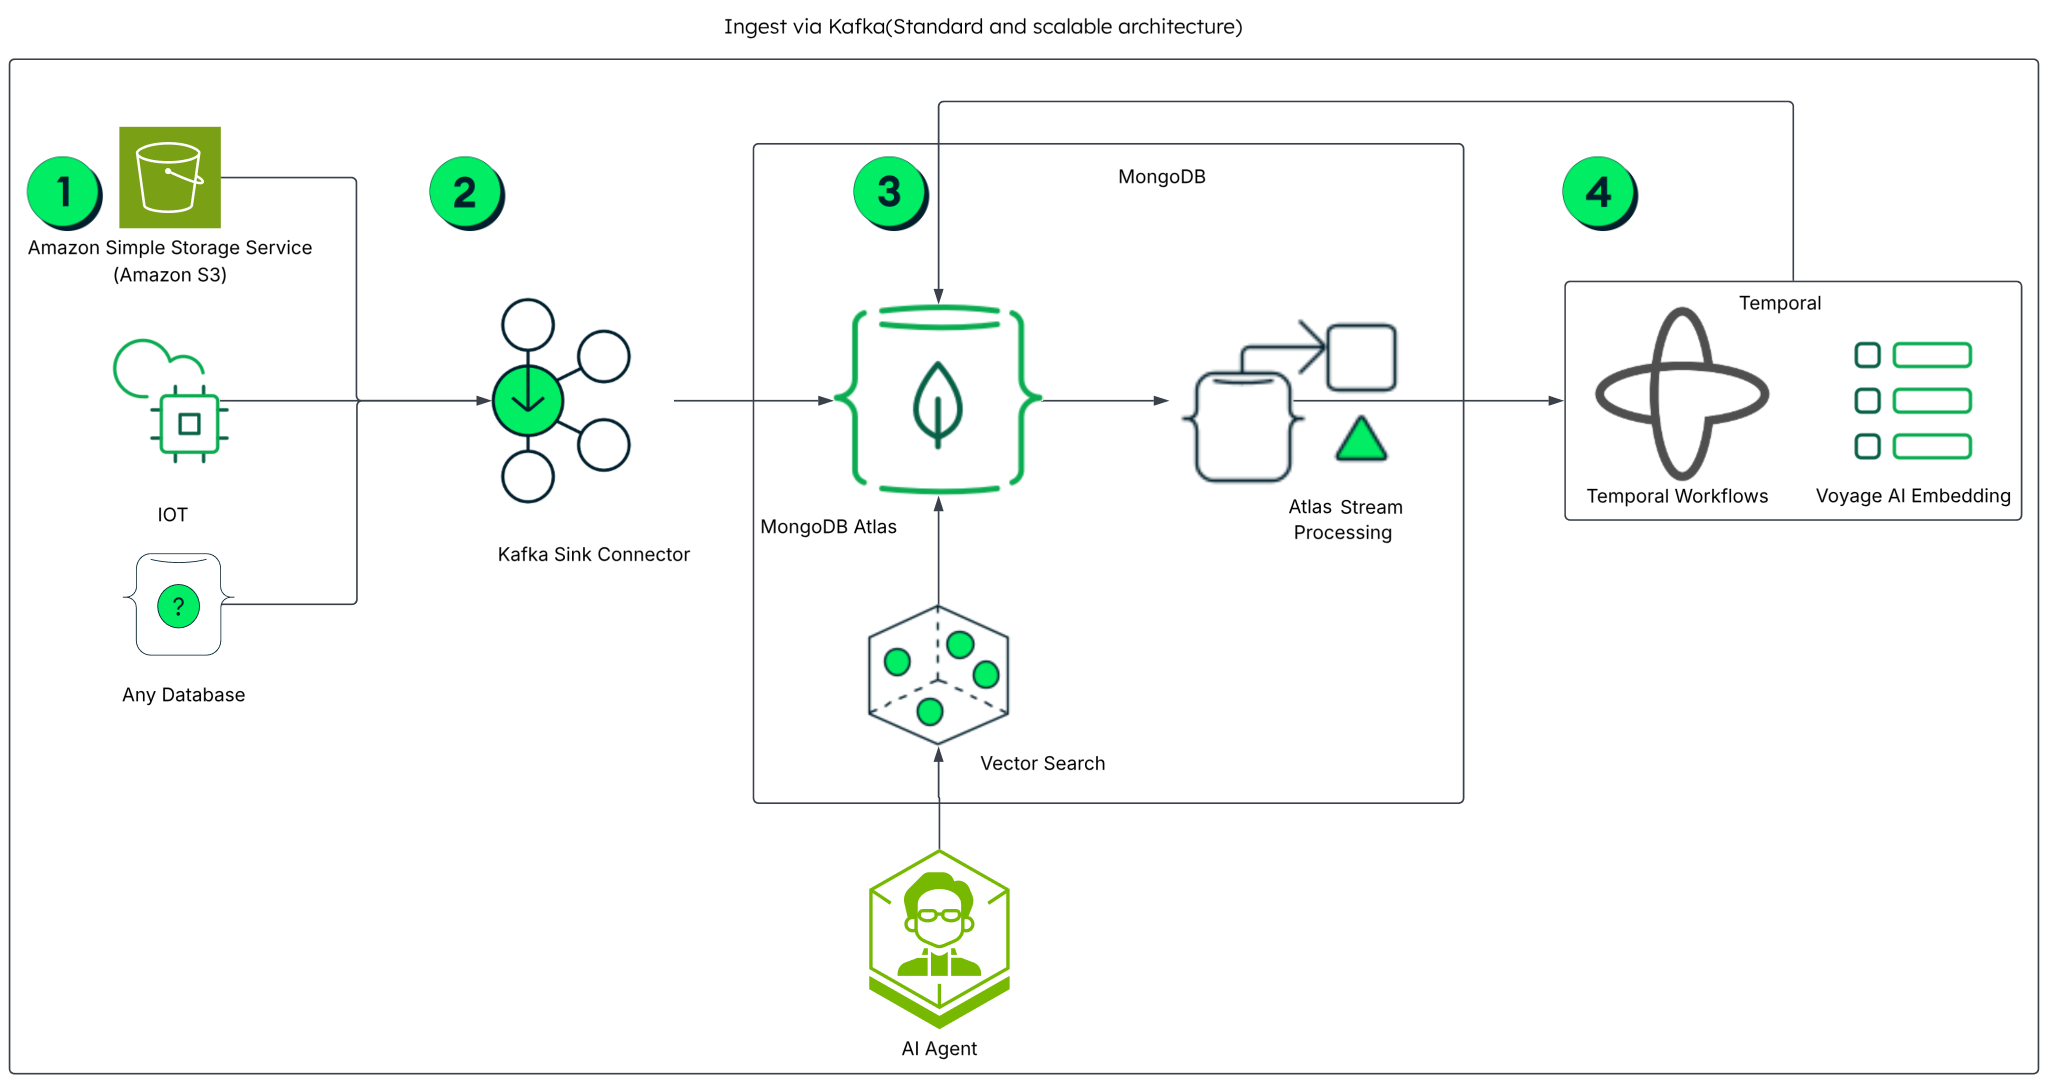
Figura 1. Ingesta a través de Kafka y Atlas Stream Processing
Flujo de datos
Los siguientes pasos describen este flujo:
Los sistemas de origen producen o exponen contenido
El contenido se origina en sistemas ascendentes como Amazon S3, plataformas de IoT y bases de datos operativas. Estos sistemas proporcionan los documentos, registros o eventos sin procesar que procesa el pipeline. Cuando hay contenido nuevo o actualizado disponible, el sistema de origen emite un evento al Kafka Sink Connector, que lo escribe en la colección
sourcesde MongoDB.Kafka Sink Connector
El Kafka Sink Connector es la transferencia de mensajes duradera entre la capa de transmisión y MongoDB. Consume eventos de temas de Kafka y los guarda en MongoDB Atlas como documentos. Este componente proporciona dos cosas que el activador directo no proporciona: agrupa múltiples fuentes variadas en una transmisión ordenada y amortigua la contrapresión.
MongoDB (Atlas, Stream Processing y búsqueda vectorial)
MongoDB desempeña un doble rol en esta arquitectura, apareciendo en dos puntos diferentes del flujo.
MongoDB Atlas es la zona de aterrizaje para los eventos de Kafka Sink Connector. Los documentos de origen sin procesar que el Sink Connector guarda se encuentran en Atlas como el registro de preproducción de lo que llegó del mundo exterior.
Atlas Stream Processing actúa como activador entre esa zona de aterrizaje y Temporal. Observa los documentos entrantes a través de flujos de cambio e inicia el flujo de trabajo descendente. Esto convierte MongoDB de un almacén pasivo en una fuente de eventos activa, lo que elimina la necesidad de un bucle de sondeo y hace que la transferencia a Temporal se base en eventos en lugar de programarse.
Atlas Vector Search sirve la ruta de lectura para el agente, ejecutando la búsqueda de similitud semántica como una etapa del pipeline de agregación, sin una base de datos vectorial separada y sin una query de abanico entre sistemas.
MongoDB aparece en ambos lados del flujo de datos: recibe eventos sin procesar y sirve los vectores incrustados finales. Atlas Stream Processing conecta los dos.
Incrustación temporal y de Voyage AI
Atlas Stream Processing invoca a Temporal, en lugar de que Temporal reciba el evento directamente. El núcleo de procesamiento es el mismo que en la solución 2: los flujos de trabajo temporales proporcionan una orquestación durable y reanudable, y la ejecución de incrustación de Voyage AI como actividades reintentables de forma independiente dentro de esos flujos de trabajo.
En esta solución, Temporal consume eventos de MongoDB en lugar de recibir eventos de origen directamente. Solo recibe un activador limpio y normalizado de Atlas Stream Processing, independientemente de si ese activador se originó en S3, IoT o una base de datos. Esta etapa es bidireccional: Temporal vuelve a escribir los fragmentos incrustados e indexados en la colección de conocimientos de MongoDB una vez que finaliza el procesamiento.
Solución 2: Ingerir fuentes de datos directamente en Temporal
Este patrón se adapta a sistemas que pueden emitir eventos de objetos, API o aplicaciones confiables directamente en un activador de flujo de trabajo. Reduce las capas arquitectónicas y mantiene la ruta de ingesta sencilla, al tiempo que conserva la capacidad de reanudación para los pasos de extracción e incrustación de larga duración. Debido a que el flujo de trabajo se activa con una referencia de origen en lugar de contenido sin procesar, el pipeline descendente permanece agnóstico al origen y puede admitir sistemas ascendentes adicionales con cambios mínimos de orquestación.
Diagrama
El siguiente diagrama muestra este flujo.
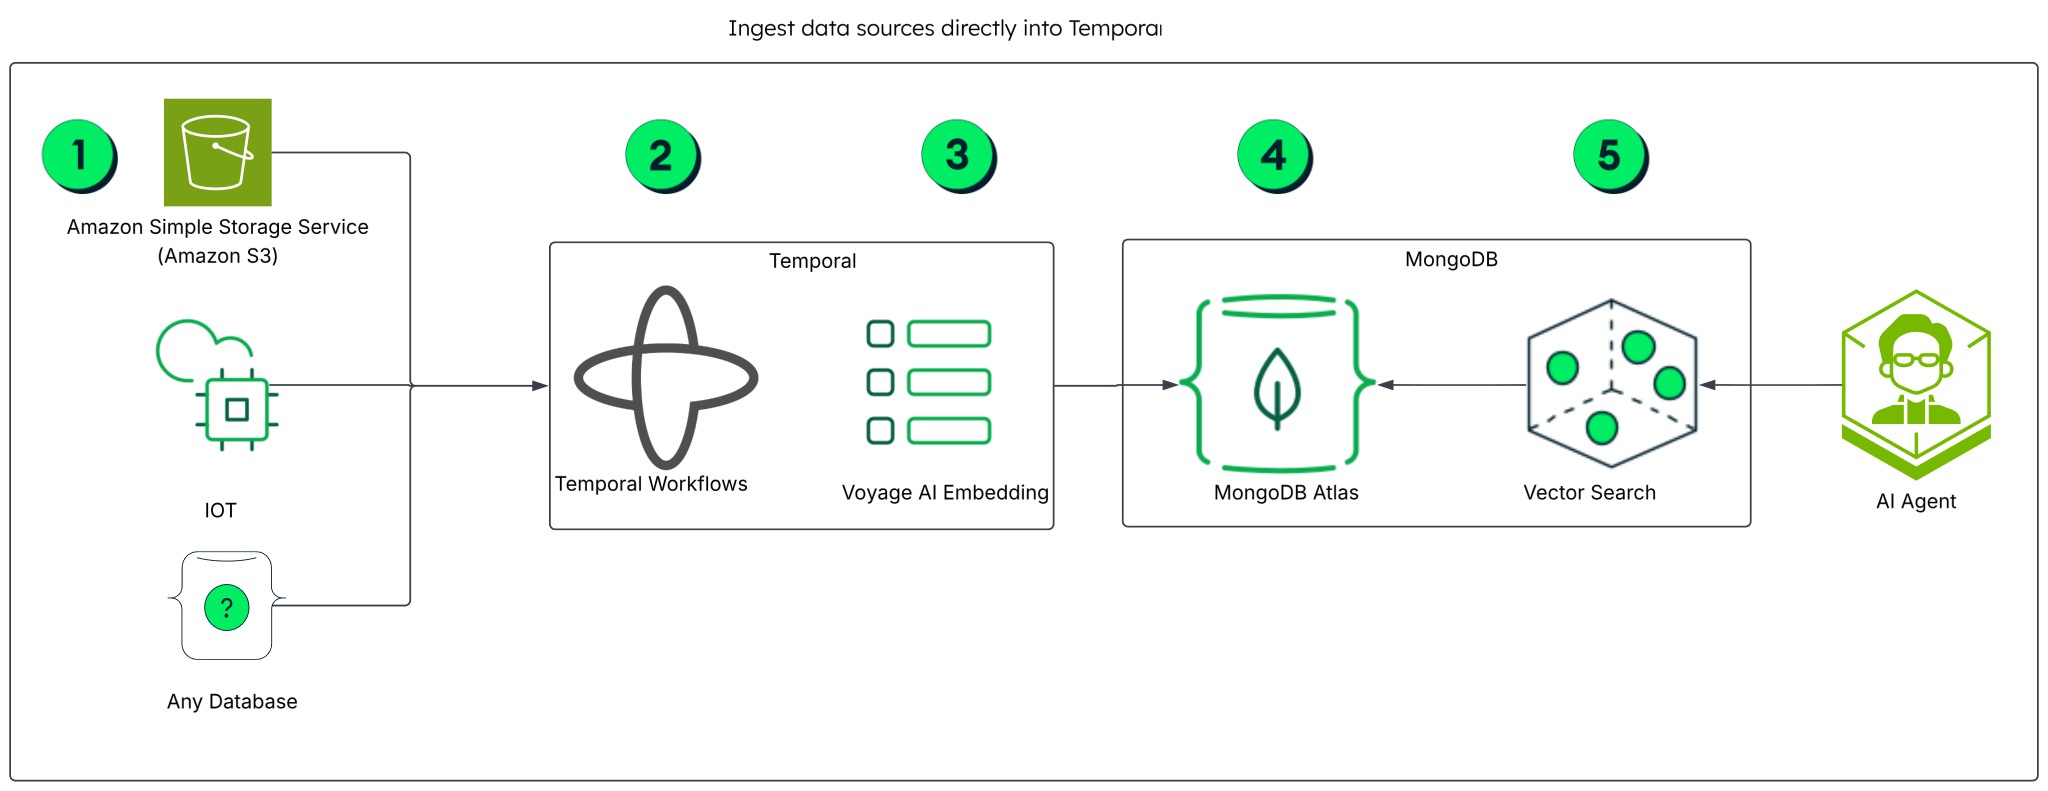
Figura 2. Ingiere fuentes de datos directamente en Temporal
Flujo de datos
Los siguientes pasos describen este flujo:
Los sistemas de origen producen o exponen contenido
El contenido se origina en sistemas ascendentes como Amazon S3, plataformas de IoT y bases de datos operativas. Estos sistemas proporcionan los documentos, registros o eventos sin procesar que procesa el pipeline. Cuando hay contenido nuevo o actualizado disponible, el sistema de origen emite un evento a un adaptador ligero, como AWS Lambda, un webhook o un conector. El adaptador inicia el flujo de trabajo temporal y solo pasa la referencia de origen y los metadatos necesarios. Esto mantiene la lógica específica del origen fuera del flujo de trabajo, por lo que puede agregar nuevos tipos de origen sin cambiar la pipeline descendente.
Temporal gestiona el ciclo de vida de la ingestión
Una vez que se inicia el flujo de trabajo, Temporal coordina la ejecución, los reintentos y la recuperación en todos los pasos de ingesta. Esto hace que la ruta de procesamiento sea durable, por lo que las operaciones de larga duración continúan de forma fiable a pesar de los fallos o reinicios. El flujo de trabajo recupera el contenido de origen y lo convierte en un formato normalizado para el procesamiento de IA posterior, creando una representación coherente en todos los tipos de origen antes de que comience la transformación semántica.
Voyage AI genera incrustaciones dentro del flujo de trabajo
La incrustación de Voyage AI se ejecuta como parte del flujo de trabajo en lugar de como un paso externo de "disparar y olvidar". Esto mantiene la incrustación observable y recuperable dentro de la misma ruta de ejecución, y mantiene la transformación semántica estrechamente acoplada al ciclo de vida de la ingesta.
MongoDB Atlas almacena contenido, metadatos e incrustaciones
MongoDB Atlas mantiene el contenido procesado, los metadatos relacionados y los vectores de incrustación en una única plataforma. Esto crea una capa de conocimiento durable que admite tanto la ruta de guardar de ingesta como la ruta de recuperación posterior.
Atlas Vector Search hace que el conocimiento sea recuperable
Atlas Vector Search indexa el contenido incrustado para que pueda consultar la query por similitud semántica. Dado que las incrustaciones y los metadatos operativos permanecen en la misma plataforma, las solicitudes posteriores de aplicaciones y agentes recuperan el contexto relevante sin un almacén vectorial o una capa de sincronización independientes.
Flujo de solicitud de agente
Este flujo se aplica a ambas soluciones de ingestión. Utiliza los mismos principios de durabilidad que la ingestión: en lugar de tratar la ejecución del agente como una solicitud de API de corta duración, la arquitectura ejecuta la recuperación y el razonamiento como operaciones impulsadas por el flujo de trabajo que puede observar, reintentar y reanudar. Esto es importante cuando el agente realiza varias llamadas de recuperación, invoca herramientas externas o necesita devolver actualizaciones de estado progresivas antes de un resultado final.
Diagrama
El siguiente diagrama muestra los componentes del agente.

Figura 3. Arquitectura de agente de investigación
Flujo de datos
Los siguientes pasos describen este flujo:
Iniciar una solicitud de investigación de agente
Cuando la API de agente recibe una query de usuario a través de la Interfaz de Usuario, inicia un flujo de trabajo Temporal durable. El sistema devuelve inmediatamente un identificador de flujo de trabajo, de modo que la Interfaz de Usuario pueda rastrear el progreso a medida que el agente de investigación recupera el contexto y razona sobre una respuesta.
Recuperar contexto de MongoDB Atlas Vector Search
MongoDB Atlas aloja los metadatos, las incrustaciones vectoriales y los índices semánticos. Durante una interacción del usuario, el agente incrusta la query y utiliza MongoDB Atlas Vector Search para recuperar el contexto relevante, a menudo aplicando una capa de reclasificación antes de la síntesis final. Para obtener patrones de indexación y query, consulte la documentación de Atlas Vector Search.
Devolver un resultado de investigación duradero
El flujo de trabajo de investigación coordina la ejecución de herramientas, las interacciones con el modelo y la síntesis final. Temporal mantiene el proceso mediante reintentos y persistencia de estado, de modo que la interfaz de usuario proporciona una respuesta validada. Para obtener más información sobre la ejecución persistente, consulte la documentación de Temporal.
Componentes
Los siguientes componentes implementan esta arquitectura.
MongoDB Atlas
Utilice MongoDB Atlas para almacenar los fragmentos organizados e incrustados del pipeline de ingesta, el índice de búsqueda vectorial de Atlas Vector Search y el estado del agente en una sola base de datos. Debido a que el agente lee los mismos datos que guarda el pipeline de ingesta, no hay un almacén de memoria independiente para mantener sincronizado.
Atlas Stream Processing
Utilice Atlas Stream Processing para proporcionar una ruta de integración opcional basada en eventos entre las fuentes de transmisión y los flujos de trabajo temporales. Gestiona la transformación y el enrutamiento en tiempo real de los eventos entrantes para arquitecturas de alto rendimiento. Esto le permite implementar la ingesta en tiempo casi real sin necesidad de Kafka si, en su lugar, elige una conexión directa de origen a Temporal.
Voyage AI
Utilice Voyage AI para generar las incrustaciones y realizar la reclasificación de resultados para esta arquitectura. Debido a que la incrustación y la reclasificación están separadas de la orquestación del flujo de trabajo, los equipos pueden actualizar el modelo independientemente de los pipeline de ingesta y recuperación.
Atlas Vector Search
Utiliza MongoDB Atlas Vector Search para recuperar el contexto del documento y la memoria del agente mediante la indexación semántica. El agente de investigación consulta el mismo clúster de MongoDB Atlas que se utiliza para el almacenamiento primario, por lo que la recuperación utiliza los datos operativos actuales.
Temporal
Usa Temporal como capa de ejecución durable para flujos de trabajo de ingesta y agénticos a través de sistemas de origen, MongoDB Atlas y servicios externos de IA. Coordina pasos de larga ejecución como extracción, fragmentación, incrustación e indexación, y proporciona las funcionalidades incorporadas de reintentos, puntos de control y recuperación. Esto permite que los flujos de trabajo se reanuden desde su último estado exitoso después de una falla o interrupción, en lugar de reiniciarse. Al hacer que la orquestación sea durable, Temporal ayuda a los equipos a operar, rellenar y evolucionar de manera confiable los pipelines de IA en producción.
Excepciones, salvedades y compensaciones
Considere las ventajas y desventajas de la ingesta directa y basada en Kafka antes de adoptar esta arquitectura. Una conexión directa de origen a Temporal tiene menos partes móviles para operar. Una ruta basada en Kafka añade un agente de mensajes, lo que introduce infraestructura adicional, pero encaja de forma natural si su organización ya enruta las actualizaciones de origen a través de Kafka.
Implementación y más información
Consulte el repositorio de GitHub mdb-temporal-pra para obtener instrucciones de implementación y documentación técnica.