Moderne Anwendungen müssen auch dann verfügbar bleiben, wenn der Datenverkehr plötzlich ansteigt oder Abfragen unverhältnismäßig viele Ressourcen beanspruchen. MongoDB Atlas ist auf hohe Verfügbarkeit ausgelegt, aber Verfügbarkeit in der Praxis bedeutet mehr, als nur den Ausfall von hosts oder die Wahl eines replica set zu überstehen. Es geht auch darum, wie sich ein cluster verhält, wenn die Nachfrage das übersteigt, was er sicher verarbeiten kann.
Letzte Woche haben wir Intelligent Workload Management (IWM) als GA in MongoDB 9.0 angekündigt. IWM ist eine managed-Availability-Funktion, die dafür sorgt, dass Atlas-Cluster auch bei Überlastung reaktionsschnell und vorhersehbar bleiben. IWM stellt vorübergehende Lastspitzen in Warteschlangen ein, hält sowohl kurz als auch lang laufende Vorgänge stabil und schützt die Cluster-Integrität, ohne dass Änderungen an der Anwendung erforderlich sind.
Überlastungsereignisse treten häufig schneller ein, als die Infrastruktur skalieren kann. Selbst bei aktivierter Skalierung nimmt die Bereitstellung zusätzlicher Kapazitäten Zeit in Anspruch. In The Gap zwischen einem Traffic-Spitzenwert und der Bereitstellung neuer Kapazitäten kann ein cluster instabil werden, wenn jede Anfrage gleich behandelt wird und Clients aggressiv neue Versuche unternehmen. IWM wurde entwickelt, um diese Lücke zu schließen, indem es die Gesundheit von cluster erhält, die Leistung optimiert und einen unvorhersehbaren Ausfall in ein kontrolliertes, beobachtbares Ereignis verwandelt.
Bei Coinbase kann das Handelsvolumen innerhalb von Minuten sprunghaft ansteigen, und unsere Systeme müssen in Echtzeit skalieren, sonst bekommen die Kunden das zu spüren. Intelligent Workload Management gibt uns die Gewissheit, dass unsere Cluster auch bei höchsten Handelsauslastungen reaktionsfähig bleiben.
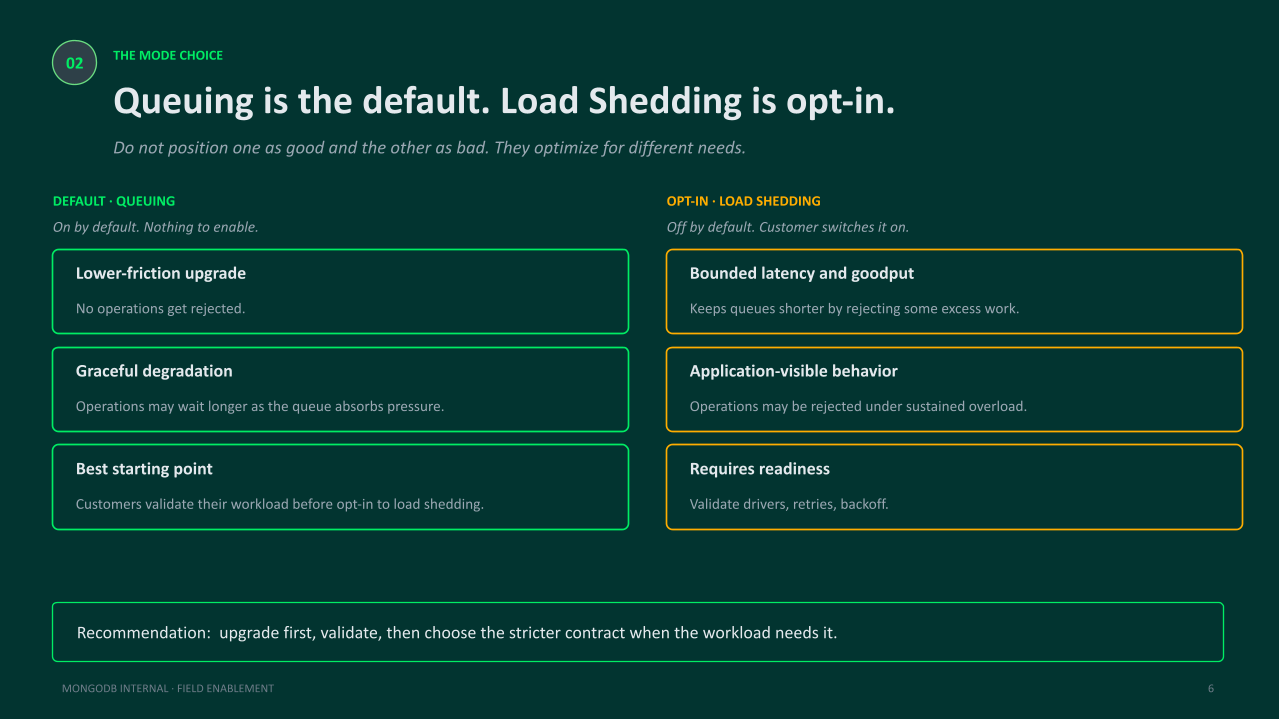
”Bei anhaltender Überlastung können Kunden optional Load Shedding aktivieren, um überschüssige Vorgänge abzulehnen. IWM hilft bei der Bewältigung von Druck während eines Anstiegs oder wenn Kapazität hinzugefügt wird; es fügt keine Kapazität hinzu oder ersetzt Auto-Skalierung und Kapazitätsplanung.
Abbildung 1. Intelligent Workload Management passt sich an, damit Ihre cluster reaktionsfähig und vorhersehbar bleiben.
Umgang mit Arbeitslastdruck während der Kapazitätsanpassung
Verkehrsspitzen und ressourcenintensive Vorgänge können die Nachfrage schneller steigen lassen, als die Infrastruktur skalieren kann. Selbst wenn die automatische Skalierung aktiviert ist, nimmt die Bereitstellung zusätzlicher Kapazität Zeit in Anspruch. Aggressive Wiederholungsversuche von Clients können zusätzlichen Druck ausüben, während ein cluster bereits ausgelastet ist.
IWM trägt dazu bei, den Arbeitslastdruck in diesem Zeitraum zu bewältigen. Es funktioniert mit oder ohne automatische Skalierung: Wenn die automatische Skalierung aktiviert ist, hilft IWM, das cluster stabil zu halten, während Kapazität online geht; ohne sie managed IWM die Arbeit mit der bereitgestellten Kapazität des clusters. Bei anhaltender oder steigender Nachfrage kann eine zusätzliche Kapazität dennoch erforderlich sein.
Wie IWM auf Arbeitslastdruck reagiert
Wenn ein cluster fehlerfrei ist, ist IWM effektiv unsichtbar. Wenn die Nachfrage das übersteigt, was der cluster sicher verarbeiten kann, managed IWM den Druck stufenweise:
- Es begrenzt eingehende Arbeit und reiht überschüssige Anforderungen in die Warteschlange ein: Standardmäßig stellt IWM überschüssige Anforderungen in eine Warteschlange, anstatt sie proaktiv abzulehnen. Dies kann dazu beitragen, vorübergehende Spitzen zu absorbieren, obwohl es bei den in die Warteschlange eingereihten Anforderungen länger dauern kann, bis sie abgeschlossen sind, während die Ressourcen knapp sind. Das Queueing ändert, wann Arbeit erledigt wird, nicht die Menge an Arbeit, die die Anwendung letztendlich vom Cluster verlangt.
- Dies trägt dazu bei, kurz laufende Vorgänge in Bewegung zu halten: Ein kurz laufender Vorgang, wie z. B. ein typischer Lese- oder Schreibvorgang, und ein lang laufender Vorgang, wie z. B. eine große Berichtsabfrage, stellen nicht dieselben Anforderungen an einen cluster. Wenn die Ressourcen knapp sind, hält IWM kurz laufende Vorgänge in Bewegung, während lang laufende Vorgänge konservativer verwaltet werden.
- Es hilft bei der managed von Ressourcendruck: Speicherfragmentierung, Cache-Ungleichgewichte und Speichererschöpfung können alle einen gesunden cluster destabilisieren. IWM passt die cluster-Speicher- und Cache-managed an, wenn es ungesunde Muster erkennt, und kann neue Schreibvorgänge pausieren und gleichzeitig Lesevorgänge zulassen, wenn die Speichernutzung kritische Werte erreicht.
Diese Schutzmaßnahmen tragen dazu bei, die Gesundheit eines cluster bei Überlastung zu erhalten. Sie machen die Kapazität nicht unbegrenzt und ersetzen nicht eine gute Indizierung, Kapazitätsplanung oder automatische Skalierung.
Standardschutzmaßnahmen und optionales Load Shedding
Die Standardschutzmaßnahmen von IWM sind ohne zusätzliche Kosten auf geeigneten dedizierten Atlas-Cluster mit MongoDB 9.0 verfügbar. Sie erfordern keine Anwendungsänderungen oder Treiber-Upgrades. Standardmäßig verwaltet IWM Überlastungen, ohne überschüssige Arbeit aktiv abzulehnen.
Load Shedding ist eine separate, optionale Steuerung bei dauerhafter Überlastung. Wenn diese Option aktiviert ist, können überschüssige Vorgänge abgelehnt werden, und diese Ablehnungen sind für Ihre Anwendung als Überlastungsfehler sichtbar. Load Shedding ist ohne zusätzliche Kosten für berechtigte dedizierte replica set-cluster auf Basis von MongoDB 9.0 der M30+ Stufe in Atlas verfügbar.
Die standardmäßigen IWM-Schutzfunktionen funktionieren mit jedem MongoDB-Treiber. Wenn Sie Load Shedding aktivieren, verwenden Sie einen unterstützten backpressure-aware driver, damit Ihre Anwendung Überlastungssignale interpretieren und begrenzte Wiederholungsversuche mit Backoff anwenden kann. Überprüfen Sie die Matrix der unterstützten Treiber, bevor Sie Load Shedding aktivieren.
Abbildung 2. Der Unterschied zwischen der Standardeinstellung (Warteschlange) und der Einstellung „Load Shedding“ (Lastabwurf).
IWM-Interventionen mit Observability verstehen
Überprüfen Sie in Atlas die Metriken Operation Rate Limiting und Connection Rate Limiting auf in die Warteschlange eingereihte oder abgelehnte Vorgänge oder Verbindungen. Wenn das Laden von Last (Load Shedding) aktiviert ist, erscheinen abgelehnte Vorgänge unter Operation Rate Limiting. Konfigurieren oder überprüfen Sie die IWM-Warnbedingung, um relevante IWM-Aktivitäten zu verfolgen, und überprüfen Sie den Aktivitätsfeed auf IWM-bezogene Ereignisse. Zusammen helfen Ihnen diese Atlas-Oberflächen bei der Beurteilung, ob der Druck anhält und ob Arbeitslastmuster überprüft oder Kapazitäten hinzugefügt werden sollten. Erfahren Sie mehr über die IWM-Beobachtbarkeit in Atlas.
Für Teams, die optionales Load Shedding bewerten, bietet Atlas auch einen Test zur Überprüfung der Treiberkompatibilität, der Anwendungsabwicklung von Überlastfehlern und der betrieblichen Transparenz, bevor sie sich auf das Steuerelement in der Produktion verlassen. Wenn Atlas auf aktiven Test- oder Entwicklungs-Clustern getestet wird, weist Atlas ungeachtet der Auslastung zufällig einen kleinen Prozentsatz der Vorgänge zurück. Teams können abgelehnte Vorgänge im Metrikdiagramm verfolgen und die Ergebnisse nach Ende des Tests überprüfen. Da Anwendungen während des Tests auf Überlastungsfehler stoßen können, sollten Teams diese Tests nur zur Überprüfung des Clientverhaltens verwenden. Teams sollten keine Tests auf einem Produktionscluster durchführen. Erfahren Sie, wie Sie Load Shedding testen.
Weitere Informationen zum IWM-Verhalten und zur Reaktion auf Überlastungen finden Sie in der IWM-Dokumentation.
Erste Schritte
Vergewissern Sie sich, dass es sich bei Ihrem Cluster um einen geeigneten dedizierten Atlas-Cluster mit MongoDB 9.0 handelt.
Entscheiden Sie, ob die automatische Skalierung bei anhaltender Überlastung Kapazitäten hinzufügen soll. IWM hilft bei der Druckbewältigung, während zusätzliche Kapazitäten online geschaltet werden; es ersetzt nicht die automatische Skalierung oder Kapazitätsplanung.
Wenn Sie Load Shedding aktivieren, prüfen Sie die unterstützte Treibermatrix und bestätigen Sie, dass Ihre Anwendung begrenzte Wiederholungsversuche mit Backoff verwendet.
Überprüfen Sie die Atlas-Observability-Dashboards, um zu verstehen, wann IWM eingreift und welche Arbeitslasten betroffen sind.
Wie geht es weiter?
Sind Sie bereit, Ihre cluster bei Überlastung besser zu steuern? Lesen Sie die IWM-Dokumentation, erkunden Sie die automatische Skalierung von Atlas oder registrieren Sie sich für MongoDB Atlas, um noch heute mit der Entwicklung zu beginnen.