Um conjunto de réplica no MongoDB é um grupo de processos do mongod que mantém o mesmo conjunto de dados. Os conjuntos de réplica fornecem redundância e alta disponibilidade, e são a base para todas os sistemas de produção. Esta seção apresenta a replicação no MongoDB, bem como os componentes e a arquitetura dos conjuntos de réplicas. A seção também fornece tutoriais para tarefas comuns relacionadas a conjuntos de réplicas.
Redundância e disponibilidade de dados
A replicação oferece redundância e disponibilidade dos dados, mantendo várias cópias de dados em servidores de banco de dados para tolerar a perda de qualquer servidor único.
Em alguns casos, a replicação pode fornecer maior capacidade de leitura, pois os clientes podem enviar operações de leitura para servidores diferentes. A manutenção de cópias de dados em diferentes data centers pode aumentar a localidade e a disponibilidade dos dados para aplicativos distribuídos. Você também pode manter cópias adicionais para fins dedicados, como recuperação após desastres, relatórios ou backup.
Replicação no MongoDB
Um conjunto de réplicas é um grupo de instâncias do mongod que mantém o mesmo conjunto de dados. Um conjunto de réplicas contém vários nós portadores de dados e, opcionalmente, um nó de árbitro. Dos nós portadores de dados, um e apenas um membro é considerado o primário, enquanto os outros nós são considerados nós secundários.
Aviso
Cada nó do conjunto de réplicas deve pertencer a um (e apenas um) conjunto de réplicas. Os nós do conjunto de réplicas não podem pertencer a mais de um conjunto de réplicas.
The primary node receives all write operations. A replica set can have only one primary capable of confirming writes with { w: "majority" } write concern, although in some circumstances, another mongod instance may transiently believe itself to also be primary. [1] The primary records all changes to its data sets in its operation log, that is, the oplog. For more information on primary node operation, see Replica Set Primary.
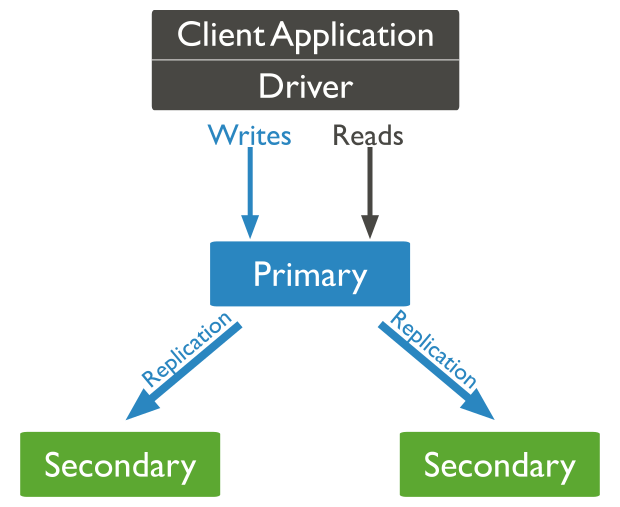
Os secundários replicam o oplog do primário e aplicam as operações aos seus conjuntos de dados de forma que os conjuntos de dados dos secundários reflitam o conjunto de dados do primário. Se o primário não estiver disponível, um secundário elegível realizará uma eleição para selecionar um novo primário. Para obter mais informações sobre membros secundários, consulte Membros secundários do conjunto de réplicas.
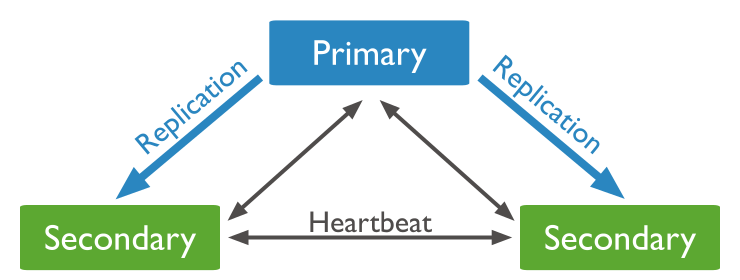
Se as restrições de custo impedirem a adição de outro secundário, você pode adicionar uma instância mongod a um conjunto de réplicas como árbitro. Um árbitro participa das eleições, mas não detém os dados (ou seja, não fornece redundância de dados). Para obter mais informações sobre árbitro, consulte Árbitro de conjunto de réplicas.
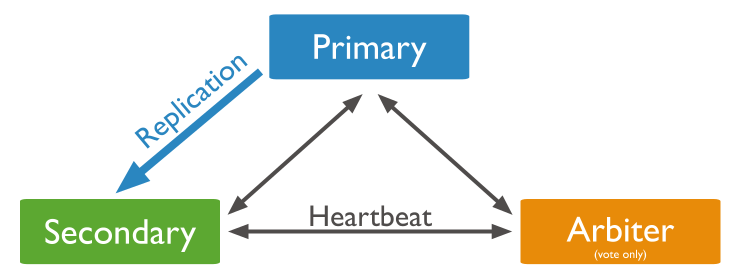
Um árbitro é sempre um árbitro, enquanto um primário pode renunciar e se tornar um secundário e um secundário pode se tornar o primário durante uma eleição.
Replicação assíncrona
Os secundários replicam o oplog da primária e aplicam as operações aos seus conjuntos de dados de forma assíncrona. Como os conjuntos de dados secundários refletem o conjunto de dados primário, o conjunto de réplicas pode continuar a funcionar apesar do fracasso de um ou mais membros.
Para obter mais informações sobre mecânica de replicação, consulte Replica Set Oplog e Replica Set Data Synchronization.
Operações lentas
Os membros secundários de um conjunto de réplicas agora registram entradas de oplog que demoram mais do que o limite de operação lenta para serem aplicadas. Essas mensagens de atraso no oplog:
São registradas para os secundários no
diagnostic log.São registradas sob o componente
REPLcom o textoapplied op: <oplog entry> took <num>ms.Não dependem dos níveis de registro (seja no nível do sistema ou do componente)
Não dependem do nível de perfil.
São afetados por
slowOpSampleRate.
O perfilador não captura entradas de oplog lentas.
Atraso de replicação e controle de fluxo
Atraso de replicação é um atraso entre uma operação no primário e a aplicação dessa operação do oplog para o secundário. Um pequeno período de atraso pode ser aceitável, mas problemas significativos surgem à medida que o atraso de replicação cresce, incluindo a criação de pressão de cache no primário.
A partir do MongoDB 4.2, os administradores podem limitar a taxa na qual o primário aplica suas gravações com o objetivo de manter o atraso abaixo de um valor máximo majority committed configurável flowControlTargetLagSeconds.
Por padrão, o controle de fluxo é enabled.
Com o controle de fluxo ativado, à medida que o atraso se aproxima do flowControlTargetLagSeconds, as gravações no primário precisam obter tíquetes antes de usar os bloqueios para aplicar as gravações. Ao limitar o número de tíquetes emitidos por segundo, o mecanismo de controle de fluxo tenta manter o atraso abaixo da meta.
Para obter mais informações, consulte Verificar o sinalizador de replicação e o controle de fluxo.
Failover automático
Quando um primário não se comunica com os outros membros do conjunto por mais do que o período de electionTimeoutMillis configurado (10 segundos por padrão), um secundário elegível solicita uma eleição para se nomear como o novo primário.
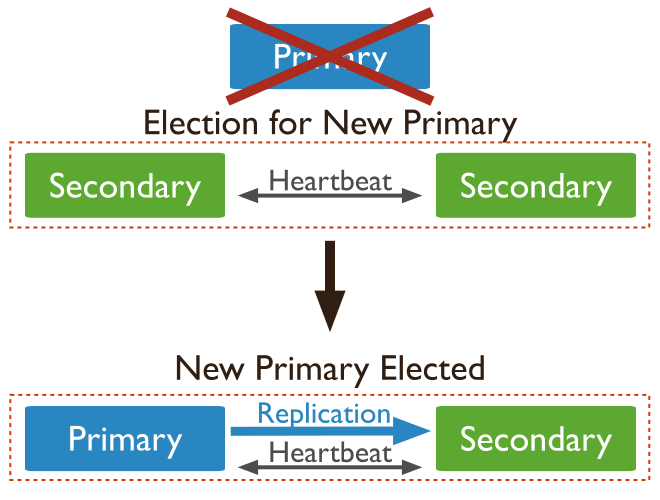
The median time before a cluster elects a new primary should not typically exceed 12 seconds, assuming default replica configuration settings. This includes time required to mark the primary as unavailable and call and complete an election. You can tune this time period by modifying the settings.electionTimeoutMillis replication configuration option. Factors such as network latency may extend the time required for replica set elections to complete, which in turn affects the amount of time your cluster may operate without a primary. These factors are dependent on your particular cluster architecture.
Reduzir a opção de configuração de replicação do electionTimeoutMillis a partir do padrão 10000 (10 segundos) pode resultar em detecção mais rápida de falha primária. No entanto, o cluster pode convocar eleições com mais frequência devido a fatores como latência temporária da rede, mesmo que o primário esteja saudável. Isso pode resultar em mais rollbacks para operações de gravação w : 1.
A lógica de conexão do seu aplicativo deve incluir tolerância para failovers automáticos e as eleições subsequentes. Os drivers do MongoDB podem detectar a perda do primário e repetir automaticamente determinadas operações de gravação uma única vez, fornecendo tratamento adicional integrado de failovers e eleições automáticas:
Drivers compatíveis permitem gravações repetíveis por padrão
MongoDB provides mirrored reads to pre-warm electable secondary members' cache with the most recently accessed data. Pre-warming the cache of a secondary can help restore performance more quickly after an election.
Para saber mais sobre o processo de failover do MongoDB, consulte:
Ler operações
readPreference
By default, clients read from the primary [1]; however, clients can specify a read preference to send read operations to secondaries.
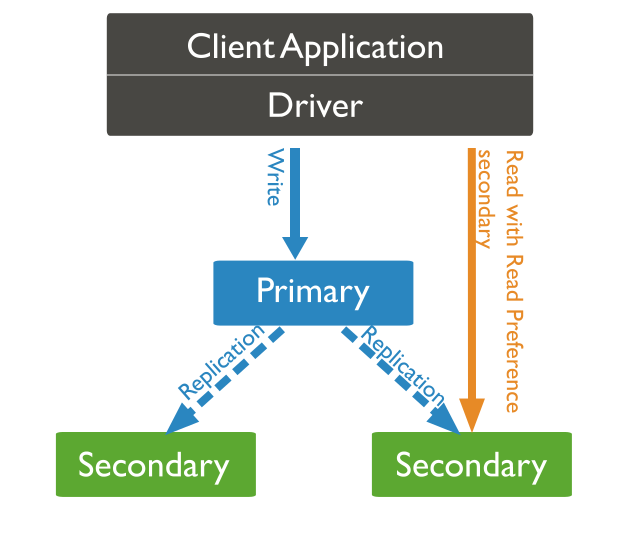
Asynchronous replication to secondaries means that reads from secondaries may return data that does not reflect the state of the data on the primary.
As transações que contêm operações de leitura devem usar a preferência de leitura primary. Todas as operações em uma determinada transação devem ser roteadas para o mesmo nó.
Para obter informações sobre como ler a partir de conjuntos de réplica, consulte Preferência de leitura.
Visibilidade de dados
Dependendo do read concern, os clientes podem ver os resultados das escritas antes que elas sejam duráveis:
Independentemente da write concern, outros clientes que usam a read concern podem ver o resultado de uma operação de gravação antes que a operação de gravação seja reconhecida pelo cliente
"local""available"emissor.Os clientes que usam a read concern
"local"ou"available"podem ler dados que podem ser revertidos posteriormente durante failovers de conjuntos de réplicas.
Para operações em uma transação de vários documentos, quando uma transação é confirmada, todas as alterações de dados feitas na transação são salvas e ficam visíveis fora da transação. Ou seja, uma transação não confirmará algumas de suas alterações enquanto reverte outras.
Até que uma transação seja confirmada, as alterações de dados feitas na transação não serão visíveis fora da transação.
No entanto, quando uma transação é gravada em vários fragmentos, nem todas as operações de leitura externas precisam esperar que o resultado da transação confirmada fique visível nos fragmentos. Por exemplo, se uma transação estiver comprometida e escrever 1 estiver visível no fragmento A, mas escrever 2 ainda não estiver visível no fragmento B, uma leitura externa em questão de leitura "local" poderá ler os resultados da escrita 1 sem ver a escrita 2.
Para obter mais informações sobre isolamentos de leitura, consistência e recência para o MongoDB, consulte Isolamento de leitura, consistência e recência.
Leituras espelhadas
Mirrored reads reduce the impact of primary elections by pre-warming the caches of electable secondary replica set members before a failover occurs. The primary mirrors a sample of the supported operations it receives to electable secondaries.
O tamanho do subconjunto de membros do conjunto de réplica secundária do electable que recebem leituras espelhadas pode ser configurado com o parâmetro mirrorReads. Consulte Ativar/desativar suporte para leituras espelhadas para obter mais detalhes.
Observação
As leituras espelhadas não afetam a resposta da primary para o cliente. A leitura que o primary replica para os secundários são operações do tipo "fire-and-forget". A primary não espera por respostas.
Operações suportadas
As leituras espelhadas suportam as seguintes operações:
findAndModify(Especificamente, o filtro é enviado como uma leitura espelhada)update(Especificamente, o filtro é enviado como uma leitura espelhada)
Ativar/Desativar suporte para Leituras Espelhadas
As leituras espelhadas são ativadas por padrão e usam um padrão sampling rate de 0.01. Para desabilitar leituras espelhadas, configure o parâmetro mirrorReads para { samplingRate: 0.0 }:
db.adminCommand( { setParameter: 1, mirrorReads: { samplingRate: 0.0 } } )
With a sampling rate greater than 0.0, the primary mirrors supported reads to a subset of electable secondaries. With a sampling rate of 0.01, the primary mirrors one percent of the supported reads it receives to a selection of electable secondaries.
Por exemplo, considere um conjunto de réplicas que consiste em um primário e dois secundários eletivos. Se o primário receber 1000 operações que podem ser espelhadas e a taxa de amostragem for 0.01, o primário espelha cerca de 10 leituras suportadas para uma seleção aleatoriamente escolhida de secundários selecionáveis.
Alterar a taxa de amostragem para leituras espelhadas
Para alterar a taxa de amostragem para leituras espelhadas, configure o parâmetro mirrorReads para um número entre 0.0 e 1.0:
Uma taxa de amostragem de
0.0desabilita leituras espelhadas.Uma taxa de amostragem de um número entre
0.0e1.0resulta no primário de uma amostra aleatória das leituras suportadas à taxa de amostragem especificada para secundários elegíveis.A sampling rate of
1.0results in the primary forwarding all supported reads to electable secondaries.
Para detalhes, consulte mirrorReads.
Métricas de leituras espelhadas
O comando serverStatus e o método de shell db.serverStatus() retornam métricas mirroredReads se você especificar o campo na operação:
db.serverStatus( { mirroredReads: 1 } )
Transações
A partir do MongoDB 4.0, estão disponíveis transações de vários documentos para conjuntos de réplica.
As transações que contêm operações de leitura devem usar a preferência de leitura primary. Todas as operações em uma determinada transação devem ser roteadas para o mesmo nó.
Até que uma transação seja confirmada, as alterações de dados feitas na transação não serão visíveis fora da transação.
No entanto, quando uma transação é gravada em vários fragmentos, nem todas as operações de leitura externas precisam esperar que o resultado da transação confirmada fique visível nos fragmentos. Por exemplo, se uma transação estiver comprometida e escrever 1 estiver visível no fragmento A, mas escrever 2 ainda não estiver visível no fragmento B, uma leitura externa em questão de leitura "local" poderá ler os resultados da escrita 1 sem ver a escrita 2.
Fluxos de alterações
A partir do MongoDB 3.6, alterar fluxos estão disponíveis para conjuntos de réplica e clusters fragmentados. Os fluxos de alterações permitem que os aplicativos acessem alterações de dados em tempo real sem a complexidade e o risco de afetar o oplog. Os aplicativos podem usar change streams para assinar todas as alterações de dados em uma coleção ou coleções.
Recursos adicionais
Os conjuntos de réplicas definem várias opções para atender às necessidades dos aplicativos. Por exemplo, você pode implantar um conjunto de réplicas com membros em vários data centers ou controlar o resultado das eleições ajustando o members[n].priority de alguns membros. Os conjuntos de replica também oferecem suporte a membros dedicados para reporting, recuperação de desastre ou backup.
Consulte Membros do conjunto de réplicas de prioridade 0, Membros do conjunto de réplicas ocultas e Membros do conjunto de réplicas atrasados para obter mais informações.
| [1] | (1, 2) Em alguns casos, dois nós em um conjunto de réplicas podem acreditar transitoriamente que são os primários, mas somente um deles poderá realizar gravações com restrição de gravação |