Importante
$rankFusion está disponível apenas para implantações que utilizam MongoDB 8.0 e posterior.
Ao fazer upgrade do 8.0, talvez seja necessário pausar a execução de queries $rankFusion.
Definição
$rankFusion$rankFusionprimeiro executa todos os pipelines de entrada de forma independente e, em seguida, deduplica e combina os resultados do pipeline de entrada em um conjunto de resultados classificado final.$rankFusiongera um conjunto classificado de documentos com base nas classificações que os documentos de entrada aparecem em seus pipelines de entrada e nos pesos do pipeline. Esse estágio usa o algoritmo de fusão de classificação recíproca para classificar os resultados combinados dos pipelines de entrada.Use
$rankFusionpara pesquisar documentos em uma única coleção com base em vários critérios e recuperar um conjunto de resultados classificados finais que inclui todos os critérios especificados.
Sintaxe
O estágio tem a seguinte sintaxe:
{ $rankFusion: { input: { pipelines: { <myPipeline1>: <expression>, <myPipeline2>: <expression>, ... } }, combination: { weights: { <myPipeline1>: <numeric expression>, <myPipeline2>: <numeric expression>, ... } }, scoreDetails: <bool> } }
Campos de comando
$rankFusion usa os seguintes campos:
Campo | Tipo | Descrição |
|---|---|---|
| Objeto | Define a entrada que |
| Objeto | Contém um mapa de nomes de pipeline para os estágios de agregação que definem esse pipeline. For more information on input pipeline restrictions, see Input Pipelines and Input Pipeline Names. |
| Objeto | Opcional. Define como combinar os resultados do pipeline |
| Objeto | Opcional. Contém um mapa de nomes de pipelines Se você não especificar um peso, o valor padrão será 1. |
| Boolean | Default is false. Specifies if |
Comportamento
Collections
Você só pode usar $rankFusion com uma única collection. Você não pode usar este estágio de agregação em um escopo de banco de dados .
De-Duplication
$rankFusion elimina a duplicação dos resultados em vários pipelines de entrada na saída final. Cada documento de entrada exclusivo aparece no máximo uma vez na saída $rankFusion, independentemente do número de vezes que o documento aparece nas saídas do pipeline de entrada.
Pipelines de Entrada
Cada pipeline input deve ser um pipeline de seleção e um pipeline classificado.
Pipeline de seleção
Um pipeline de seleção recupera um conjunto de documentos de uma coleção sem realizar nenhuma modificação após a recuperação. $rankFusion compara documentos em diferentes pipelines de entrada, o que exige que todos os pipelines de entrada gerem os mesmos documentos não modificados.
Observação
Se você quiser modificar os documentos que pesquisa com $rankFusion, execute essas modificações após o estágio $rankFusion.
Um pipeline de seleção deve conter apenas os seguintes estágios:
Tipo | Estágios |
|---|---|
Estágios de pesquisa |
Se você usar |
Estágios de pedidos | |
Estágios de paginação |
Pipeline classificado
Um pipeline classificado classifica ou solicita documentos. $rankFusion usa a ordem dos resultados classificados do pipeline para influenciar a classificação de saída. Os pipelines classificados devem atender a um dos seguintes critérios:
Comece com um dos seguintes estágios ordenados:
Conter um estágio
$sortexplícito.
Nomes de Pipeline de Entrada
Os nomes de pipeline em input devem atender às seguintes restrições:
Não deve ser uma string vazia
Não deve começar com um
$Não deve conter o delimitador de caracteres ASCII nulo
\0em qualquer lugar na stringNão deve conter um
.
Fórmula de fusão de classificação recíproca (RRF)
$rankFusion ordena resultados de acordo com a fórmula Reciprocal Post Fusion (RRF). Esse estágio coloca a pontuação de RRF para cada documento no campo de metadados score dos resultados de saída. A fórmula RRF classifica documentos com uma combinação dos seguintes fatores:
A colocação de documentos nos resultados do pipeline de entrada
O número de vezes que um documento aparece em diferentes pipelines de entrada
O
weightsdos pipelines de entrada.
Por exemplo, se um documento tiver uma classificação alta em vários conjuntos de resultados de pipeline, a pontuação de RRF para esse documento será maior do que se esse mesmo documento tivesse a mesma classificação em alguns pipelines de entrada, mas não estivesse presente (ou tivesse uma classificação inferior) nos outros pipelines
A fórmula Reciprocal Post Fusion (RRF) é equivalente à seguinte operação algebricamente:
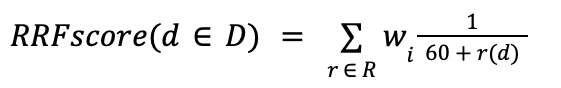
Observação
Nesta fórmula, 60 é um parâmetro de sensibilidade que o MongoDB determina.
A tabela abaixo contém as variáveis que a fórmula RRF utiliza:
Variável | Descrição |
|---|---|
D | O conjunto de documentos de resultado para toda a operação. |
d | O documento para o qual a pontuação RRF está sendo calculada. |
R | O conjunto de classificações para pipelines de entrada em que o |
r(d) | A classificação do documento |
w | O peso do pipeline de entrada em que |
Cada termo na soma representa a aparência de um documento d em um dos pipelines do input. A pontuação total de RRF para d é a soma de cada um desses termos em todos os pipelines de entrada em que d aparece.
Exemplo de cálculo de RRF
Considere um estágio de pipeline $rankFusion com um $search e um pipeline de entrada $vectorSearch.
Todos os pipelines de entrada geram os mesmos documentos 3: Document1, Document2 e Document3.
O pipeline $search classifica os documentos na seguinte ordem:
Document3Document2Document1
O pipeline $vectorSearch classifica os documentos na seguinte ordem:
Document1Document2Document3.
rankFusion calcula a pontuação RRF para Document1 por meio da seguinte operação:
RRFscore(Document1) = 1/(60 + search_rank_of_Document1) + (1/(60 + vectorSearch_rank_of_Document1)) RRFscore(Document1) = 1/63 + 1/61 RRFscore(Document1) = 0.0322664585
O campo de metadados score para Document1 é 0.0322664585.
detalhes da pontuação
Se você definir scoreDetails como true, $rankFusion criará um campo de metadados scoreDetails para cada documento. O campo scoreDetails contém informações sobre a classificação final.
Observação
Quando você define scoreDetails como true, $rankFusion define o campo de metadados scoreDetails para cada documento , mas não gera automaticamente o metacampo scoreDetails.
Para visualizar o campo de metadados scoreDetails, você deve:
usar um
$projectestágio após$rankFusionpara projetar o camposcoreDetailsuse um
$addFieldsestágio após$rankFusionpara adicionar o camposcoreDetailsà saída do pipeline
O campo scoreDetails contém os seguintes subcampos:
Campo | Descrição |
|---|---|
| O valor numérico da pontuação de RRF para este documento. |
| Uma descrição de como o |
| Uma array em que cada entrada da array contém informações sobre os pipelines de entrada que resultam neste documento. |
Cada entrada de array no campo details contém os seguintes subcampos:
Campo | Descrição |
|---|---|
| O nome do pipeline de entrada que gera este documento. |
| A classificação deste documento no pipeline de entrada. A classificação é |
| O peso do pipeline de entrada. |
| Opcional. Se o pipeline de entrada gerar um |
| Opcional. Se o pipeline de entrada gerar um campo |
| O campo |
Aviso
O MongoDB não garante nenhum formato de saída específico para scoreDetails.
Por exemplo, os seguintes blocos de código mostram o campo scoreDetails para uma operação $rankFusion com os pipelines de entrada $search, $vectorSearch e $match:
{ value: 0.030621785881252923, description: "value output by reciprocal rank fusion algorithm, computed as sum of weight * (1 / (60 + rank)) across input pipelines from which this document is output, from:" details: [ { inputPipelineName: 'search', rank: 2, weight: 1, value: 0.3876491287, description: "sum of:", details: [... omitted for brevity in this example ...] }, { inputPipelineName: 'vector', rank: 9, weight: 3, value: 0.7793490886688232, details: [ ] }, { inputPipelineName: 'match', rank: 10, weight: 1, details: [] } ] }
Explicação de resultados
O MongoDB converte operações de $rankFusion em um conjunto de estágios de agregação existentes que, em combinação, calculam o resultado de saída antes da execução da query. Os Resultados Explicados de uma operação $rankFusion mostram a execução completa dos estágios de agregação subjacentes que o $rankFusion usa para compor o resultado final.
Exemplos
Este exemplo utiliza uma coleção com incorporações e campos de texto. Crie search e vectorSearch índices de tipo na coleção.
The following index definition automatically indexes all the dynamically indexable fields in the collection for running $search queries against the indexed fields.
db.embedded_movies.createSearchIndex( "search_index", { mappings: { dynamic: true } } )
The following index definition indexes the field with the embeddings in the collection for running $vectorSearch queries against that field.
db.embedded_movies.createSearchIndex( "vector_index", "vectorSearch", { "fields": [ { "type": "vector", "path": "<FIELD_NAME>", "numDimensions": <NUMBER_OF_DIMENSIONS>, "similarity": "dotProduct" } ] } );
O seguinte pipeline de agregação utiliza $rankFusion com os seguintes pipelines de entrada:
Pipeline | Número de documentos devolvidos | Descrição |
|---|---|---|
| 20 | Executa uma pesquisa vetorial no campo indexado como tipo |
| 20 | Executa uma pesquisa de texto completo para o mesmo termo e limita os resultados a 20 documentos. |
1 db.embedded_movies.aggregate( [ 2 { 3 $rankFusion: { 4 input: { 5 pipelines: { 6 searchOne: [ 7 { 8 "$vectorSearch": { 9 "index": "<INDEX_NAME>", 10 "path": "<FIELD_NAME>", 11 "queryVector": <QUERY_EMBEDDINGS>, 12 "numCandidates": 500, 13 "limit": 20 14 } 15 } 16 ], 17 searchTwo: [ 18 { 19 "$search": { 20 "index": "<INDEX_NAME>", 21 "text": { 22 "query": "<QUERY_TERM>", 23 "path": "<FIELD_NAME>" 24 } 25 } 26 }, 27 { "$limit": 20 } 28 ], 29 } 30 } 31 } 32 }, 33 { $limit: 20 } 34 ] )
Esta operação executa as seguintes ações:
Executa os pipelines
inputCombina os resultados retornados
Gera os primeiros 20 documentos que são os 20 principais resultados classificados do
$rankFusionpipeline
Os exemplos de C# nesta página utilizam o banco de dados sample_mflix a partir dos conjuntos de dados de amostra do Atlas. Para saber como criar um cluster MongoDB Atlas gratuito e carregar os conjuntos de dados de exemplo, consulte Introdução na documentação do driver MongoDB .NET/C#.
A seguinte classe Movie modela os documentos na collection sample_mflix.movies:
public class Movie { public ObjectId Id { get; set; } public int Runtime { get; set; } public string Title { get; set; } public string Rated { get; set; } public List<string> Genres { get; set; } public string Plot { get; set; } public ImdbData Imdb { get; set; } public int Year { get; set; } public int Index { get; set; } public string[] Comments { get; set; } [] public DateTime LastUpdated { get; set; } }
Observação
ConventionPack para Pascal Case
As classes C# nesta página usam Pascal case para seus nomes de propriedade, mas os nomes de campo na coleção MongoDB usam Camel case. Para considerar essa diferença, você pode usar o seguinte código para registrar um ConventionPack quando o aplicativo iniciar:
var camelCaseConvention = new ConventionPack { new CamelCaseElementNameConvention() }; ConventionRegistry.Register("CamelCase", camelCaseConvention, type => true);
To use the MongoDB .NET/C# driver to add a $rankFusion stage to an aggregation pipeline, call the Unwind() method on a PipelineDefinition object.
Antes de executar o exemplo a seguir, você deve criar um índice do MongoDB Search chamado default. Inclua o seguinte código em seu aplicativo para criar um índice de pesquisa na coleção movies:
var collection = client.GetDatabase("sample_mflix").GetCollection<Movie>("movies"); var index = new BsonDocument { { "mappings", new BsonDocument { { "dynamic", true } } } }; collection.SearchIndexes.CreateOne(index, "default");
The following example creates a pipeline stage that executes two pipelines, searchPlot and searchGenre, that perform $search operations by using the default search index. The $rankFusion stage then ranks the search results based on each $search pipeline's assigned weight and returns the ordered results. The pipeline includes the scoreDetails field in the return documents by enabling the ScoreDetails option in the RankFusionOptions instance passed to the RankFusion() method.
var searchPipelines = new Dictionary<string, PipelineDefinition<Movie, Movie>> { { "searchPlot", new EmptyPipelineDefinition<Movie>() .Search( Builders<Movie>.Search.Text(Builders<Movie>.SearchPath.Single(m => m.Plot), "space")) }, { "searchGenre", new EmptyPipelineDefinition<Movie>() .Search( Builders<Movie>.Search.Text(Builders<Movie>.SearchPath.Single(m => m.Genres), "adventure")) } }; var weights = new Dictionary<string, double> { { "searchPlot", 0.4 }, { "searchGenre", 0.6 } }; var pipeline = new EmptyPipelineDefinition<Movie>() .RankFusion(searchPipelines, weights, new RankFusionOptions<Movie> { ScoreDetails = true });
Os exemplos do Node.js nesta página utilizam o banco de dados do sample_mflix a partir dos conjuntos de dados de amostra do Atlas. Para saber como criar um cluster gratuito do MongoDB Atlas e carregar os conjuntos de dados de exemplo, consulte Introdução na documentação do driver do MongoDB Node.js
Para usar o driver Node.js do MongoDB para adicionar um estágio $rankFusion a um pipeline de agregação , use o operador $rankFusion em um objeto de pipeline.
Antes de executar o exemplo a seguir, você deve criar um índice do MongoDB Search chamado default. Inclua o seguinte código em seu aplicativo para criar um índice de pesquisa na coleção movies:
const index = { name: "default", definition: { mappings: { dynamic: true } } } const result = collection.createSearchIndex(index);
The following example creates a pipeline stage that executes two pipelines, searchPlot and searchGenre, that perform $search operations by using the default search index. The $rankFusion stage then ranks the search results based on each $search pipeline's assigned weight and returns the ordered results. The $addFields stage includes the scoreDetails field in the return documents. The example then runs the aggregation pipeline:
const pipeline = [ { $rankFusion: { input: { pipelines: { searchPlot: [ { $search: { index: "default", text: { query: "space", path: "plot"} } } ], searchGenre: [ { $search: { index: "default", text: { query: "adventure", path: "genres" } } } ] } }, combination: { weights: {searchPlot: 0.6, searchGenre: 0.4} }, scoreDetails: true } }, { $addFields: { scoreDetails: { $meta: "searchScoreDetails" } } } ]; const cursor = collection.aggregate(pipeline); return cursor;