Casos de uso: gerenciamento de conteúdo, IA da geração
Setores: mídia, telecomunicações
Produtos e ferramentas: MongoDB Atlas, MongoDB Atlas Vector Search
Parceiros: Amazon Bedrock
Visão Geral da Solução
As equipes de conteúdo enfrentam uma pressão crescente para produzir conteúdo envolvente e credível em um ambiente noticioso de fluxo rápido. Os métodos tradicionais geralmente levam ao esgotamento criador e à perda de oportunidades, em vez da criação de conteúdo, devido ao tempo gasto em pesquisa manual, verificação de fonte e gerenciamento de ferramentas. Com o MongoDB, você pode combinar a IA generativa com a infraestrutura de dados adaptável do MongoDB para otimizar as operações editoriais. Para ajudá-lo a testar esses recursos, fornecemos a demonstração do Laboratório de conteúdo, uma solução que você pode replicar.
A demonstração do Content Device simplifica os fluxos de trabalho editoriais e permite:
Ingestão e estrutura de conteúdo diversos: esta demonstração processa eficientemente altos volumes de conteúdo não estruturado e semiestruturado de várias fontes, organizando-o dinamicamente por tópico, setor e metadados de origem.
Permita a descoberta e o rascunho com base em IA: os modelos de incorporação e o MongoDB Atlas Vector Search transformam o conteúdo bruto em dados estruturados e pesquisáveis. Essa combinação permite a recuperação semântica de tópicos do momento e automatiza a redação de conteúdo, reduzindo o esgotamento criador.
Melhorar a credenciais do conteúdo: esta demonstração captura e armazena URLs de origem, que são incorporados diretamente às sugestões de tópico. A integração com agentes de pesquisa externos agrega ainda mais sugestões de conteúdo com informações contextuais.
Facilite a personalização e aumente a eficiência do fluxo de trabalho: esta demonstração processa o perfil do usuário para fornecer sugestões de escrita personalizadas e armazena rascunhos para controle de versão e reutilização. O esquema flexível do MongoDB torna isso possível ao adaptar-se sem esforço à evolução dos dados de perfil, aos formatos de rascunhos e aos novos tipos de conteúdo sem interromper o fluxo de trabalho.

figura 1. Diagrama de fluxo de experiência do usuário
Ao fornecer uma solução de armazenamento unificada, insights em tempo real e assistência automatizada de conteúdo, esta demonstração mostra como o MongoDB ajuda as equipes editoriais a reduzir a complexidade, melhorar a qualidade do conteúdo e acelerar a produção. Ele oferece aos editores um caminho claro da ideia à publicação.
Arquitetura de referência
A demonstração do ContentLab fornece uma ferramenta de publicação orientada por IA que combina a Gen AI com a infraestrutura de dados flexível do MongoDB para simplificar as operações editoriais. A arquitetura é projetada como um microsserviço para:
Lidar com a ingestão de conteúdo diverso
Impulsione a descoberta e o rascunho com base em IA
Aumentar a credenciais do conteúdo
Oferece suporte à personalização e à eficiência do fluxo de trabalho
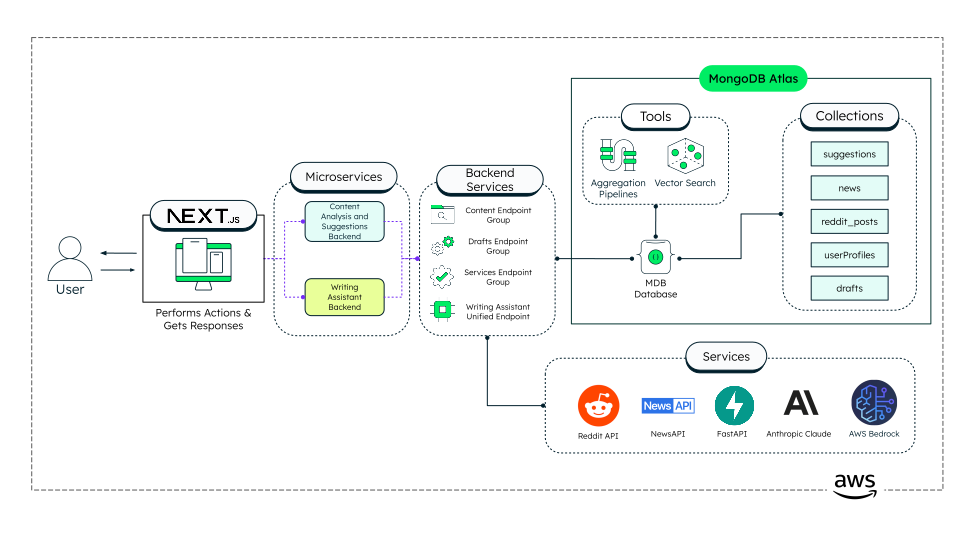
figura 2. Arquitetura de alto nível da demonstração do Content Device
Essa arquitetura usa os seguintes componentes:
Interface do usuário (UI): os usuários interagem com o sistema por meio de uma interface do usuário que fornece recursos como sugestões de tópicos, rascunho de FERRAMENTAS e gerenciamento de rascunhos.
Serviços de backend: esses microsserviços lidam com diferentes funções da demonstração, incluindo:
Análise de conteúdo e backend de sugestões: esse serviço processa notícias e dados do Reddit, transformando conteúdo em vetores semânticas por meio de modelos de incorporação como o Cohere-embed. Esses vetores podem ser processados com o Atlas Vector Search para fornecer sugestões de tópicos em tempo real. O microsserviço tem estes componentes principais:
Agendador e orquestração: esse serviço automatiza os fluxos de trabalho de ingestão, geração de incorporação e sugestão de tópicos diariamente.
Função: esse serviço fornece assistência e personalização à escrita downstream para o microsserviço do assistente de escrita usando pesquisa e recuperação semântica.
Abaixo, você pode encontrar um diagrama de visão geral de alto nível deste microsserviço.

figura 3. Arquitetura de alto nível do backend de conteúdo e sugestões
clique para ampliarBackend do assistente de escrita: esse serviço fornece FERRAMENTAS para publicação, que inclui descrição de rascunhos, revisão, refinamento de conteúdo e conclusão de chat. Esses FERRAMENTAS usam LLMs como o Agroupy.
MongoDB Atlas: o Atlas serve como o principal armazenamento de dados, fornecendo recursos de pesquisa semântica, armazenamento de banco de dados e pipelines de agregação para processamento e recuperação eficientes.
Abordagem do modelo de dados
Esta demonstração usa o seguinte design de modelo de documento e coleções para armazenar conteúdo.
A demonstração do Laboratório de conteúdo contém cinco collections principais:
userProfilereddit_postsnewssuggestionsdrafts
A coleção userProfile armazena preferências individuais do usuário para personalizar sugestões personalizadas orientadas por IA. Essas preferências incluem:
persona: o tipo de gravador que o usuário pode escolher.tone: o tom desejado que o usuário pode escolher, por exemplo, causal, oficial ou semiformal.styleTraits: As características predefinidas do gravador.sampleText: Uma frase de exemplo de um escritor.
Esse esquema segue o princípio de design do MongoDB de que dados acessados com frequência juntos são armazenados juntos, permitindo que o assistente de escrita recupere rapidamente as recomendações do usuário. Um documento de amostra é mostrado abaixo.
{ "_id": { "$oid": "6862a8988c0f7bf43af995a8" }, "persona": "The Formal Expert", "userName": "Mark S.", "tone": "Polished, academic, appeals to professionals and older readers", "styleTraits": [ "Long, structured paragraphs", "Formal language with rich vocabulary", "Analytical, often includes references or citations" ], "sampleText": "This development represents..."}As collections reddit_posts e news armazenam dados brutos ingeridos de suas respectivas APIs. Esses documentos são ainda enriquecidos com incorporações, que são representações numéricas do significado do conteúdo que permitem a pesquisa semântica.
A coleção suggestions contém os tópicos sugeridos a partir dos dados reddit_posts e news processados. A interface do usuário pode encontrar facilmente esses documentos e usá-los para a seleção de tópicos. Um documento de amostra é mostrado abaixo.
{ "_id": { "$oid": "686fb23055303796c4f37b7e" }, "topic": "Backlash against generative AI", "keywords": [ "algorithmic bias", "data privacy", "AI regulation", "public trust" ], "description": "As generative AI tools like ChatGPT proliferate, a growing public backlash highlights concerns over their negative impacts and the need for stronger oversight.", "label": "technology", "url": "https://www.wired.com/story/generative-ai-backlash/", "type": "news_analysis", "analyzed_at": { "$date": "2025-07-10T12:29:36.277Z" }, "source_query": "Viral social media content"}Finalmente, a coleção drafts armazena os rascunhos dos usuários. Cada rascunho está associado a um tópico sugerido, permitindo fácil organização e recuperação. Esse modelo garante persistência, controle de versão e reutilização de conteúdo para fluxos de trabalho editoriais.
Construir a solução
Você pode replicar esta demonstração seguindo estas etapas:
Repositórios de fork e clone
Faça uma bifurcação e clone o backend #1, o backend #2 e os repositórios de frontend para sua conta do Github.
Provisionar MongoDB Atlas
Dentro de sua conta MongoDB Atlas, crie um cluster e um banco de dados denominado contentlab com estas coleções:
drafts: Armazene documentos de rascunho criados pelo usuárionews: Armazene artigos de notícias raspados com incorporações.reddit_posts: Armazene publicações e comentários do Reddit com incorporações.suggestions: Armazene sugestões de tópicos geradas por IA.userProfiles: armazena informações e preferências do perfil do usuário.
Instalar dependências e executar serviços
Instale e inicie ambos os serviços de backend nas portas 8000 e 8001. Em seguida, instale as dependências frontend e inicie o servidor de desenvolvimento em http://localhost:.3000
Principais Aprendizados
Adaptar modelos de dados com o esquema flexível do MongoDB: com o MongoDB, você pode adicionar novos campos ou adaptar os existentes - como metadados personalizados, resumos e históricos de versões - em suas collections, sem tempo de inatividade ou migrações complexas.
Integre o Atlas Vector Search para uma descoberta significativa: com o MongoDB, você pode armazenar incorporações de várias APIs em suas respectivas coleções e, em seguida, executar consultas de similaridade para revelar tópicos relevantes em segundos.
Garanta a confiança Editorial rastreando as fontes de conteúdo: com o MongoDB, você pode armazenar URLs de origem e metadados juntamente com sugestões, facilitando a verificação das origens e preservando a autoridade nos rascunhos.
Mantenha um fluxo constante de ideias automatizando seu pipeline: com o MongoDB, você pode agendar tarefas diárias para coletar notícias, processar incorporações e gerar sugestões que garantem recomendações de tópicos atualizadas.
Autores
Aswin Subramanian Maesvaran, MongoDB
Felipe Trejos, MongoDB
Saiba mais
Para entender como o Atlas Vector Search aprimora a pesquisa semântica e habilita a análise em tempo real, visite a página do Atlas Vector Search.
Para saber como o MongoDB está transformando as operações de mídia, leia o artigo Personalização de mídia alimentada por IA: MongoDB e Vector Search.
Para descobrir como o MongoDB oferece suporte a fluxos de trabalho de mídia modernos, visite a página MongoDB para mídia e entretenimento.