Monitore a topologia da grade, preveja a demanda com dados meteorológicos, analise clientes e query tudo por meio de um agente de suporte de grade no MongoDB Atlas.
Casos de uso: Pesquisa inteligente, IoT
Setores: Manufatura e mobilidade, gerenciamento de energia
Produtos e ferramentas: MongoDB Atlas, MongoDB pesquisa vetorial, MongoDB coleções de séries temporais, Voyage AI by MongoDB
Parceiros: Anthropic, LangChain
Visão Geral da Solução
As empresas de serviços públicos coletam dados de medidores inteligentes de alta frequência em escala, mas as equipes geralmente ainda gerenciam monitoramento, previsão, análise de clientes e fluxos de trabalho de IA em sistemas separados.
Essa fragmentação cria pipelines de dados duplicados, decisões mais lentas e custos operacionais mais altos.
A Plataforma Inteligente Smart Grid mostra como você pode executar essas cargas de trabalho no MongoDB Atlas usando uma camada de dados operacionais para monitoramento em tempo real, operações de rede, previsão de demanda, inteligência do cliente e um agente de suporte de rede.
Use esta solução para:
Monitorar a rede em tempo real: detectar interrupções, acompanhar o fator de potência e sinalizar anomalias (picos de tensão, consumo incomum) diretamente no banco de dados.
Operar a rede: visualize a topologia da grade (utilitário → subestação → alimentador → transformador), pontue a integridade da subestação e avise sobre picos de carga e risco de interrupção da utilização da capacidade em tempo real.
Previsão de demanda com o clima: projete a demanda esperada e o tempo de pico por região, enriquecido com dados climáticos externos (dias de aquecimento e resfriamento), para planejar a capacidade e evitar sobrecargas.
Entenda os clientes: recomendações de tarifas de superfície, tendências de consumo, detalhamentos de nível de eletrodomésticos e segmentos de uso dos mesmos dados do medidor.
Aja por meio da linguagem natural: query a grade, a rede, a Base de Conhecimento e os dados do cliente por meio de um agente de suporte de grade.
O MongoDB Atlas oferece suporte a esse design com funcionalidade integrada para dados de série temporal, modelagem de dados flexível, processamento no banco de dados e recuperação com tecnologia de IA:
MongoDB Atlas Time Series: coleções de séries temporais nativas armazenam leituras de medidores de alta frequência com eficiência e alimentam query temporais rápidas.
Aggregation Framework: análise executada no banco de dados, não no aplicativo, detecção de interrupções de lacunas e ilhas com
$setWindowFields, estatísticas de anomalias e demanda com$groupe$stdDevSamp, e utilização de alimentador/subestação medida em relação à capacidade nominal de cada ativo. As leituras de alta frequência (demanda, previsão) são executadas como uma varredura de coleção única sobre leituras que já carregam seu contexto de grade.Flexible document model: medidores, clientes e a hierarquia da rede vivem como documentos relacionados, unidos sob demanda, sem esquema rígido para migrar à medida que a rede evolui.
Atlas Vector Search com embeddings automatizados do Voyage AI: pesquisa semântica em uma Base de Conhecimento de domínio sem um serviço de embedding separado para operar. Consulte Voyage AI
Pesquisa híbrida: resultados vetoriais e de texto completo combinados com Reciprocal Rank Fusion (RRF) para recuperação mais relevante.
IA Agentic no MongoDB: um assistente multiagente LangGraph com habilidades por domínio e memória de conversação persistidas no Atlas, para que o contexto seja armazenado junto com os dados operacionais, sem armazenamento de estado externo.
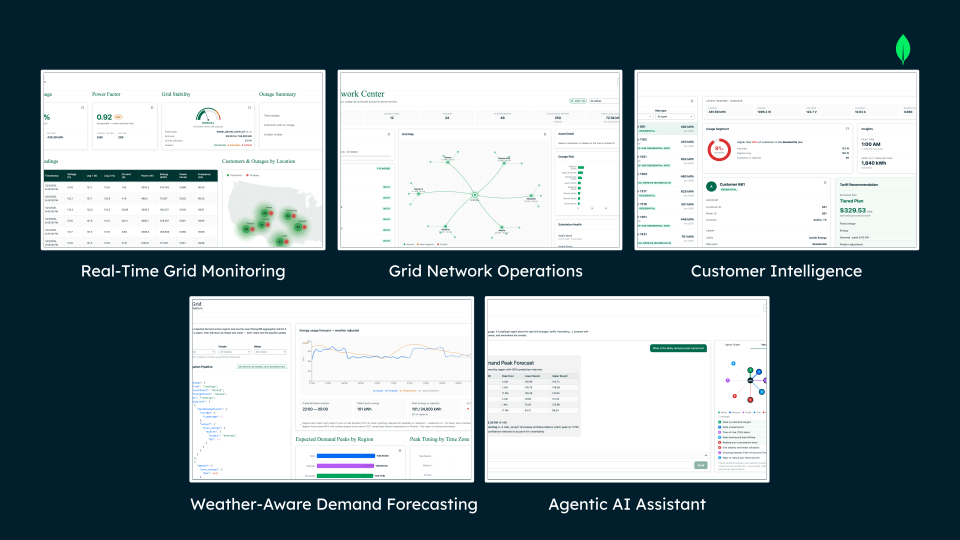
Figura 1. Principais recursos da plataforma inteligente Smart Grid
Arquiteturas de referência
A plataforma combina as seguintes camadas em um único cluster MongoDB Atlas:
Uma camada de dados operacional que alimenta as visualizações de monitoramento, rede, previsão e cliente.
Uma camada de IA agentiva que permite aos usuários query tudo em linguagem natural.
Ambos lêem os mesmos documentos, portanto, você não precisa de sistemas separados para copiar ou sincronizar informações.

Figura 2. Arquitetura de Smart Grid de alto nível - Camada de dados operacionais
Camada de dados operacionais
As leituras de rede inteligente chegam a uma coleção de séries temporais, o Aggregation Framework calcula análises no banco de dados e os resultados alimentam as visualizações de monitoramento, rede, previsão e cliente.
Veja como os dados fluem pela arquitetura:
Ingestão (série temporal): leituras de medidores inteligentes de alta frequência (tensão, corrente, potência, energia, fator de potência e subcargas de nível de aparelho) são armazenadas na coleção de séries temporais
readingsAtlas, otimizadas para query temporais rápidas em escala.Modelo de topologia de grade: A hierarquia de grade (utilitário → subestação → alimentador → transformador, com capacidade) reside na coleção
network, emeter_network_mapvincula cada medidor ao seu alimentador. Como o modelo é flexível, a topologia pode evoluir sem migrações de esquema.Em processamento no banco de dados (framework de agregação): cada visualização é alimentada por um pipeline de agregação que executar onde os dados estão localizados:
Monitoramento: detecção de interrupções com
$setWindowFieldse$shift(lacunas e ilhas), detecção de anomalias por medidor com$stdDevSamp(N-sigma) e rastreamento do fator de potência.Centro de rede: soma a carga ativa de cada alimentador e a compara com a capacidade nominal do ativo_kw para calcular a utilização, depois deriva pontuações de integridade da subestação, avisos de carga de pico e risco de interrupção em toda a hierarquia de utilitário → subestação → alimentador → transformador.
Previsão: demanda esperada e seu intervalo de previsão por região/hora com
$group+$avge$stdDevSamp, projetados para frente por um modelo sazonal (hora do dia e dia da semana) e enriquecidos com clima externo (dias de aquecimento/resfriamento), além de uma visualização de tempo de pico.Clientes: recomendações de tarifas contra
tariff_catalog, além de insights, avarias de eletrodomésticos, segmentos de uso e tendências de consumo.
Enriquecimento externo: a carga de trabalho de previsão chama a API meteorológica Open-Meteo para temperaturas horárias por região, que o pipeline transforma em recurso de grau-dia para que as previsões de demanda reflitam as condições climáticas reais.
Apresentação: um aplicativo Next.js (App Router) expõe cada pipeline por meio de rotas de API e renderiza os resultados como dashboards ao vivo. Cada cartão inclui uma visualização "Mostrar documento" que revela os documentos subjacentes e o pipeline de agregação exato por trás dele.
Por que isso é importante: monitoramento, operações de rede, previsão e inteligência do cliente leem dos mesmos documentos operacionais. O Aggregation Framework substitui um mecanismo de análise separado, e o document model flexível mantém medidores, clientes e a hierarquia de grade em evolução juntos, para que a plataforma seja dimensionada sem copiar ou reconciliar dados entre os sistemas.
Agentic AI Layer
A pergunta em linguagem natural de um usuário flui por um orquestrador multiagente LangGraph que raciocina sobre a pergunta, chama as ferramentas certas, recupera dados do MongoDB e retorna uma resposta fundamentada. Tudo isso enquanto sua memória de conversa e dados de pesquisa vivem no mesmo cluster do Atlas.

Figura 3. Orquestração LLM de alto nível - Camada de IA Agentic
Veja como uma query flui pela arquitetura:
Query do usuário (Interface): Um usuário faz uma pergunta em linguagem natural ao agente de suporte da grade. A interface envia a solicitação (Solicitação:
<user query>) ao agente e, posteriormente, renderiza a resposta (Resposta:<answer>).Percepção: O agente percebe seu mundo como documentos do MongoDB, a query do usuário além dos dados operacionais armazenados como JSON nas coleções da plataforma. Este é o contexto sobre o qual o agente raciocina.
Planejamento: o orquestrador LangGraph interpreta a solicitação, a roteia para o fluxo de trabalho de domínio correto, chama as ferramentas necessárias e retorna uma resposta fundamentada.
FERRAMENTAS: o agente executa as ferramentas selecionadas:
Pesquisa híbrida (RAG) sobre a base de conhecimento: pesquisa vetorial (semântica) e pesquisa de texto completo (palavra-chave) fundidas com Reciprocal Rank Fusion (RRF) para as passagens mais relevantes.
Recuperação de dados: Agregações do MongoDB sobre as coleções operacionais (rede, rede, clientes, tarifas) para responder com dados em tempo real.
Memória: o estado da conversa é mantido no MongoDB Atlas (
agent_checkpoints,agent_checkpoint_writes), para que o agente se lembre do contexto em todas as voltas sem um armazenamento de estado externo.Raciocínio e geração (Orquestração): a camada de orquestração LangGraph coordena o loop, e o LLM (Claude) raciocina sobre o contexto recuperado e sintetiza a resposta final, que é retornada ao usuário.
Reunindo tudo: a camada de IA não duplica a lógica, suas ferramentas de recuperação de dados chamam as mesmas agregações que alimentam os dashboards operacionais, e ambas as camadas compartilham um cluster do Atlas para dados, pesquisa e memória do agente.
Abordagem do modelo de dados
Esta solução executa monitoramento, operações de rede, previsão, inteligência do cliente e um agente de suporte de grade em uma única camada de dados do MongoDB Atlas.
O document model do MongoDB torna isso possível organizando dados operacionais, de pesquisa e de memória em coleções flexíveis que permanecem conectadas sem exigir sistemas separados para armazenar, sincronizar ou reconciliar informações.
Esta solução é criada em um conjunto de coleções MongoDB que trabalham juntas para oferecer suporte a cargas de trabalho operacionais e funcionalidade de IA:
readingsarmazenar dados de série temporal do medidor.customer_db,network,meter_network_mapetariff_catalogarmazenam os principais dados do cliente, da grade, do mapeamento e da tarifa.agent_checkpointseagent_checkpoint_writespersistir a memória do agente.kb_articlespotencializa a pesquisa de IA sobre a base de conhecimento.
Juntas, essas coleções fornecem uma camada de dados conectada para monitoramento, análise e interações inteligentes do usuário. As seções a seguir descrevem cada coleção em mais detalhes e explicam como sua estrutura oferece suporte à solução geral
readings: Armazena uma leitura de medidor por intervalo, medições elétricas, subcargas de nível de aparelho, consumo de intervalo pré-calculado (interval_kwh) e seu contexto de grade desnormalizado (alimentador/subestação/utilitário), em uma coleção de séries temporais.
{ "timestamp": { "$date": "2026-07-08T17:00:00.000Z" }, "dataid": 661, "power_factor": 0.933, "city": "Austin", "frequency": 60.043, "voltage": 119.958, "energy": 53.76054, "feeder_id": "feeder_austin_south_02", "kitchen_power": 168.8, "power": 3246.151, "env_power": 1112.159, "heating_power": 344.741, "utility_id": "utility_austin", "laundry_power": 61.352, "current": 29.004, "_id": { "$oid": "6a760c8ee48b9c05164d7d57" }, "avg_reading": 119.958, "interval_kwh": 0.81154, "ev_power": 0, "volt_leg_1": 118.982, "has_ev": true, "transformer_id": "transformer_austin_south_02_01", "hvac_power": 1559.099, "substation_id": "substation_austin_south", "volt_leg_2": 120.934, "state": "Texas" }
network: Modela a hierarquia de utilitários como documentos vinculados.parent_asset_idforma a hierarquia de utilitário → subestação → alimentador → transformador, e cada ativo carrega sua própria capacidade e localização.
{ "_id": { "$oid": "6a43f5a0fc0d1c3b5276bb29" }, "asset_id": "transformer_austin_south_02_02", "asset_type": "transformer", "city": "Austin", "state": "TX", "name": "Austin South Transformer 02-02", "parent_asset_id": "feeder_austin_south_02", "capacity_kw": 1500, "voltage_kv": 0.48, "status": "active", "location": { "type": "Point", "coordinates": [ -97.7131, 30.263199999999998 ] } }
tariff_catalog: Armazena planos de tarifas com suas faixas de tier incorporadas como um array, para que um plano completo seja lido como um documento.
{ "_id": { "$oid": "6a760c89e48b9c05164d7d4c" }, "utilityName": "Austin Energy", "rateName": "Residential", "fixedChargeFirstMeter": 15, "fixedChargeUnits": "$/month", "energyRateStrux": [ { "energyRateTiers": [ { "max": 300, "unit": "kWh", "rate": 0.04106, "adj": 0.06455 }, { "max": 900, "unit": "kWh", "rate": 0.05138, "adj": 0.06455 }, { "max": 2000, "unit": "kWh", "rate": 0.07525, "adj": 0.06455 }, { "unit": "kWh", "rate": 0.10884, "adj": 0.06455 } ] } ], "energyWeekdaySched": [... ], "energyWeekendSched": [... ], "effectiveDate": { "$date": "2025-05-01T00:00:00.000Z" }, "sourceReference": "https://austinenergy.com/-/media/project/websites/shared/pdfs/rates/tariff.pdf?rev=382867d1201343b78d6a940e4ef471b5&hash=51DA5A20032359FB44C3F61BFB5E7F5E", "rate_type": "tiered", "city": "Austin", "state": "TX", "location_label": "Austin, TX" }
kb_articles: Armazena a Base de Conhecimento do domínio, com índice para Atlas Vector Search (com embedding automatizado do Voyage AI) e pesquisa de texto completo. O Atlas gera embedding a partir do campo de texto sem um pipeline de embedding separado.
{ "_id": { "$oid": "6a711e3759c1cc549f2e8c42" }, "slug": "what-is-power-factor", "category": "Glossary", "text": "Power factor is the ratio of real power (kW, the power that does useful work) to apparent power (kVA, the total power drawn). It ranges from 0 to 1. A power factor near 1.0 means electricity is being used efficiently; a low power factor (for example below 0.9) means a lot of reactive power is being drawn, which stresses the grid and can incur penalties for commercial customers. Motors, transformers, and other inductive loads lower the power factor.", "title": "What is power factor?", "updatedAt": { "$date": "2026-08-04T19:30:01.654Z" } }
meter_network_map: Mapeia cada medidor (dataid) para seu lugar na topologia da grade (alimentador, subestação, utilitário e transformador). Esse mesmo contexto também é desnormalizado em cada leitura, para que as visualizações de alta frequência o leiam sem uma junção.customer_db: Armazena a localização de cada cliente (cidade e estado), com chave pelo medidordataid. O plano de tarifas e o segmento de uso são derivados sob demanda (detariff_cataloge por agregação).agent_checkpointseagent_checkpoint_writes: armazena a memória do agente, gerenciada pelo LangGraph, onde o estado da conversa do assistente é persistido por thread para que o contexto sobreviva entre as voltas, sem armazenamento de estado externo.
Por que o document model se encaixa nesta solução:
Cada leitura carrega tudo sobre aquele momento: uma leitura do medidor incorpora suas medições elétricas e suas subcargas no nível do aparelho em um documento, sem junções para reconstruir uma única leitura. Armazenadas em uma coleção de séries temporais, elas ingerem e query com eficiência em alta frequência.
A hierarquia da grade é modelada como existe: A rede (utilitário → subestação → alimentador → transformador) é armazenada como documentos vinculados que a plataforma percorre para montar visualizações de topologia, e cada leitura carrega seu lugar nessa hierarquia, para que o modelo possa crescer ou mudar sem migrações de esquema.
O esquema evolui sem migrações: novas subcargas de eletrodomésticos, atributos de clientes ou campos de ativos podem ser adicionados como novos campos, para que os documentos, pipelines e fluxos de trabalho de aplicativos existentes continuem funcionando à medida que a plataforma se expande.
Os mesmos dados suportam todas as cargas de trabalho: as agregações por trás do monitoramento, previsão e dashboards de clientes são executadas nas mesmas coleções operacionais que suportam junções em todo o modelo de grade, o que reduz a duplicação e evita sistemas separados.
Os dados de IA vivem com dados operacionais: a base de conhecimento, a pesquisa vetorial e de texto completo e a memória de conversa do agente vivem no mesmo cluster do MongoDB Atlas, para que a recuperação, o contexto de raciocínio e a análise operacional funcionem juntos sem infraestrutura separada.
Construir a solução
A Plataforma Inteligente Smart Grid usa o MongoDB Atlas como uma única camada de dados para monitoramento em tempo real, operações de rede, previsão de demanda, inteligência do cliente e um agente de suporte de rede.
Siga estas etapas de alto nível para implementar a solução. Para obter instruções de configuração detalhadas, dados de exemplo e código executável, consulte o repositório do GitHub.
Configure seu ambiente.
Instale os pré-requisitos (Node.js para o frontend Next.js, Python com uv para o backend).
Crie um cluster do MongoDB Atlas (M10 ou superior, necessário para Atlas Vector Search com embedding automatizado).
Obtenha uma chave de API do Voyage AI e uma chave de API da Anthropic (o agente de suporte da grade usa o Claude).
Configure as variáveis de ambiente para o URI de conexão MongoDB, nomes de banco de dados e coleções e as credenciais da API.
Configurar seu banco de dados.
Provisione o modelo de dados e os dados de suporte necessários para fluxos de trabalho operacionais, de rede, de clientes, de preços e de base de conhecimento.
Ative as funcionalidades de indexação e recuperação necessárias para oferecer suporte à análise de grade e pesquisa híbrida.
Base de Conhecimento de sementes.
Carregue os artigos da Base de Conhecimento do domínio.
Habilite o Atlas Vector Search com embedding automatizado do Voyage AI, para que os embedding sejam gerados no banco de dados.
Habilite a pesquisa de texto completo para oferecer suporte à recuperação híbrida (vetor + palavra-chave).
Implante seu aplicativo.
Inicie o frontend do Next.js.
Ative o monitoramento em tempo real, rede, previsão e dashboards de clientes, cada um alimentado por pipelines de agregação do MongoDB.
Ative o agente de suporte de grade (orquestração LangGraph, pesquisa híbrida e memória de conversação persistida no Atlas).
Explore a plataforma em http://localhost:.3000
Principais Aprendizados
Consolidar operações em uma única plataforma de dados: a execução de monitoramento, operações de rede, previsão e inteligência do cliente em um cluster do MongoDB Atlas remove o custo e o atraso da cópia e reconciliação de dados de medidores em sistemas separados. Essa abordagem reduz o custo total de propriedade e leva novas funcionalidades à produção mais rapidamente.
Transforme dados brutos do medidor em decisões operacionais: Calcule interrupções, utilização da capacidade e anomalias diretamente nos pipelines de agregação para que os operadores possam agir nas condições da rede em tempo real. Isso reduz o tempo de inatividade e evita sobrecargas antes que elas se transformem em falhas.
Planeje a capacidade com previsão com reconhecimento do tempo: enriqueça as previsões de demanda com dados meteorológicos externos (incluindo dias de grau de aquecimento e resfriamento) para ajudar as concessionárias a antecipar picos e alocar capacidade proativamente. Isso reduz a resposta de emergência dispendiosa e melhora a confiabilidade da rede.
Melhore os resultados do cliente com inteligência unificada: sirva recomendações de tarifas, tendências de consumo e segmentos de uso a partir dos mesmos dados de medidor para ajudar as concessionárias a envolver os clientes com orientações relevantes e personalizadas. Isso apoia a satisfação e a retenção.
Capacite as equipes com IA de agente no MongoDB: Use um assistente multiagente LangGraph para permitir que qualquer operador query a grade, a rede e os clientes em linguagem natural. Isso democratiza o acesso aos dados e acelera as decisões sem esperar por relatórios ou analistas especializados.
Autores
Muhammad Atif
Andrea Fatima Figueroa Lopez
Maria José Cordova Igartua
Javier Guajardo Canseco
Andrea Alaman Calderon