읽기 기본 설정은 MongoDB 클라이언트가 복제본 세트 노드에 읽기 작업을 어떻게 라우팅하는지 설명합니다.
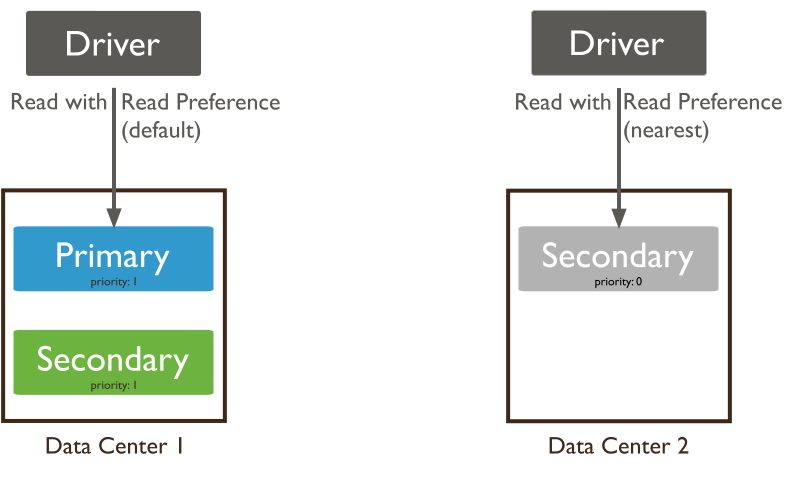
기본적으로 애플리케이션은 읽기 작업을 복제본 세트의 프라이머리 멤버(즉, 읽기 설정 모드 'primary')로 지시합니다. 하지만 클라이언트는 읽기 작업을 세컨더리로 전송하도록 읽기 설정을 지정할 수 있습니다.
Read preference consists of the read preference mode and optionally, a tag set list, the maxStalenessSeconds option, and the hedged read option. Hedged read option is available for sharded clusters for reads that use non-primary read preference.
읽기 설정 모드
다음 표에는 읽기 설정 모드에 대한 간략한 요약이 나열되어 있습니다.
참고
primary가 아닌 읽기 설정 (read preference) 모드는 샤딩된 클러스터에서 헤지된 읽기(hedged read)를 지원합니다.
읽기 설정 모드 | 설명 |
|---|---|
기본 모드. 모든 작업은 현재 복제본 세트 프라이머리에서 읽습니다. 읽기 작업이 포함된 트랜잭션 은 읽기 설정 (read preference) | |
대부분의 경우 작업은 프라이머리 노드에서 읽지만, 프라이머리 노드를 사용할 수 없는 경우 세컨더리 노드에서 읽습니다. Read preference | |
모든 작업은 복제본 세트의 세컨더리 멤버에서 읽습니다. 읽기 설정(read preference) | |
작업은 일반적으로 복제본 세트의 세컨더리 노드에서 데이터를 읽습니다. 만약 복제본 세트에 프라이머리 노드가 하나만 있고 다른 노드가 없다면, 작업은 프라이머리 노드에서 데이터를 읽습니다. Read preference | |
작업은 지정된 지연 시간 임계값에 따라 프라이머리 멤버든 세컨더리 멤버든 상관없이 임의의 적격 복제본 세트 멤버에서 읽습니다. 이 작업은 지연 시간을 계산할 때 다음 사항을 고려합니다.
Read preference |
For detailed description of the read preference modes, see Read Preference Modes.
행동
All read preference modes except
primarymay return stale data because secondaries replicate operations from the primary in an asynchronous process. [1] Ensure that your application can tolerate stale data if you choose to use a non-primarymode.읽기 기본 설정은 데이터의 가시성에 영향을 주지 않습니다. 클라이언트는 쓰기 결과가 확인되거나 과반수의 복제본 세트 노드에 전파되기 전에 쓰기 결과를 볼 수 있습니다. 자세한 내용은 격리, 일관성 및 최신성(Recency) 읽기를 참조하세요.
읽기 설정은 인과적 일관성에 영향을 미치지 않습니다.
"majority"읽기 고려가 있는 읽기 작업과"majority"쓰기 고려가 쓰기 작업에 대해 인과적으로 일관성이 있는 세션을 제공하는 인과적 일관성 보장은 MongoDB deployment의 모든 멤버에 걸쳐 유지됩니다.
경고
마이그레이션이 있는 샤딩된 클러스터의 세컨더리 읽기는 문서를 놓칠 수 있습니다.
샤딩된 클러스터에서 장기 실행 세컨더리 읽기는 마이그레이션이 발생하는 경우 문서를 누락할 수 있습니다.
청크 마이그레이션 중에 청크 삭제하기 전에 MongoDB 청크 관련된 진행 중인 쿼리가 샤드 프라이머리 에서 완료될 때까지 기다린 다음 추가로 orphanCleanupDelaySecs 초를 기다립니다. 처음에는 프라이머리 노드 에서 실행 되었으나 노드 세컨더리 로 물러난 후에도 계속 실행되는 쿼리는 처음에 세컨더리 에서 실행된 것처럼 처리됩니다. 즉, 서버 현재 프라이머리 의 청크 대상으로 하는 쿼리가 없는 경우에만 orphanDelayCleanupSecs 을 기다립니다.
청크를 대상으로 하고 세컨더리에서 실행되는 쿼리는 쿼리가 orphanCleanupDelaySecs보다 오래 걸리면 문서를 누락할 수 있습니다.
읽기 설정 모드
primaryAll read operations use only the current replica set primary. [1] This is the default read mode. If the primary is unavailable, read operations produce an error or throw an exception.
primary읽기 설정 모드는 태그 세트 목록이나 maxStalenessSeconds를 사용하는 읽기 설정 모드와 호환되지 않습니다. 태그 세트 목록 또는maxStalenessSeconds값을primary로 지정하면 드라이버는 오류를 발생시킬 것입니다.읽기 작업이 포함된 트랜잭션 은 읽기 설정 (read preference)
primary를 사용해야 합니다. 특정 트랜잭션 의 모든 작업은 동일한 노드로 라우팅되어야 합니다.
primaryPreferred대부분의 경우 작업은 세트의 프라이머리 멤버에서 읽습니다. 그러나 페일오버 조치 상황과 같이 프라이머리 멤버를 사용할 수 없는 경우에는 읽기 설정의
maxStalenessSeconds및 태그 세트 목록을 충족하는 세컨더리 멤버로부터 작업을 읽습니다.When the
primaryPreferredread preference includes a maxStalenessSeconds value and there is no primary from which to read, the client estimates how stale each secondary is by comparing the secondary's last write to that of the secondary with the most recent write. The client then directs the read operation to a secondary whose estimated lag is less than or equal tomaxStalenessSeconds.읽기 설정에 태그 세트 목록 (태그 세트의 배열)이 포함되어 있고 읽을 수 있는 프라이머리 멤버가 없는 경우, 클라이언트는 일치하는 태그가 있는 세컨더리 멤버를 찾으려고 시도합니다 (일치하는 태그가 발견될 때까지 태그 세트를 차례로 시도합니다). 일치하는 세컨더리 멤버가 발견되면 클라이언트는 일치하는 세컨더리 멤버의 가장 가까운 그룹에서 무작위로 세컨더리를 선택합니다. 일치하는 태그를 가진 세컨더리 멤버가 없는 경우, 읽기 작업은 오류를 발생시킵니다.
읽기 기본 설정에
maxStalenessSeconds값 과 태그 세트 목록이 포함되어 있는 경우, 클라이언트는 먼저 오래된 정도에 따라 필터링한 다음 지정된 태그를 기준으로 필터링합니다.Read operations using the
primaryPreferredmode may return stale data. Use themaxStalenessSecondsoption to avoid reading from secondaries that the client estimates are overly stale.참고
Read preference
primaryPreferredsupports hedged reads on sharded clusters.
secondary작업은 세트의 오직 세컨더리로부터만 읽습니다.사용 가능한 세컨더리 멤버가 없으면 이 읽기 작업에서 오류나 예외가 발생합니다.
대부분의 복제본 세트에는 최소한 하나의 세컨더리가 있지만 사용 가능한 세컨더리가 없는 상황도 있습니다.예를 들어 하나의 프라이머리, 하나의 세컨더리, 그리고 하나의 중재자가 있는 복제본 세트에서 멤버가 복구 중이거나 사용할 수 없는 경우 세컨더리 멤버가 없을 수 있습니다.
secondary읽기 설정에 maxStalenessSeconds 값이 포함된 경우 클라이언트는 세컨더리의 마지막 쓰기를 프라이머리의 마지막 쓰기와 비교하여 각 세컨더리의 부실 정도를 추정합니다. 그런 다음 클라이언트는 예상 지연이maxStalenessSeconds이하인 세컨더리에 읽기 작업을 지시합니다. 프라이머리가 없으면 클라이언트는 비교를 위해 가장 최근에 쓴 세컨더리를 사용합니다.읽기 설정에 태그 세트 목록 (태그 세트의 배열)이 포함된 경우 클라이언트는 일치하는 태그가 있는 세컨더리 구성원을 찾으려고 시도합니다 (일치하는 태그가 발견될 때까지 태그 세트을 순서대로 시도). 일치하는 세컨더리가 발견되면 클라이언트는 일치하는 세컨더리 멤버 중 가장 가까운 그룹에서 무작위로 세컨더리를 선택합니다. 일치하는 태그를 가진 세컨터리 멤버가 없는 경우, 읽기 작업은 오류를 발생시킵니다.
읽기 기본 설정에
maxStalenessSeconds값 과 태그 세트 목록이 포함되어 있는 경우, 클라이언트는 먼저 오래된 정도에 따라 필터링한 다음 지정된 태그를 기준으로 필터링합니다.secondary모드를 사용한 읽기 작업은 오래된 데이터를 반환할 수 있습니다.maxStalenessSeconds옵션을 사용하면 클라이언트가 너무 오래되었다고 추정하는 세컨더리에서 데이터를 읽지 않도록 할 수 있습니다.참고
읽기 설정(read preference)
secondary는 샤딩된 클러스터에서 헤지된 읽기(hedged read))를 지원합니다.
secondaryPreferred작업은 일반적으로 복제본 세트의 세컨더리 노드에서 데이터를 읽습니다. 만약 복제본 세트에 프라이머리 노드가 하나만 있고 다른 노드가 없다면, 작업은 프라이머리 노드에서 데이터를 읽습니다.
When the
secondaryPreferredread preference includes a maxStalenessSeconds value, the client estimates how stale each secondary is by comparing the secondary's last write to that of the primary. The client then directs the read operation to a secondary whose estimated lag is less than or equal tomaxStalenessSeconds. If there is no primary, the client uses the secondary with the most recent write for the comparison. If there are no secondaries with estimated lag less than or equal tomaxStalenessSeconds, the client directs the read operation to the replica set's primary.읽기 환경 설정에 태그 세트 목록(태그 세트의 배열)이 포함된 경우 클라이언트는 일치하는 태그가 있는 세컨더리 멤버를 찾으려고 시도합니다(일치하는 태그가 발견될 때까지 태그 세트을 순서대로 시도). 일치하는 세컨더리가 발견되면 클라이언트는 일치하는 세컨더리의 가장 가까운 그룹에서 무작위로 세컨더리를 선택합니다. 일치하는 태그를 가진 세컨더리가 없는 경우, 클라이언트는 태그를 무시하고 프라이머리에서 읽습니다.
읽기 기본 설정에
maxStalenessSeconds값 과 태그 세트 목록이 포함되어 있는 경우, 클라이언트는 먼저 오래된 정도에 따라 필터링한 다음 지정된 태그를 기준으로 필터링합니다.Read operations using the
secondaryPreferredmode may return stale data. Use themaxStalenessSecondsoption to avoid reading from secondaries that the client estimates are overly stale.참고
Read preference
secondaryPreferredsupports hedged reads on sharded clusters.
nearestThe driver reads from a member whose network latency falls within the acceptable latency window. Reads in the
nearestmode do not consider whether a member is a primary or secondary when routing read operations: primaries and secondaries are treated equivalently.이 모드를 설정하면 현재 데이터나 오래된 데이터를 선호하지 않고 네트워크 지연 시간이 읽기 작업에 미치는 영향을 최소화할 수 있습니다.
읽기 설정에 MaxStalenessSeconds 값이 포함된 경우 가능하다면 클라이언트는 세컨더리의 마지막 쓰기를 프라이머리의 마지막 쓰기 작업과 비교하고, 프라이머리가 없는 경우 가장 최근에 쓴 세컨더리와 비교하여 각 세컨더리가 얼마나 오래 되었는지 추정합니다. 그런 다음 클라이언트는 예상 지연이
maxStalenessSeconds보다 큰 세컨더리를 필터링하고 네트워크 지연이 허용 가능한 지연 시간 내에 있는 나머지 멤버 (프라이머리 또는 세컨더리)에게 무작위로 읽기를 지시합니다.태그 세트 목록을 지정하면 클라이언트는 지정된 태그 세트 목록과 일치하는 복제본 세트 멤버을 찾으려고 시도하고, 가장 가까운 그룹 중에서 임의의 멤버에게 읽기를 지시합니다.
읽기 설정에
maxStalenessSeconds값과 태그 세트 목록이 포함되어 있는 경우 클라이언트는 먼저 오래된 정도에 따라 필터링한 다음 지정된 태그를 기준으로 필터링합니다. 나머지mongod인스턴스에서 클라이언트는 허용 가능한 지연 시간 범위 내에 있는 인스턴스로 읽기를 임의로 지시합니다. 읽기 설정 멤버 선택 문서에 이 프로세스에 대한 자세한 설명이 나와 있습니다.Read operations using the
nearestmode may return stale data. Use themaxStalenessSecondsoption to avoid reading from secondaries that the client estimates are overly stale.참고
Read preference
nearest, by default, specifies the use of hedged reads for reads on a sharded cluster.
팁
특정 읽기 설정의 사용 사례에 대해 알아보려면 읽기 환경 설정 사용 사례를 참조하세요.
읽기 환경설정 구성
When using a MongoDB driver, you can specify the read preference using the driver's read preference API. See the driver API documentation. You can also set the read preference (except for the hedged read option) when connecting to the replica set or sharded cluster. For an example, see connection string.
주어진 읽기 설정에 대해 MongoDB 드라이버는 동일한 노드 선택 로직을 사용합니다.
When using mongosh, see cursor.readPref() and Mongo.setReadPref().
읽기 환경설정 및 트랜젝션
읽기 작업이 포함된 트랜잭션 은 읽기 설정 (read preference) primary를 사용해야 합니다. 특정 트랜잭션 의 모든 작업은 동일한 노드로 라우팅되어야 합니다.
추가 고려 사항
집계 파이프라인에서 $merge 또는 $out 단계를 사용할 때는 다음 사항을 고려하세요.
Starting in MongoDB 5.0, pipelines with a
$mergestage can run on replica set secondary nodes if all the nodes in the cluster have the featureCompatibilityVersion set to5.0or higher and the read preference allows secondary reads.이전 MongoDB 버전에서는
$out또는$merge단계가 있는 파이프라인은 항상 기본 노드에서 실행되며 읽기 기본 설정은 고려되지 않았습니다.
mapReduce 작업의 경우 mapReduce 데이터를 쓰지 않는 "inline" 작업만 읽기 설정을 지원합니다. 그렇지 않으면 mapReduce 작업은 프라이머리 멤버에서 실행됩니다.
| [1] | (1, 2) 일부 상황에서는 복제본 세트의 두 노드가 일시적으로 자신이 주 노드라고 생각할 수 있지만, |