산업: 미디어, 통신
제품 및 도구: MongoDB Atlas, MongoDB Atlas Vector Search
파트너: Amazon Bedrock
솔루션 개요
콘텐츠 팀은 급변하는 뉴스 환경에서 매력적이고 신뢰할 수 있는 콘텐츠를 제작해야 한다는 점점 더 많은 압박을 받고 있습니다. 기존의 방법은 수작업 조사, 소스 검증, 도구 관리 에 소비되는 시간으로 인해 콘텐츠 제작보다 크리에이티브에 대한 피로와 기회를 놓치는 경우가 많습니다. MongoDB 사용하면 생성형 AI 와 MongoDB의 적응형 데이터 인프라를 결합하여 편집 작업을 최적화할 수 있습니다. 이러한 기능을 테스트할 수 있도록 복제할 수 있는 솔루션인 콘텐츠 랩 데모를 제공합니다.
콘텐츠 랩 데모는 편집 워크플로를 간소화하고 다음을 수행할 수 있습니다.
다양한 콘텐츠 수집 및 구조화: 이 데모는 다양한 소스의 대용량 비구조화 및 반구조화 콘텐츠를 효율적으로 처리하여 주제, 산업 및 소스 메타데이터 별로 동적으로 구성합니다.
AI 기반 검색 및 드래프팅 지원: 임베딩 모델과 MongoDB Atlas Vector Search는 원본 콘텐츠를 검색 가능한 구조화된 데이터로 변환합니다. 이 조합을 통해 인기 급상승 주제의 시맨틱 검색이 가능하고 콘텐츠 초안 작성을 자동화하여 크리에이티브의 피로도를 줄일 수 있습니다.
콘텐츠 신뢰성 향상: 이 데모는 소스 URL을 캡처하고 저장한 다음 주제 추천에 직접 포함됩니다. 외부 검색 에이전트와의 통합은 상황에 맞는 정보를 통해 콘텐츠 제안을 더욱 풍부하게 합니다.
개인화 및 워크플로 효율성 향상: 이 데모는 사용자의 프로필을 처리하여 개인화된 쓰기 제안을 제공하고 버전 관리 및 재사용을 위해 초안을 저장합니다. MongoDB의 유연한 스키마 워크플로를 중단하지 않고 진화하는 프로필 데이터, 초안 형식, 새로운 콘텐츠 유형에 쉽게 적응함으로써 이를 가능하게 합니다.
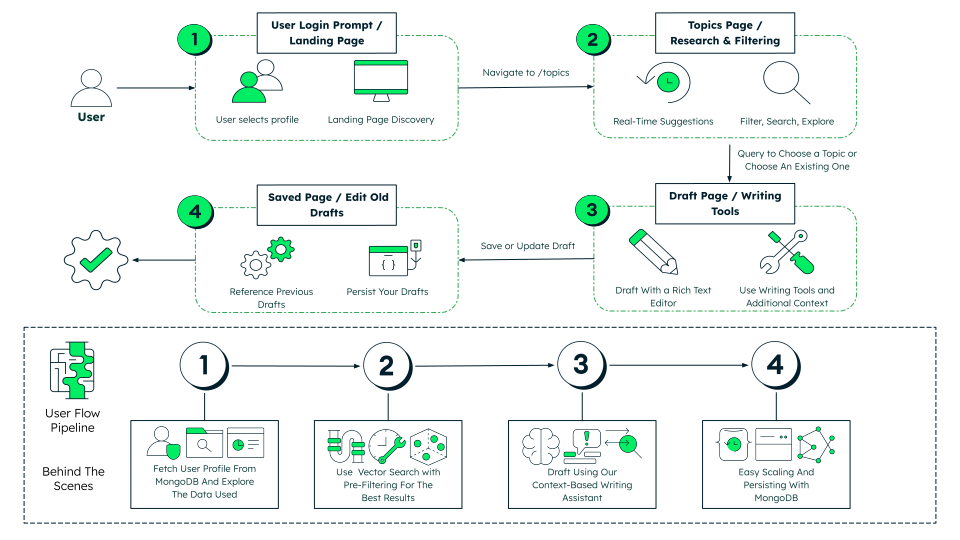
그림 1. 사용자 여정 흐름도
이 데모에서는 통합 저장 솔루션, 실시간 인사이트, 자동화된 콘텐츠 지원을 통해 MongoDB 편집 팀이 편집 팀의 복잡성을 줄이고, 콘텐츠 품질을 향상시키며, 프로덕션을 가속화하는 데 어떻게 도움이 되는지 보여줍니다. 퍼블리셔에게 아이디어에서 출판까지의 명확한 경로를 제공합니다.
참고 아키텍처
콘텐츠 랩 데모는 Gen AI 와 MongoDB의 유연한 데이터 인프라를 결합하여 편집 운영을 간소화하는 AI 기반 게시 도구를 제공합니다. 이 아키텍처는 다음을 위한 microservices 로 설계되었습니다.
다양한 콘텐츠 수집 처리
AI 기반 검색 및 초안 작성 촉진
콘텐츠 신뢰성 향상
개인화 및 워크플로 효율성 지원
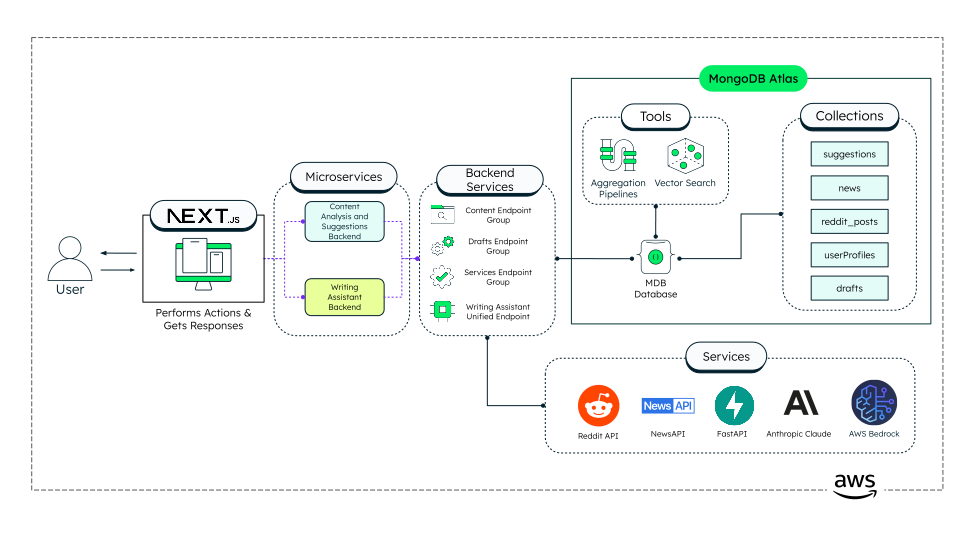
그림 2. 콘텐츠 랩 데모의 상위 수준 아키텍처
이 아키텍처는 다음 구성 요소를 사용합니다:
사용자 인터페이스(UI): 사용자는 주제 제안, 초안 도구, 초안 관리 등의 기능을 제공하는 UI를 통해 시스템과 상호 작용.
백엔드 서비스: 이러한 마이크로 서비스는 다음을 포함하여 데모의 다양한 기능을 처리하다 .
콘텐츠 분석 및 제안 백엔드: 이 서비스는 뉴스와 Reddit 데이터를 처리하여 Cohere-embed 와 같은 임베딩 모델을 통해 콘텐츠를 시맨틱 벡터로 변환합니다. 그런 다음 이러한 벡터를 Atlas Vector Search 로 처리하여 실시간 주제 제안을 제공할 수 있습니다. microservices 에는 다음과 같은 주요 구성 요소가 있습니다.
스케줄러 및 오케스트레이션: 이 서비스는 수집, 임베딩 생성 및 주제 제안 워크플로를 매일 자동화합니다.
역할: 이 서비스는 시맨틱 검색 및 조회를 사용하여 쓰기 비서 microservices 에 대한 다운스트림 쓰기 지원 및 개인화 기능을 제공합니다.
아래에서 이 microservices 에 대한 높은 수준의 개요 다이어그램을 찾을 수 있습니다.
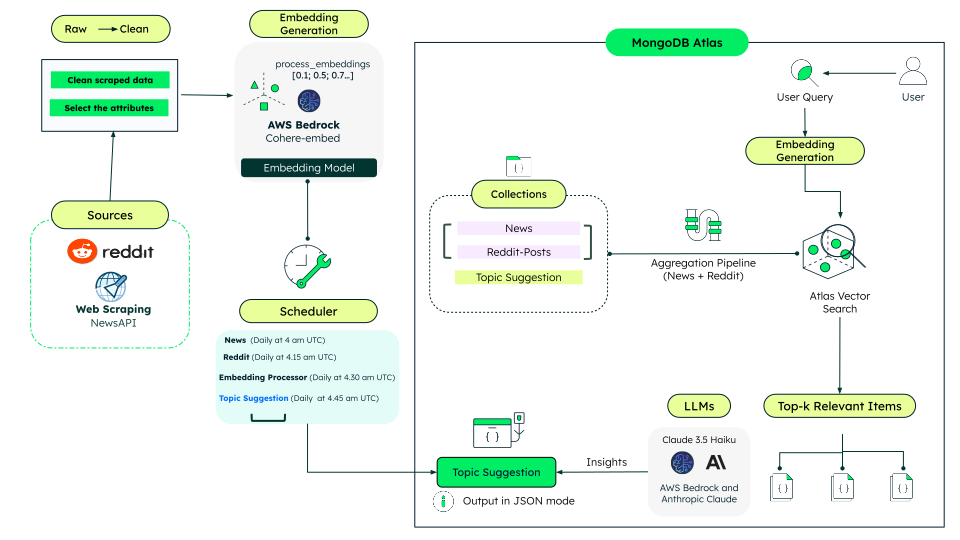
그림 3. 콘텐츠 및 제안 백엔드 의 상위 수준 아키텍처
클릭하여 확대쓰기 어시스턴트 백엔드: 이 서비스는 초안 개요, 교정, 콘텐츠 수정, 채팅 완료를 포함한 게시 도구를 제공합니다. 이러한 연장은 Amazon Web Services 기반을 통해 Atronic Claude와 같은 LLM을 사용합니다.
MongoDB Atlas: Atlas 프라이머리 데이터 저장 역할을 하며, 효율적인 처리 및 조회를 위한 시맨틱 검색 기능, 데이터베이스 저장, 집계 파이프라인을 제공합니다.
데이터 모델 접근 방식
이 데모에서는 다음 문서 모델 디자인 및 컬렉션을 사용하여 콘텐츠를 저장 .
콘텐츠 랩 데모에는 5개의 주요 컬렉션이 있습니다.
userProfilereddit_postsnewssuggestionsdrafts
userProfile 컬렉션 개별 사용자 기본 설정을 저장하여 개인화된 AI 기반 제안을 맞춤 설정합니다. 이러한 기본 설정에는 다음이 포함됩니다.
persona: 사용자가 선택할 수 있는 작성자 유형입니다.tone: 사용자가 원하는 톤( 예시: 캐쥬얼, 포멀 또는 세미 포멀)을 선택할 수 있습니다.styleTraits: 작성자의 사전 정의된 특성입니다.sampleText: 작가의 예시 문장입니다.
이 스키마 자주 함께 액세스하는 데이터가 함께 저장된다는 MongoDB 설계 원칙을 따르므로 쓰기 어시스턴트가 사용자 추천을 빠르게 조회 할 수 있습니다. 샘플 문서 아래에 나와 있습니다.
{ "_id": { "$oid": "6862a8988c0f7bf43af995a8" }, "persona": "The Formal Expert", "userName": "Mark S.", "tone": "Polished, academic, appeals to professionals and older readers", "styleTraits": [ "Long, structured paragraphs", "Formal language with rich vocabulary", "Analytical, often includes references or citations" ], "sampleText": "This development represents..."}reddit_posts 및 news 컬렉션은 해당 API에서 수집한 원시 데이터를 저장 . 이러한 문서는 시맨틱 검색 활성화 하는 콘텐츠의 의미를 숫자로 표현한 임베딩으로 더욱 강화됩니다.
suggestions 컬렉션 에는 처리된 reddit_posts 및 news 데이터에서 제안된 주제가 포함되어 있습니다. UI 이러한 문서를 쉽게 찾아 주제 선택에 사용할 수 있습니다. 샘플 문서 아래에 나와 있습니다.
{ "_id": { "$oid": "686fb23055303796c4f37b7e" }, "topic": "Backlash against generative AI", "keywords": [ "algorithmic bias", "data privacy", "AI regulation", "public trust" ], "description": "As generative AI tools like ChatGPT proliferate, a growing public backlash highlights concerns over their negative impacts and the need for stronger oversight.", "label": "technology", "url": "https://www.wired.com/story/generative-ai-backlash/", "type": "news_analysis", "analyzed_at": { "$date": "2025-07-10T12:29:36.277Z" }, "source_query": "Viral social media content"}마지막으로 drafts 컬렉션 사용자의 초안을 저장합니다. 각 초안은 추천 주제 와 연결되어 있어 쉽게 조직 하고 조회할 수 있습니다. 이 모델은 편집 워크플로의 지속성, 버전 관리 및 콘텐츠 재사용성을 보장합니다.
솔루션 빌드
다음 단계에 따라 이 데모를 복제할 수 있습니다.
MongoDB Atlas 프로비저닝
MongoDB Atlas 계정 내에서 이 컬렉션을 사용하여 클러스터와 contentlab 이라는 이름의 데이터베이스를 만듭니다.
drafts: 사용자가 만든 초안 문서 저장news: 스크래핑된 뉴스 기사를 임베딩과 함께 저장합니다.reddit_posts: Reddit 게시물과 댓글을 임베딩과 함께 저장합니다.suggestions: AI 에서 생성한 주제 추천을 저장합니다.userProfiles: 사용자 프로필 정보 및 기본 설정을 저장합니다.
종속성 설치 및 서비스 실행
포트 8000 및 8001에 두 백엔드 서비스를 모두 설치하고 시작합니다. 그런 다음 프론트엔드 종속성을 설치하고 http://localhost:3000.에서 개발 서버 시작합니다.
주요 학습 사항
MongoDB의 유연한 스키마로 데이터 모델 조정: MongoDB 사용하면 다운타임이나 복잡한 마이그레이션 없이 컬렉션에 사용자 지정 메타데이터, 요약, 버전 기록 등 기존 필드를 원활하게 추가하거나 기존 필드를 조정할 수 있습니다.
의미 있는 발견을 위한 Atlas Vector Search 통합: MongoDB 사용하면 다양한 API의 임베딩을 해당 컬렉션에 저장 다음 유사성 쿼리를 실행 관련 주제를 몇 초 만에 발견할 수 있습니다.
콘텐츠 소스를 추적하여 편집자 신뢰 보장: MongoDB 사용하면 소스 URL과 메타데이터 추천 항목과 함께 저장 출처를 쉽게 확인하고 초안의 신뢰성을 유지할 수 있습니다.
파이프라인 자동화하여 아이디어의 지속적인 스트림 유지: MongoDB 사용하면 뉴스를 스크랩하고, 임베딩을 프로세스 , 최신 주제 추천을 보장하는 제안을 생성하는 일일 작업을 예정 할 수 있습니다.
작성자
Aswin Subramanian 마헤스와란, MongoDB
Felipe Trejos, MongoDB
자세히 알아보기
Atlas Vector Search 시맨틱 검색 강화하고 실시간 분석 가능하게 하는 방법을 알아보려면 Atlas Vector Search 페이지를 방문하세요.
MongoDB 미디어 운영을 어떻게 혁신하고 있는지 학습 AI 기반 미디어 개인화: MongoDB 및 벡터 검색 문서를 읽어보세요.
MongoDB 최신 미디어 워크플로를 지원하는 방법을 알아보려면 미디어 및 엔터테이먼트용 MongoDB 페이지를 방문하세요.