MongoDB Atlasを使用して、 SNID ct 診断用語のモデル化、検索、移動、基礎を示す方法を学びます。
ユースケース: 相互運用性
業種: 医療
製品: MongoDB Atlas、 MongoDB Search、 MongoDB ベクトル検索、 Voyage AI
ソリューション概要
医療アプリケーションは、医療テキストを保存するだけでなく、臨床的な意味を理解する必要があります。医師は「心不全」、「心臓不全」、または「insuficiencia cardíaca」と書くことがあります。同じ臨床的な概念は、異なる単語で表現できます。臨床コーディングにより、アプリケーションは安定した識別子を使用してその意味を表現する標準的な方法を得られます。
医療チームは、さまざまな目的で異なるコーディング システムを使用します。一部のコーディング システムでは、レポート作成、統計、支払い、または医療機関の活動分析のために、診断とエンカウントをグループ化します。 S加えられた ct は、 ヘルスレコード内の開発的な意味に焦点を当てています。これは、問題、結果、手順、ボディ構造、組織、ファイル、製品、およびその他の多くの医療概念を表すことができます。 SNI は、可能性を定義するアプリケーションをサポートしています。
S加えられた 国際 では、 S Not を、一意の意味、形式定義、階層組織 を持つ概念である診断用語として説明しています。
SNOMED CT にはグラフのような構造があります。500,000 個以上の臨床概念があり、それぞれには同義語や翻訳を含む複数の人間が読み取れる説明を持つことができます。親概念、子概念、祖先、および他の概念との正式な関係を持つことができます。SNOMED CTは、次のように概念、説明、および関係を通じて用語コンテンツを表します。
概念は臨床的なアイデアを表します。
説明は、人間が読み取りやすい期間をその概念にリンクします。
関係は、あるコンセプトを別のコンセプトに接続します。
この構造は強力ですが、実装上の課題が生じます。アプリケーションチームには、高速な期間検索、多言語ルックアップ、階層ナビゲーション、子子展開、および関係検査が必要です。また、臨床ノートの検討、問題リストの作成、意思決定支援、コホート検索、およびセマンティック検索などのワークフロー内でSNOMEDの用語を使用する必要があります。従来の実装では、これらのニーズがいくつかのシステムに分割されることが多くありました。
用語ファイルのための関係データベース。
テキスト検索のための検索エンジン。
階層のトラバーサル用のグラフデータベース
セマンティック検索用のベクトルデータベース。
このソリューションでは、MongoDB Atlas で SNOMED CT を操作可能にする方法を次のように示します。
各 SNOMED の概念を、概念のアイデンティティ、説明、関係、親、子、および祖先パスをまとめて保存する MongoDB ドキュメントとして保存します。
MongoDB Search と MongoDB ベクトル検索のために 1 つの期間レベル検索プロジェクションをビルドする。
優先する配列とマルチキーインデックスを使用して、別のグラフデータベースを使用せずに、一般的な階層と後継クエリをサポートします。
同じ用語サービスを使用して臨床ノートを SNOMED 候補に基づく
検討されたコーディングを証拠、コンテキスト、および祖先パスとともに保存します。
例、ユーザーは「ハートビート」を検索し、選択した医療概念を調べ、その親概念と子概念を確認し、その形式関係を確認して、その下に特定の概念を展開できます。 S関係 では、このタイプの降順展開を表現するために、多くの場合 ECL を使用します。 ECL は、SNMP TT の概念のセットを説明するための圧縮されたクエリ言語として機能します。例、式<< Heart failure は、階層内のハートビートとその下にあるすべての概念を指します。 MongoDB のスキーマ設計では、このパターンは事前計算された祖先配列に対するクエリに自然にマッピングされます。 SNOMED の公式 ECL参照では、演算子 << は の子孫または自己管理型として定義され、概念とそのサブタイプが検索されます。
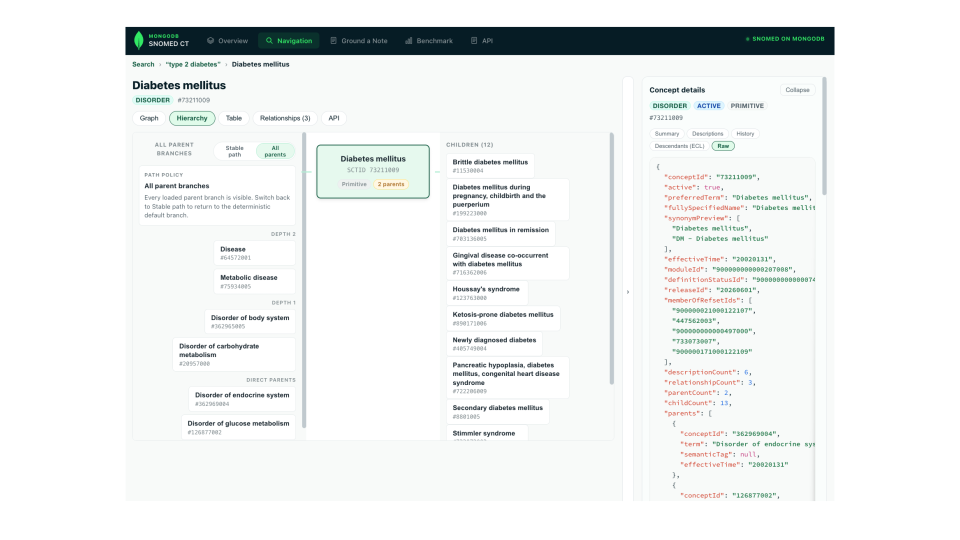
図 1親と子の階層を持つ臨床概念
このソリューションは、臨床ノートのグラウンディングも示します。ノートには、現在の所見、過去の病歴、家族歴、計画されたアクション、不確実なステートメント、及び拒否された所見が含まれる場合があります。アプリケーションは候補の臨床期間を抽出し、MongoDB を介して SNOMED CT を検索し、候補の概念を提案し、確認後にのみ検討済みのコーディングを保存します。保存されたコーディングには、元の証拠スパン、選択された SNOMED 概念、アサーションコンテキスト、検討者のステータス、および祖先パスが保持されます。ダウンストリームアプリケーションは、次に正確な単語だけでなく、臨床的な意味でクエリできます。
次の場合は、このソリューションを使用します。
臨床用語、類義語、翻訳、SNOMED識別子を検索します。
親、子、祖先、子孫、関係のビューを移動します。
1 つの MongoDB コレクションから詞彙的、意味的、およびハイブリッド用語検索をサポートします。
「心不全のすべての子孫」のような ECL スタイルの階層式を使用して概念セットを拡張します。
証拠と人間による検討を含むスパンで臨床ノートを SNOMED CT 候補にグラウンドします。
検討された SNOMED コーディングをインデックス付きのダウンストリーム クエリの祖先パスとともに保存します。
このパスワードなしでは、アプリケーションチームに用語データ、用語検索、意味的な取得、階層クエリ、臨床的な証拠の取得、および監査されたコーディング出力のための 1 つの操作プラットフォームが提供されます。ドキュメント ストレージ、検索、意味論的取得、グラフスタイルのナビゲーションに別々のシステムを実行する必要が減ります。
SNOMED CT ライセンスに関する注意事項: このソリューションに関連する公開リポジトリには、小さなサンプル データセットのみが含まれています。SNOMED CT には適切なライセンスが必要です。
参照アーキテクチャ
このリファレンスアーキテクチャは、ナビゲーションと基礎となる診療ノートのワークフローで構成されています。
ナビゲーションは、用語ユーザーが SNOMED CT の概念を検索、検査、範囲設定するのに役立ちます。Ground Clinical Note は、同じ用語取得レイヤーを再利用し、デフォルトでは確定的な詞書検索を使用して、臨床テキストから SNOMED CT の候補を提案し、検討済みのコーディングのみを保存します。
アーキテクチャでは、一連の MongoDB コレクションを使用します。
snomed-irbdコレクションには、用語ビューの正規のソースが保存されています。snomed-term-searchは、高品質の用語検索をサポートします。grounded_notesコレクションには、検討されたアプリケーションの出力が保存され、ソース用語データは保存されません。
SNOMED CT のコンテンツはグラフ形です。このアーキテクチャでは、接続された構造を MongoDB ドキュメントにまとめて保持し、検索プロジェクションと祖先配列を使用して、これらを操作可能にします。
アーキテクチャの概要
この実装は、 JSONコンセプト モデルとしてすでに利用可能な MongoDB STOP のコンテンツパッケージから始まります。現在のデモでは、ソースモデルは、国の認証局が使用するスペインの SNID ct ディストリビューションから取得されています。パブリックリポジトリにはサンプルデータセットのみが含まれています。完全な S付与 ct 用語を再配布することは ありません 。
アーキテクチャはソース形式に依存しません。組織が SNOMED CT を JSON として受信した場合、そのモデルを MongoDB に直接ロードできます。

図 2任意の候補に囲まれた LLM ゲートウェイを備えた、コード権限としての MongoDB。
ターゲット モデルには、次の用語コレクションがあります。
snomed-irbd: 各臨床概念を、その説明、関係、親、子、祖先、アクティブステータス、リリースメタデータ、およびメンバーシップメタデータとともに保存します。アプリケーションはこのコレクションを使用して、概念の検索、階層のナビゲーション、関係の検査、および子孫の展開を行います。snomed-term-search: アクティブな期間、言語、リリースごとに 1 つの検索可能なドキュメントを保存します。アプリケーションは、このプロジェクションを使用して詞書検索、セマンティック検索、ハイブリッド検索、言語フィルター、および範囲フィルターを実行します。
Navigation API は snomed-term-search を使用して一致する概念を検索します。次に、snomed-irbd コレクションから選択した結果を強化します。ユーザーは、「心不全」のような臨床用語を検索し、選択した概念を調査し、より広範でより具体的な概念を表示し、同じ操作の API 例を開くことができます。
Grounding API は、臨床ノートのワークフロー内で用語取得レイヤーを再利用します。Grounding 取得はデターミニスティックな語彙検索をデフォルトとしますが、Navigation は語彙、意味、ハイブリッドの各モードを提供します。任意の LLM 階層は、テキストを解釈し、MongoDB が提供する候補の中から選択するのに役立ちますが、新しい SNOMED CT 識別子を作成してはなりません。
検討後、アプリケーションは確認されたコーディングを grounded_notes に保存します。各コーディングには選択された SNOMED CT の概念、証拠テキスト、アサーションコンテキスト、サブジェクトコンテキスト、検討者ステータス、および祖先 ID が保存されます。ダウンストリームアプリケーションは、次に検討された臨床知識を正確な単語だけでなく、意味でクエリできるようになります。
ナビゲーションワークフロー
ユーザーは、「心不全」などの臨床用語を検索します。アプリケーションは、期間検索プロジェクションをクエリし、SNOMED の概念でグループ化された概念レベルの結果を返します。
各結果には次のように表示されます。
ユーザークエリに一致した期間
コンセプトの推奨表示
正式な臨床名
SNOMED 識別子
アクティブなステータス
意味的カテゴリ
リリース
検索の出処
ユーザーは、その後、コンセプトフォーカスビューを開くことができます。このビューには、コンセプトの概要、説明、親コンセプト、子コンセプト、関係、子孫、生ドキュメント、API の例が表示されます。
ナビゲーションは次の検索モードをサポートしています:
語彙検索では、MongoDB Search を使用して正確な期間、同義語、正式名称、識別子、接頭辞、あいまいなテキストを検索します。
セマンティック検索はMongoDB ベクトル検索を使用します。これは自動的に期間の
embedTextフィールドをvoyage-4参照モデルで埋め込みます。このため、意味による取得は、別個のベクトルストアや埋め込みパイプラインを必要とせず、同じコレクションで実行されます。ハイブリッド検索は詞彙検索とベクトル検索を結合します。Voyage クロスエンコーダーリランカーが構成されている場合、アプリケーションは統合された候補プールをリランクします。そうでない場合は統合順にフォールバックします。
検索画面は意味的なスコープもサポートします。ユーザーは、臨床的所見、手順、身体構造、物質などの広範な臨床領域に結果を制限できます。ユーザーは、<< 404684003 のような子孫式を使用して、結果を概念とそのより具体的な概念に制限することもできます。
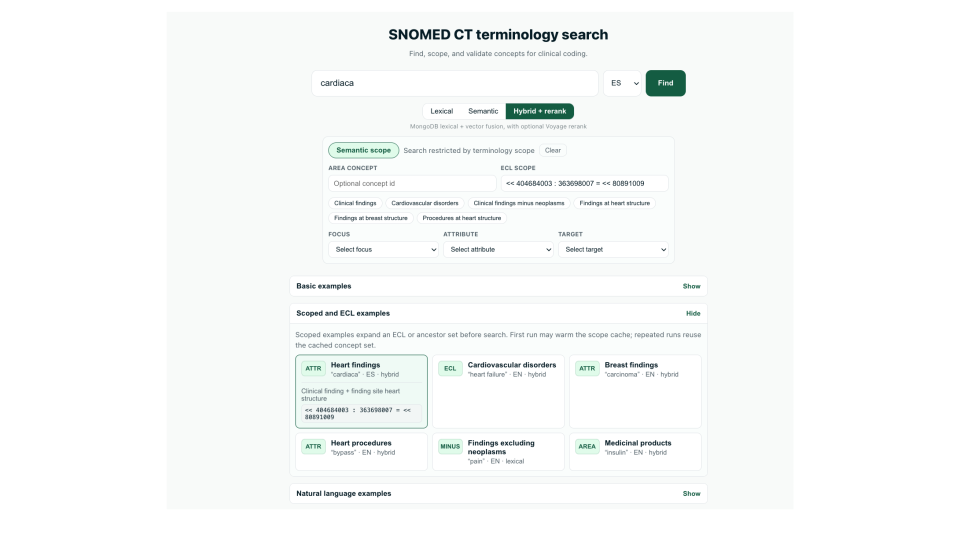
図 3拡張された ECL スコープでのセマンティック検索
臨床ノートのグラウンディングワークフロー
ユーザーは臨床ノートを貼り付けます。ワークフローは、臨床の記述と、現在の所見、陰性、症歴、家族歴、計画されたアクション、不確実性、時間式などのコンテキストキューを抽出します。
ワークフローは、MongoDB を介して SNOMED CT 候補を検索します。証拠スパンとコンテキストを含む検討可能な候補が返されます。検討者は、各候補を承認、拒否、または検討の対象としてマークできます。
任意の LLM 階層は、テキスト解釈と候補選択に役立ちます。MongoDB から返された候補からのみ選択する必要があります。新しい SNOMED 識別子を作成したり、検討なしでコーディングを持続したりしてはなりません。
検討後、アプリケーションは確認されたコーディングを grounded_notes に保存します。保存された各コーディングには、証拠スパン、選択された SNOMED コンセプト、アサーション、サブジェクト、ステータス、および祖先 ID が含まれます。このパターンにより、ダウンストリームアプリケーションで意味をクエリできます。例えば、アプリケーションでは、選択した臨床コンセプトの受け入れられた子孫を含む検討済みのノートを検索できます。
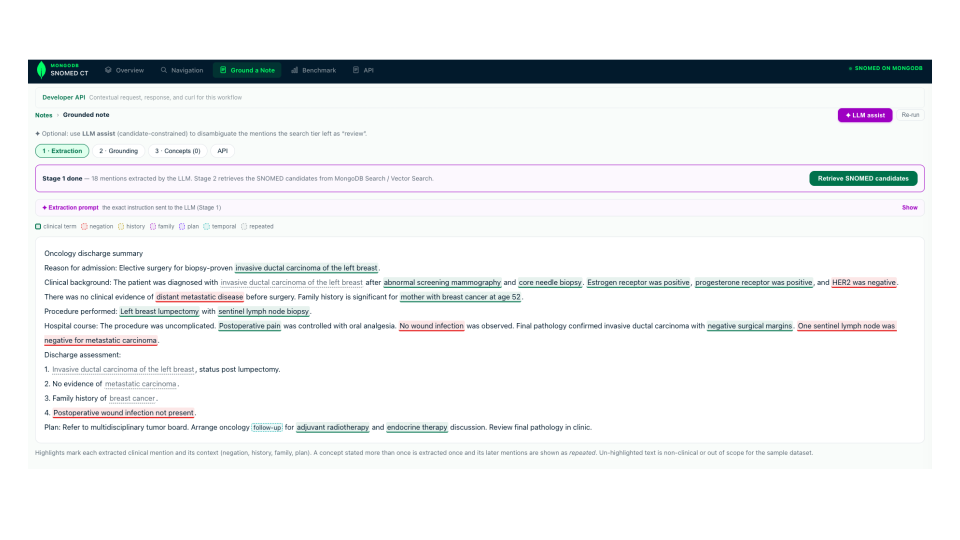
図 4診療ノートの基礎となるもの - LLM プロセス
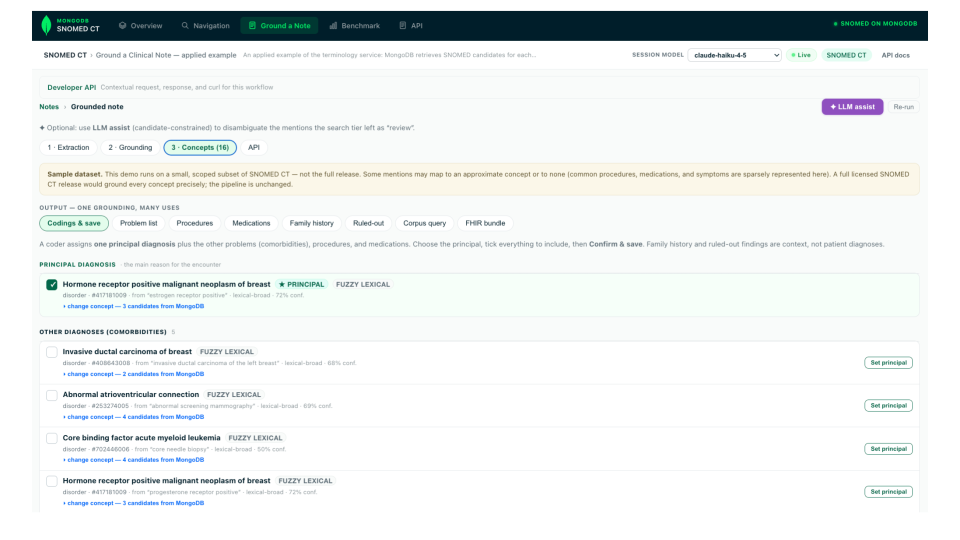
図 5MongoDBを使用した期間検索後の臨床ノートのグラウンディング
API スニペットの例
このソリューションでは、ナビゲーションとグラウンドクリニカルノートの両方のワークフローの API が公開されています。これらのスニペットは、コアのリクエストパターンを示しています。
SNOMED 期間と概念を検索
このエンドポイントとなる接続されたデバイスを使用して期間レベルのプロジェクションを検索します。応答は一致する期間を SNOMED の概念にグループ化します。一致する期間、好ましい表示、意味的カテゴリ、および検索プロビナンスを含む概念レベルの結果を返します。
POST /api/navigator-search { "query": "heart failure", "languageCode": "en", "mode": "lexical", "limit": 24 }
ユーザーが既知の期間、同義語、正式名称、または SNOMED 識別子で検索する場合は、詞書モードを使用します。デモが MongoDB ベクトル検索と再ランキングに設定されている場合、API はセマンティックモードとハイブリッドモードもサポートします。
概念とその子孫を展開する
このエンドポイントとなる接続されたデバイスを使用して概念セットを拡張します。SNOMED CT は ECL を使用して概念のセットを記述します。この例では、式 << 84114007 は「心不全とその下のすべてのより詳細な概念」を意味します。
POST /api/ecl { "expr": "<< 84114007", "languageCode": "en", "limit": 200 }
実装では、MongoDB の事前計算された祖先配列を使用してこの式を解決します。このパターンにより、デモアーキテクチャに別のグラフデータベースを必要とせず、一般的な子孫クエリが高速になります。
臨床ノートを SNOMED 候補にベースを確立する
このエンドポイントを使用して、テキストから候補となる臨床の記述を抽出し、MongoDB から境界の定まった SNOMED 候補を検索します。応答により、コードが自動的に持続されることなく、確認可能な出力が生成されます。
POST /api/nlp-map { "text": "Patient with chronic systolic heart failure and type 2 diabetes. No evidence of chest pain at present.", "languageCode": "en" }
グラウンディングワークフローは、否定、病歴、家族歴、計画、時間式などの臨床的な記述とコンテキストを検出します。MongoDBは候補のSNOMEDコンセプトを提供します。最終コーディングはレビュアーが確認します。
レビューアーが確認したコーディングを保存
検討後にこのエンドポイントを使用します。アプリケーションは、確認されたコーディングのみを保存し、それらに祖先 ID を付加して、ダウンストリームの意味クエリを可能にします。
POST /api/coding-confirm { "text": "Patient with heart failure.", "languageCode": "en", "codings": [ { "mention": "heart failure", "conceptId": "84114007", "displayTerm": "Heart failure", "semanticTag": "disorder", "accepted": true } ] }
保存されたドキュメントには、選択した SNOMED の概念、根拠テキスト、アサーションコンテキスト、レビュアーステータス、および祖先 ID が保持されます。このスキーマにより、ダウンストリームのクエリでは、一般的な概念または特定の子孫のいずれかによってノートを検索できます。
意味に基づいたクエリのメモ
このエンドポイントを使用して、選択した SNOMED の概念またはその臨床的な後継を含む検討されたノートを検索します。
POST /api/grounded-corpus { "conceptId": "84114007", "includeDescendants": true, "limit": 10 }
このエンドポイントとなる接続されたデバイスは、検討されたコーディングとともに祖先 ID を保存することのダウンストリーム値を示します。アプリケーションは、正確な単語のみを検索するのではなく、診療的意味をクエリできます。
データモデルアプローチ
SNOMED CTは接続されたデータを表します。臨床概念には、人間が読み取れる多くの期間、いくつかの広範な概念、さらに多くのより具体的な概念、および他の概念との正式な関係を持つことができます。
MongoDB は、ほとんどの操作アプリケーションでコンセプト中心のビューが必要となるため、このパターンに適しています。ユーザーがコンセプトを開くと、アプリケーションにはコンセプト識別子、表示期間、説明、親、子、祖先パス、関係、アクティブステータス、リリースメタデータがまとめて必要になります。
このアプローチでは、グラフ構造は除かれません。関係を保存 (する)し、一般的なナビゲーションパスワードなしのためにクエリフレンドリーな配列を追加します。例ば、各概念ドキュメントは、直接の親と祖先パスワードなしを保存 (する)できます。このパスワードなしにより、アプリケーションはインデックスの付いた MongoDB クエリを使用して、より広範な概念、子概念、および子孫を検索できます。
Why This model Works
以下のデザイン選択では、高速ルックアップ、正確な検索、高速な階層トラバーサル、および監査可能なコーディングといった特定の運用要件に対処します。
コンセプトデータをまとめて保持する: 用語アプリケーションでは、完全なコンセプトカードをレンダーする必要があることがよくあります。説明、関係の概要、親 ID、子 ID、祖先 ID を埋め込むことで、最も役に立つ操作ビューを 1 つのドキュメントにまとめて保持できます。
ソース用語から検索を分離: 検索は概念レベルではなく、用語レベルです。1 つの概念には、言語や方言によって多くの説明が存在します。用語レベルのプロジェクションにより、MongoDB Search と MongoDB Vector Search で、カノニカルな概念を返しながら、一致した正確な用語のランク付けが可能になります。
階層パスの事前計算: SNOMED CT にはリッチな階層があります。多くのアプリケーションでは、「この概念とその下のより具体的な概念をすべて検索する」といった高速な子孫クエリが必要です。各概念と各検討済みの臨床コーディングに祖先 ID を保存します。そして、一般的な階層クエリにマルチキー インデックスを使用します。
検討済みのコーディングで証拠を保存する: コーディングは、アプリケーションがその起源を説明できる場合、より大きな価値を提供します。選択した SNOMED コンセプトを、臨床テキストスパン、アサーションステータス、サブジェクトコンテキスト、および検討者ステータスとともに保存します。このパターンは、監査、検討、およびダウンストリーム クエリをサポートします。

図 6SNOMED CT メタモデルと MongoDB コレクションマッピング
SNOMED CT メタモデルと MongoDB コレクションのマッピング
このソリューションでは、3 つの用語コレクションと別のテレメトリー コレクションを使用します。以下のセクションでは、ドキュメントの形状と各ドキュメントの主要フィールドについて説明します。
snomed-irbd コレクション
snomed-irbd を SNOMED CT 概念の正しいビューとして使用します。各ドキュメントは、1 つのリリースの 1 つの概念を表し、RF2 の説明、関係の定義、親概念、子概念、アクティブステータス、リリースメタデータ、および階層と包括を強化する事前計算された祖先クロージャーを含んでいます。
{ "conceptId": "44054006", "active": true, "effectiveTime": "20020131", "moduleId": "900000000000207008", "definitionStatusId": "900000000000074008", "descriptions": [ { "id": "73465010", "term": "Diabetes mellitus type II", "typeId": "900000000000013009", "languageCode": "en", "acceptabilityMap": { "900000000000509007": "..." } } ], "relationships": [ { "typeId": "116680003", "destinationId": "73211009", "relationshipGroup": "0", "active": "1" } ], "inferredParentIds": ["73211009"], "inferredAncestorIds": ["73211009", "64572001", "138875005"], "inferredChildIds": ["..."], "relationshipAttributeKeys": ["116680003|73211009"], "memberOfRefsetIds": ["..."], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "releaseAppliedAt": "2026-07-06T00:00:00.000Z" }
snomed-irdbには、次の関連フィールドが含まれています。
conceptId: SNOMED 識別子 (SCTID)、つまり安定した概念アイデンティティを表します。descriptions[]: コンセプトの人間が読み取り可能な名前を表します。各名称は同義語または完全指定名 (正式な臨床名)であり、その言語と、その言語で優先されるか、または許容されるかをレコードします。これらのエントリは、SNOMED CT リリース ファイル内の説明行に対応します。relationships[]: コンセプトと他のコンセプトとの関係を表します。「である」関係によって階層が定義されます。属性関係により、発見場や原因エージェントなどの臨床的なプロパティが定義されます。relationshipAttributeKeys[]: 各属性関係を単一のインデックス値として表します。これにより、アプリケーションは特定の属性によって概念を検索し、フルスキャンの代わりにインデックスで結果を返すことができます。inferredParentIds,ChildIds、AncestorIds:グラフトラバーサルなしで包含のために、界限のある事前計算されたクロージャーを表します。子孫は、すべての親概念に保存 (する)されるのではなく、{ inferredAncestorIds: conceptId }句を使用してクエリされます。
snomed-term-search コレクションテスト
snomed-term-search を検索プロジェクションとして使用します。各ドキュメントは、MongoDB Search、スコープされたフィルター、および自動埋め込み MongoDB Vector Search のために非正規化された、1 つの言語と 1 つのリリースにおける 1 つの有効な説明期間を表します。この構造により、ユーザーは同義語、略語、ローカル化された用語、正式な臨床名、または自然言語の詞句を入力できます。
検索ドキュメントは、各検索結果が完全に独立しているように、概念のコンテキストを繰り返します。結果には、一致した期間、常用の表示、意味的カテゴリ、アクティブステータス、リリース、および階層スコープを表示できます。これは、候補の完全な概念ドキュメントを取得することなく行えます。
{ "conceptId": "44054006", "descriptionId": "116680003", "term": "Type 2 diabetes mellitus", "preferredTerm": "Type 2 diabetes mellitus", "fsn": "Type 2 diabetes mellitus (disorder)", "semanticTag": "disorder", "semanticTagKey":"disorder", "termType": "synonym", "preferred": true, "languageCode": "en", "definitionStatusId": "900000000000074008", "moduleId": "900000000000207008", "effectiveTime": "20020131", "parentIds": ["73211009"], "ancestorIds": ["404684003", "73211009"], "topRoots": ["404684003"], "areaTags": ["disorder"], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "embedText": "Type 2 diabetes mellitus | disorder | ..." }
snomed-term-search コレクションには、次の関連フィールドが含まれています。
conceptId、descriptionId: 概念と特定の説明へリンクします。term、preferredTerm、fsn:一致する用語と概念のコンテキストを提供し、検索結果が完結するようにします。semanticTag,semanticTagKey、termType、preferred: フィルターリングとランキングのシグナルを提供します。parentIds,ancestorIds、topRoots、areaTags:snomed-irbdに戻さずに結合するスコープ フィルター。releaseId、releaseDate、effectiveTime:リリーススコープの検索とリリースメンテナンスの可視性を提供します。embedText: MongoDB がベクトル検索に自動埋め込みで使用するフィールドが含まれています。
このスニペットでは、最も重要なデザインの選択である検索プロジェクションが検索語レベルであることを説明します。これにより、「高血糖」の検索でも、正式な概念である「糖尿病」が返される理由がわかります。
自動埋め込みを使用すると、人間が読み取り可能な embedText フィールドのみを保存し、MongoDB ベクトル検索がそのフィールドの埋め込みを自動的に生成および維持します。セマンティック レイヤーは同じコレクション上に存在するため、別の埋め込みパイプラインやベクトル ストアは必要ありません。
grounded_notes コレクション
検討後に、grounded_notes を使用してアプリケーションの出力を保存します。これらのドキュメントは、ソース用語データではありません。各ドキュメントには、次のデータが保存されます。
ソース テキスト
選択した SNOMED CT コンセプト
証拠スパン
存在または不存在などのアサーションコンテキスト
患者や家族などの主題コンテキスト
検討ステータス
祖先 ID
以下の例にこの形状を示します。
{ "tenantId": "demo-hospital", "languageCode": "en", "text": "Patient with type 2 diabetes mellitus.", "codings": [ { "conceptId": "44054006", "system": "http://snomed.info/sct", "display": "Type 2 diabetes mellitus", "semanticTag": "disorder", "role": "principal", "target": "Condition.code", "assertion": "present", "subject": "patient", "status": "accepted", "evidence": { "text": "diabetes mellitus tipo 2" }, "ancestorIds": ["44054006","75934005"] } ], "recordedAt": "2026-07-07T16:22:47.210Z", "createdAt": { "$date": "2026-07-07T16:22:47.210Z" } }
このデザインにより、臨床テキストがクエリ可能な臨床的意味に変換されます。アプリケーションは、後でSNOMED CTヒエラルキー内のコンセプトまたはその下のより具体的なコンセプトを含む検討済みのノートを検索できます。各コーディングはその証拠を保持するため、検討者はすべてのコードを生成した正確なテキストとコンテキストにたどり着くことができ、監査と信頼できるダウンストリームでの使用をサポートします。
テレメトリコレクション
検索イベント、階層リクエスト、ノートグラウンディングアクティビティ、フィードバック、および診断には別の telemetry コレクションを使用します。テレメトリー データは、概念的なデータモデルの外に保持します。
ソリューションのビルド
パブリックリポジトリには、アプリケーションコード、スクリプト、サンプルデータセットが含まれています。ライセンスされたユーザーは、サンプルデータセット を独自の SNMP TT リリース ファイルに置き換えることができます。
前提条件
MongoDB Search が有効になっている MongoDB Atlas クラスター。
ライセンスを取得した SNOMED CT リリースまたはデモ用の小さなサンプルデータセットへのアクセス。
デモアプリケーション用の Node.js と npm。
任意: セマンティック検索用のMongoDB ベクトル検索自動埋め込み構成。
任意: ハイブリッド モード用の Voyage リランキング キーまたはその他の構成済みのリランカー。
任意: 境界の抽出と候補のあいまいさを解消するための LLM ゲートウェイ。
手順
正規の概念ドキュメントを準備する
正規コレクションには、各コンセプトがコンセプト中心のドキュメントとして保存され、その説明、関係、親、祖先、および階層情報が含まれます。このスキーマには、アクティブおよび非アクティブなステータス、リリースを考慮したルックアップ、説明の検査、および関係のナビゲーションをサポートするためのソースメタデータが含まれています。
コレクションをロードしたら、フィールドを正規化してコンシステントなルックアップを行い、各ドキュメントにリリースバージョンを記録して、リリース間で結果を再現できるようにします。
NORMALIZE_APPLY=true npm run model:harden # normalize SCTIDs / strings RELEASE_ID_TARGET=20260601 RELEASE_ID_OVERWRITE=true npm run releaseid:stamp
期間サイドカーをビルドする
正規の概念コレクションから snomed-term-search を生成します。サイドカーは、リリース、言語、説明、概念ごとに 1 つのアクティブな期間ドキュメントを保存します。検索結果がカードごとに概念コレクションに再度参加する必要がないように、主要な概念コンテキストを繰り返します。
# Curated demo branches TERM_PROJECTION_SCOPE=demo npm run terms:rebuild # Full licensed local release TERM_PROJECTION_SCOPE=full npm run terms:rebuild # Replace documents while preserving index definitions when possible npm run terms:rebuild:replace
MongoDB インデックスの作成
概念のルックアップと階層展開のために btree インデックスを作成します。詞書用語のルックアップ用の MongoDB Search インデックスを作成します。セマンティックモードまたはハイブリッドモードを使用する場合は、セマンティック検索用の MongoDB ベクトル検索インデックスを作成します。
npm run indexes:build
次の推奨されるソースコレクションインデックスを使用します。
db.getCollection("snomed-irbd").createIndex({ releaseId: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, active: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, inferredAncestorIds: 1, active: 1 })
セマンティック検索では、Voyage-4 をデフォルトモデルとして使用した MongoDB ベクトル検索の自動埋め込みが使用されます。ハイブリッドモードには Voyage rerank-2.5reranker が追加されます。自動埋め込みのないクラスターには、手動の Voyage 埋め込みフォールバックが存在します。
セマンティック検索 & リランキングの構成
セマンティック検索とハイブリッド検索では、MongoDB ベクトル検索の自動埋め込みを使用します。クラスター上で構成された埋め込みモデルを使用して、embedText フィールド上にベクトル検索インデックスを作成します。
ハイブリッド モードには任意の Voyage リランカーが追加されます。VOYAGE_API_KEY を設定して有効にします。キーがない場合でもハイブリッド検索は引き続き機能し、フュージョンオーダーにフォールバックします。リランカーは、設定されたベース URL、次に https://ai.mongodb.com/v1 に対応する MongoDB ホストの Voyage ゲートウェイを試します。その後、Voyage 自体のネイティブ プラットフォーム エンドポイントとなる接続されたデバイス。
デモアプリケーションを実行します
npm install npm run dev
リーンな .env.local ファイルを使用します。操作デフォルトは、環境変数の長いリストとしてではなく、コードまたは構成ファイル内で保持します。
MONGODB_URI= MONGODB_DB=terminology VOYAGE_API_KEY= ENABLE_LLM_GROUNDING=false LLM_BASE_URL= LLM_API_KEY= LLM_AUTH_HEADER=api-key LLM_GROUNDING_MODEL=gpt-5.5 # Semantic / hybrid search MONGODB_VECTOR_MODE=autoEmbed MONGODB_VECTOR_INDEX=snomed_voyage_idx MONGODB_VECTOR_AUTO_EMBED_MODEL=voyage-4 VOYAGE_API_KEY= VOYAGE_RERANK_MODEL=rerank-2.5
キーポイント
MongoDB Atlas で SNOMED CT を運用化: 検索、階層、関係、アプリケーション ワークフローをサポートするドキュメント中心の運用モデルを通じて、グラフ形式の臨床用語を提供します。
用語ナビゲーションとセマンティック検索の統一: MongoDB Search と MongoDB ベクトル検索 を使用して、ユーザーが同じ Atlas バックのサービスから SNOMED CT の概念を検索、検査、範囲設定できるようにします。
検討された証拠を含む基礎臨床テキスト: 用語サービスを使用して臨床ノートから SNOMED CT 候補を提案し、次に、検討されたコーディングを証拠、コンテキスト、および祖先パスとともに保存する。
作成者
Francesc Mateu Amengual, MongoDB
Giovanni Rodríguez, MongoDB
Diego Canales, MongoDB
詳細
MongoDB Search 概要: MongoDB がフルテキスト検索、オートコンプリート、フィルター、スコアリング、および検索駆動型アプリケーションの体験をサポートする方法を説明します。
MongoDB ベクトル検索の概要。MongoDBがAtlas内でセマンティック取得とベクトル検索をサポートする方法を学びます。
SNOMED CMK の取得: 組織が STOPOED CMK にアクセスし、国または地域のライセンス パスを理解する方法を確認します。