Overview
在本指南中,您可以了解如何使用 GridFS 规范在 MongoDB 中存储和检索大文件。GridFS 将大文件分割为数据段,并将每个数据段存储为一个单独的文档。当您查询 GridFS 中的文件时,驱动程序会根据需要组合这些数据段。GridFS 的驱动程序实现是一个用来管理文件存储的操作和组织的抽象。
如果文件大小超过 16 MB 的BSON文档大小限制,请使用GridFS 。GridFS还可以帮助您访问权限文件,而无需将整个文件加载到内存中。有关 GridFS 是否适合您的使用案例的更多详细信息,请参阅 GridFS 服务器手册页面。
GridFS 的工作原理
GridFS 在存储桶中组织文件,存储桶是一组包含文件数据段及其描述信息的MongoDB 集合。存储桶包含了以下集合:
chunks集合,存储二进制文件数据段。files集合,用于存储文件元数据。
当你创建新的 GridFS 存储桶时,驱动程序会创建前面的集合。除非指定不同的存储桶名称,否则默认存储桶名称 fs 将作为集合名称的前缀。驱动程序在第一次写操作期间创建新的 GridFS 存储桶。
驱动程序还会在每个集合上创建一个索引,以确保高效地检索文件和相关元数据。当索引尚不存在以及存储桶为空时,驱动程序会创建索引。有关 GridFS 索引的更多信息,请参阅服务器手册中的 GridFS 索引页面。
使用 GridFS 存储文件时,驱动程序会将文件拆分成较小的数据段,每个数据段由 chunks 集合中的单独文档表示。它还会在 files(文件)集合中创建一个文档,其中包含文件 ID、文件名以及其他文件元数据。如下图表展示了 GridFS 如何分割所上传的文件:
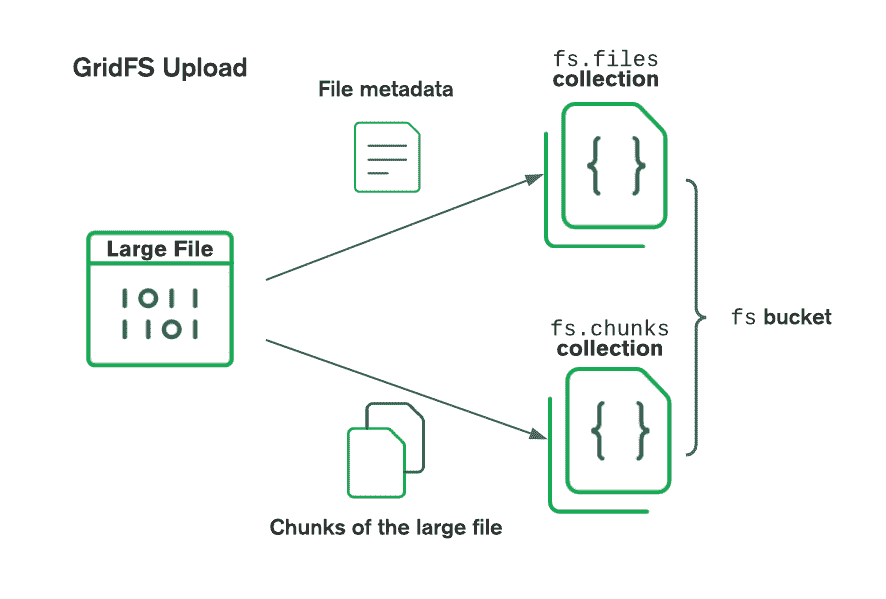
当检索文件时,GridFS 从指定的存储桶上的 files(文件)集合中获取元数据,并使用这些信息从 chunks(数据段)集合中的文档中重建文件。您可以将文件读取到内存中,或者将其输出到流。
使用 GridFS
要了解 GridFS 操作以及如何执行这些操作,请浏览以下部分:
创建 GridFS 存储桶
若要从 GridFS 存储或检索文件,请创建存储桶或获取对 MongoDB 数据库上现有存储桶的引用。要创建 GridFSBucket 实例,请使用数据库参数调用 NewBucket() 方法:
db := client.Database("db") bucket, err := gridfs.NewBucket(db) if err != nil { panic(err) }
注意
如果 GridFS 存储桶已经存在,则 NewBucket() 方法将返回该存储桶的引用,而不是实例化新的存储桶。
默认情况下,新存储桶名为 fs。要使用自定义名称实例化存储桶,请在 BucketOptions 实例上调用 SetName() 方法,如下所示:
db := client.Database("db") opts := options.GridFSBucket().SetName("custom name") bucket, err := gridfs.NewBucket(db, opts) if err != nil { panic(err) }
上传文件
您可以通过以下方式之一将文件上传到 GridFS 存储桶:
使用
UploadFromStream()方法,从输入流中读取数据。使用
OpenUploadStream()方法,该方法可以写入到输出流。
For either upload process, you can specify configuration information on an instance of UploadOptions. For a full list of UploadOptions fields, visit the API documentation.
使用一个输入流上传
要上传包含输入流的文件,请使用具有以下参数的 UploadFromStream() 方法:
您的文件名
一个
io.Reader,将您打开的文件用作一个参数一个用来修改
UploadFromStream()行为的可选opts参数
如下代码示例将从一个名为 file.txt 的文件中读取内容,并将内容上传到一个 GridFS 存储桶。它使用一个 opts 参数设置文件元数据:
file, err := os.Open("path/to/file.txt") uploadOpts := options.GridFSUpload().SetMetadata(bson.D{{"metadata tag", "first"}}) objectID, err := bucket.UploadFromStream("file.txt", io.Reader(file), uploadOpts) if err != nil { panic(err) } fmt.Printf("New file uploaded with ID %s", objectID)
使用输出流上传
要使用输出流上传文件,请使用带有以下参数的 OpenUploadStream() 方法:
您的文件名
一个用来修改
OpenUploadStream()行为的可选opts参数
如下代码示例将在一个 GridFS 存储桶上打开一个上传流,并使用 opts 参数设置每个数据段中的字节数。随后,它对 file.txt 的内容调用 Write() 方法,以便将其内容写入到流:
file, err := os.Open("path/to/file.txt") if err != nil { panic(err) } // Defines options that specify configuration information for files // uploaded to the bucket uploadOpts := options.GridFSUpload().SetChunkSizeBytes(200000) // Writes a file to an output stream uploadStream, err := bucket.OpenUploadStream("file.txt", uploadOpts) if err != nil { panic(err) } fileContent, err := io.ReadAll(file) if err != nil { panic(err) } var bytes int if bytes, err = uploadStream.Write(fileContent); err != nil { panic(err) } fmt.Printf("New file uploaded with %d bytes written", bytes) // Calls the Close() method to write file metadata if err := uploadStream.Close(); err != nil { panic(err) }
检索文件信息
您可以检索 GridFS 存储桶的 files(文件)集合中存储的文件元数据。files(文件)集合中的每个文档都包含以下信息:
文件 ID
文件长度
最大数据库大小
上传日期和时间
文件名
您可以在其中存储任何其他信息的
metadata文档
要检索文件数据,请在 GridFSBucket 实例上调用 Find() 方法。您可以将查询过滤器作为参数传递给 Find(),以仅匹配某些文件文档。
注意
Find() 方法需要查询筛选器作为参数。要匹配 files 集合中的所有文档,请将空查询筛选器传递给 Find()。
以下示例会检索 files 集合中 length值大于 1500 的文档的文件名和长度:
filter := bson.D{{"length", bson.D{{"$gt", 1500}}}} cursor, err := bucket.Find(filter) if err != nil { panic(err) } type gridfsFile struct { Name string `bson:"filename"` Length int64 `bson:"length"` } var foundFiles []gridfsFile if err = cursor.All(context.TODO(), &foundFiles); err != nil { panic(err) } for _, file := range foundFiles { fmt.Printf("filename: %s, length: %d\n", file.Name, file.Length) }
下载文件
您可以通过以下方式之一下载 GridFS 文件:
使用
DownloadToStream()方法将一个文件下载到一个输出流。使用
OpenDownloadStream()方法打开一个输入流。
将文件下载到输出流
您可以使用 DownloadToStream() 方法将 GridFS 存储桶中的文件直接下载到输出流。DownloadToStream() 将文件 ID 和 io.Writer 作为参数。该方法下载指定文件 ID 的文件,并将其写入 io.Writer。
以下示例下载文件并写入文件缓冲区:
id, err := primitive.ObjectIDFromHex("62f7bd54a6e4452da13b3e88") fileBuffer := bytes.NewBuffer(nil) if _, err := bucket.DownloadToStream(id, fileBuffer); err != nil { panic(err) }
将文件下载到输入流
可以使用 OpenDownloadStream() 方法通过输入流将 GridFS 存储桶中的文件下载到内存。OpenDownloadStream() 会将文件 ID 作为参数并返回一个输入流,您可以从中读取文件。
如下示例将一个文件下载到内存中并读取它的内容:
id, err := primitive.ObjectIDFromHex("62f7bd54a6e4452da13b3e88") downloadStream, err := bucket.OpenDownloadStream(id) if err != nil { panic(err) } fileBytes := make([]byte, 1024) if _, err := downloadStream.Read(fileBytes); err != nil { panic(err) }
重命名文件
可以使用 Rename() 方法更新存储桶中 GridFS 文件的名称。将文件 ID 值和新的 filename 值作为参数传递给 Rename()。
如下示例将一个文件重命名为 "mongodbTutorial.zip":
id, err := primitive.ObjectIDFromHex("62f7bd54a6e4452da13b3e88") if err := bucket.Rename(id, "mongodbTutorial.zip"); err != nil { panic(err) }
删除文件
您可以使用 Delete() 方法从 GridFS 存储桶中删除文件。将文件 ID 值作为参数传入 Delete()。
以下示例删除文件:
id, err := primitive.ObjectIDFromHex("62f7bd54a6e4452da13b3e88") if err := bucket.Delete(id); err != nil { panic(err) }
删除 GridFS 存储桶
您可以使用 Drop() 方法删除一个 GridFS 存储桶。
以下代码示例会删除 GridFS 存储桶:
if err := bucket.Drop(); err != nil { panic(err) }
其他资源
要了解有关 GridFS 及其操作的更多信息,请访问 GridFS 手册页面。
API 文档
要进一步了解本指南所讨论的方法或类型,请参阅以下 API 文档: