Aprenda a modelar, pesquisar, navegar e fundamentar a terminologia clínica SNOMED CT com o MongoDB Atlas.
Casos de uso: Interoperabilidade
Setores: Saúde
Produtos: MongoDB Atlas, MongoDB Search, MongoDB pesquisa vetorial, Voyage AI
Visão Geral da Solução
Os aplicativos de assistência médica precisam entender o significado clínico, não apenas armazenar texto clínico. Um médico pode escrever “insuficiência cardíaca”, “insuficiência cardíaca” ou “insuficiência cardíaca”. Diferentes palavras podem descrever a mesma ideia clínica. A codificação clínica oferece aos aplicativos uma maneira padrão de representar esse significado com identificadores estáveis.
As equipes de saúde usam sistemas de codificação diferentes para fins diferentes. Alguns sistemas de codificação agrupam diagnósticos e consultas para análise de relatórios, estatísticas, pagamentos ou consultas. OSNOMED CM se concentra no significado médico dentro do registro de saúde. Pode representar problemas, resultados, procedimentos, estruturas do corpo, organizações, compostos, produtos e muitas outras ideias médicas. O SNOMED TOC oferece suporte a aplicativos para pesquisar, trocar, analisar ou raciocinar sobre informações médicas registradas em um registro eletrônico de saúde.
A SNOMED International descreve a SNOMED CT como uma terminologia clínica com conceitos que têm significados únicos, definições formais e organização hierárquica.
O SNOMED CT tem uma estrutura semelhante a um grafo. Existem mais de 500,000 conceitos clínicos em que cada um pode ter várias descrições legíveis por humanos, incluindo sinônimos e traduções. Ele pode ter conceitos pai, conceitos filho, ancestrais e relacionamentos formais com outros conceitos. O SNOMED CT representa o conteúdo da terminologia por meio de conceitos, descrições e relacionamentos da seguinte forma:
Um conceito representa uma ideia clínica.
Uma descrição vincula um termo legível por humanos a esse conceito.
Um relacionamento conecta um conceito a outro.
Essa estrutura é poderosa, mas cria desafios de implementação. As equipes de aplicativos precisam de pesquisa rápida de termos, pesquisa multilíngue, navegação hierárquica, expansão descendente e inspeção de relacionamento. Eles também precisam usar a terminologia do SNOMED em fluxos de trabalho, como revisão de notas clínicas, criação de lista de problemas, suporte à decisão, descoberta de coortes e pesquisa semântica. As implementações tradicionais geralmente dividem essas necessidades em vários sistemas:
Um banco de dados relacional para os arquivos de terminologia.
Um mecanismo de pesquisa para consulta de texto.
Um banco de dados de grafo para travessia de hierarquia.
Um banco de dados vetorial para pesquisa semântica.
Esta solução mostra como operacionalizar o SNOMED CT no MongoDB Atlas da seguinte forma:
Armazene cada conceito SNOMED como um documento MongoDB que mantém a identidade do conceito, descrições, relacionamentos, pais, filhos e caminhos ancestrais juntos.
Crie uma projeção de pesquisa de nível de termo para MongoDB Search e MongoDB pesquisa vetorial.
Use arrays ancestrais e índices multikey para oferecer suporte a hierarquia comum e queries descendentes sem um banco de dados de grafo separado.
Use o mesmo serviço de terminologia para fundamentar notas clínicas em candidatos SNOMED
Armazene codificações revisadas com evidências, contexto e caminhos ancestrais.
Por exemplo, um usuário pode pesquisar por "insuficiência" O SNOMED TOC muitas vezes utiliza ECL para expressar esse tipo de expansão descendente. A ECL funciona como uma linguagem de query compacta para descrever conjuntos de conceitos do SNOMED TO. Por exemplo, a expressão << Heart failure refere-se a "insuficiência cardíaca e todos os conceitos abaixo dela na hierarquia". No design de esquema do MongoDB, esse padrão mapeia naturalmente para uma query sobre arrays ancestrais pré-computadas. A referência ECL oficial do SNOMED define o operador << como "descendente ou auto de", que recupera um conceito e seus subtipos.
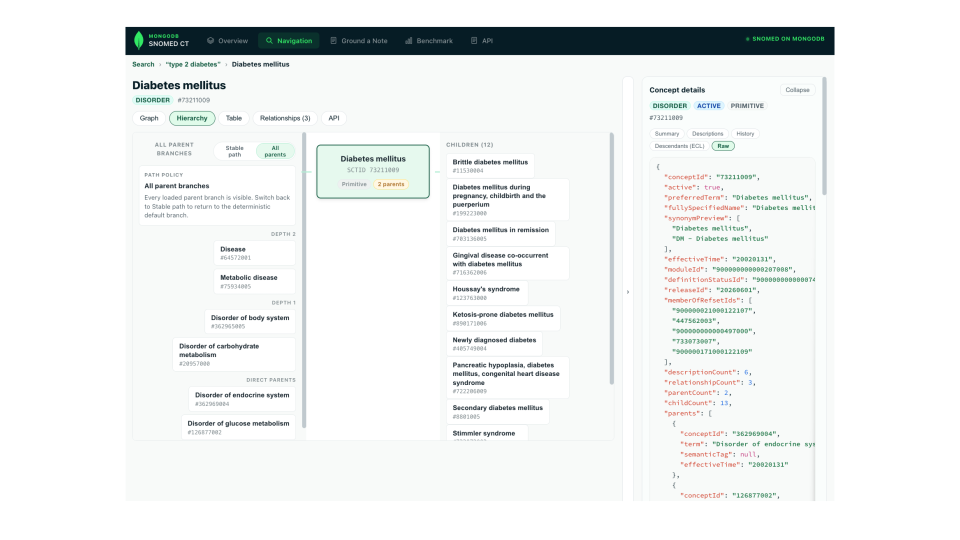
Figura 1. Conceito clínico com sua hierarquia de pais e filhos
A solução também demonstra o aterramento de notas clínicas. Uma nota pode conter achados atuais, histórico passado, histórico familiar, ações planejadas, declarações incertas e achados negados. O aplicativo extrai termos clínicos candidatos, pesquisa SNOMED CT por meio do MongoDB, propõe conceitos candidatos e armazena codificações revisadas somente após a confirmação. A codificação armazenada mantém o período de evidência original, o conceito SNOMED selecionado, o contexto de asserção, o status do revisor e o caminho do ancestral. Os aplicativos downstream podem então query por significado clínico, não apenas por palavras exatas.
Use esta solução quando precisar:
Pesquise termos clínicos, sinônimos, traduções e identificadores SNOMED.
Navegue pelas visualizações pai, filho, ancestral, descendente e de relacionamento.
Suporte à pesquisa de terminologia lexical, semântica e híbrida de uma coleção do MongoDB.
Expanda conjuntos de conceitos com expressões de hierarquia no estilo ECL, como “todos os descendentes de insuficiência cardíaca”.
Notas clínicas básicas para candidatos SNOMED CT com intervalos de evidências e revisão humana.
Armazene codificações SNOMED revisadas com caminhos ancestrais para query downstream indexadas.
Esse padrão oferece às equipes de aplicativos uma plataforma operacional para dados de terminologia, pesquisa de terminologia, recuperação semântica, query de hierarquia, captura de evidências clínicas e saída de codificação auditada. Ele reduz a necessidade de executar sistemas separados para armazenamento de documentos, pesquisa, recuperação semântica e navegação estilo grafo.
Nota de licenciamento do SNOMED CT: O repositório público associado a esta solução inclui apenas um pequeno conjunto de dados de amostra. O SNOMED CT exige licenciamento adequado.
Arquiteturas de referência
Esta arquitetura de referência consiste em um fluxo de trabalho de Navegação e Nota Clínica básica.
A navegação ajuda um usuário de terminologia a pesquisar, inspecionar e definir o escopo dos conceitos SNOMED CT. A Ground Clinical Note reutiliza a mesma camada de recuperação de terminologia, usando a pesquisa lexical determinística por padrão, para propor candidatos SNOMED CT a partir de texto clínico e armazenar apenas codificações revisadas.
A arquitetura usa um conjunto de coleções MongoDB:
A coleção
snomed-irbdarmazena a visualização de terminologia de fonte de verdade.O
snomed-term-searchoferece suporte a pesquisas de terminologia de alta qualidade.A coleção
grounded_notesarmazena a saída do aplicativo revisada, não os dados de terminologia de origem.
O conteúdo do SNOMED CT tem formato de grafo. Essa arquitetura mantém as estruturas conectadas juntas em documentos do MongoDB e usa projeções de pesquisa e arrays de ancestrais para torná-las operacionais.
Arquitetura em um relance
Essa implementação começa com um pacote de conteúdo SNOMED CM autorizado que já está disponível como um modelo de conceito JSON. Na demonstração atual, o modelo de origem vem da distribuição internacional SNOMED CM da Espanha usada pelo Min stério da Saúde. O repositório público inclui apenas um conjunto de dados de amostra. Ele não redistribui a terminologia completa do SNOMED CM.
A arquitetura é independente do formato de origem. Se uma organização receber o SNOMED CT como JSON, ela poderá carregar esse modelo diretamente no MongoDB.

Figura 2. MongoDB como autoridade de código, com um gateway LLM opcional e limitado a candidatos.
O modelo de destino tem as seguintes coleções de terminologia:
snomed-irbd: Armazena cada conceito clínico com suas descrições, relacionamentos, pais, filhos, ancestrais, status ativo, metadados de liberação e metadados de associação. Os aplicativos usam essa coleção para pesquisa de conceitos, navegação de hierarquia, inspeção de relacionamento e expansão de descendentes.snomed-term-search: Armazena um documento pesquisável por termo ativo, idioma e versão. Os aplicativos usam essa projeção para pesquisa lexical, pesquisa semântica, pesquisa híbrida, filtro de idioma e filtro de escopo.
A API de navegação usa o snomed-term-search para encontrar conceitos correspondentes. Em seguida, ele enriquece os resultados selecionados da coleção snomed-irbd. Um usuário pode pesquisar uma frase clínica como “insuficiência cardíaca”, inspecionar o conceito selecionado, visualizar conceitos mais amplos e mais específicos e abrir exemplos de API para a mesma operação.
A API de aterramento reutiliza a camada de recuperação de terminologia dentro de um fluxo de trabalho de nota clínica. A recuperação de aterramento padroniza a pesquisa lexical determinística, enquanto a navegação oferece modos lexicais, semânticos e híbridos. O tier LLM opcional pode ajudar a interpretar texto e escolher entre os candidatos fornecidos pelo MongoDB, mas não deve criar novos identificadores SNOMED CT.
Após a revisão, o aplicativo armazena codificações confirmadas em grounded_notes. Cada codificação mantém o conceito SNOMED CT selecionado, o texto de evidência, o contexto de asserção, o contexto do assunto, o status do revisor e os IDs do ancestral. Os aplicativos downstream podem então fazer query fatos clínicos revisados por significado, não apenas por palavras exatas.
Fluxo de trabalho de navegação
Um usuário pesquisa um termo clínico como "insuficiência cardíaca". O aplicativo consulta a projeção de pesquisa de termos e retorna resultados de nível de conceito agrupados por conceito SNOMED.
Cada resultado mostra:
O termo que correspondeu à query do usuário
A exibição preferencial para o conceito
O nome clínico formal
O identificador SNOMED
O status ativo
A categoria semântica
O lançamento
A proveniência da pesquisa
O usuário pode então abrir a visualização de foco do conceito. Esta visualização mostra o resumo do conceito, descrições, conceitos pai, conceitos filho, relacionamentos, descendentes, documento bruto e exemplos de API.
A navegação suporta estes modos de pesquisa:
A pesquisa lexical usa o MongoDB Search para termos exatos, sinônimos, nomes formais, identificadores, prefixos e texto difuso.
A pesquisa semântica usa o MongoDB pesquisa vetorial, que incorpora automaticamente o campo
embedTextdo termo com o modelo de referência voyage-4. Assim, a recuperação por significado é executada na mesma coleção sem exigir um armazenamento vetorial separado ou um pipeline de embedding.A pesquisa híbrida combina recuperação lexical e vetorial. Se um reranker de codificador cruzado Voyage estiver configurado, o aplicativo rerank o pool de candidatos fundidos; caso contrário, ele volta para a ordem de fusão.
A tela de pesquisa também oferece suporte ao escopo semântico. Um usuário pode limitar os resultados a uma ampla área clínica, como achado clínico, procedimento, estrutura corporal ou substância. Um usuário também pode usar uma expressão descendente, como << 404684003, para restringir os resultados a um conceito e seus conceitos mais específicos.
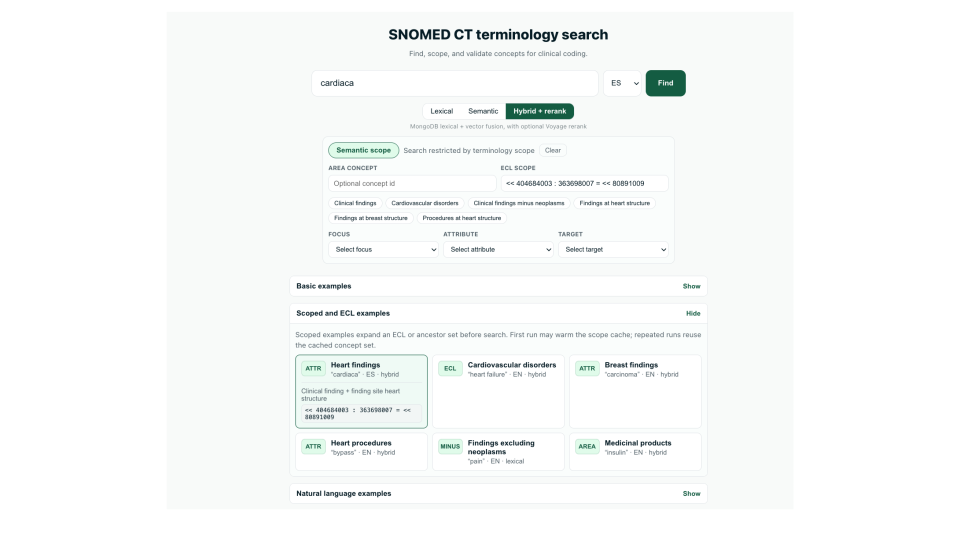
Figura 3. Pesquisa semântica expandida com escopos ECL
Fluxo de trabalho de nota clínica terrestre
Um usuário cola uma nota clínica. O fluxo de trabalho extrai menções clínicas e dicas de contexto, como achados atuais, negação, histórico, histórico familiar, ações planejadas, incerteza e expressões temporais.
O fluxo de trabalho pesquisa candidatos SNOMED CT por meio do MongoDB. Ele retorna candidatos revisáveis com intervalos de evidências e contexto. Um revisor pode aceitar, rejeitar ou marcar cada candidato para revisão.
O tier LLM opcional pode ajudar na interpretação de texto e na seleção de candidatos. Ele só deve escolher entre os candidatos retornados pelo MongoDB. Ele não deve criar novos identificadores SNOMED ou persistir codificações sem revisar.
Após a revisão, o aplicativo armazena as codificações confirmadas em grounded_notes. Cada codificação salva inclui o período de evidência, o conceito SNOMED selecionado, a asserção, o assunto, o status e os IDs do ancestral. Esse padrão permite que os aplicativos downstream consultem a query. Por exemplo, um aplicativo pode encontrar notas revisadas que contêm qualquer descendente aceito de um conceito clínico selecionado.
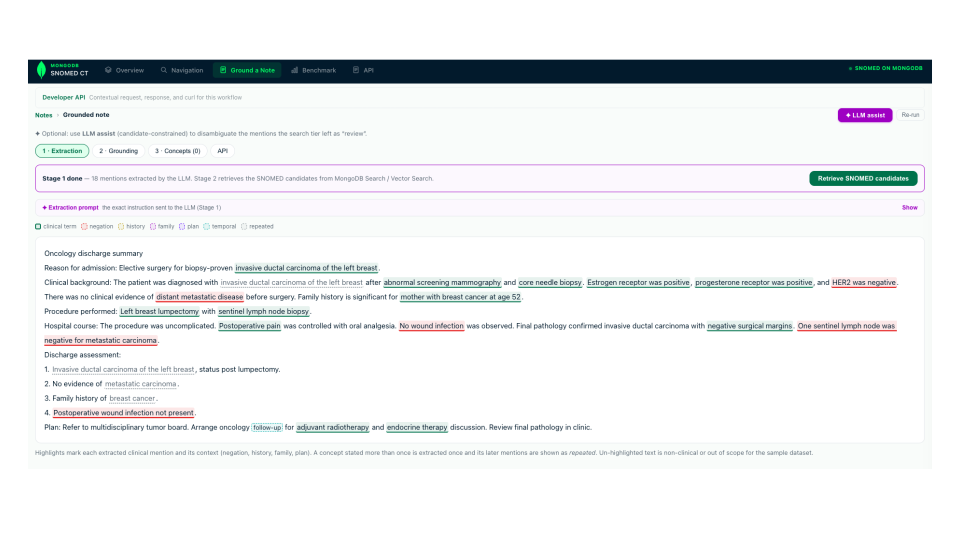
Figura 4. Aterramento de uma nota clínica - processo LLM
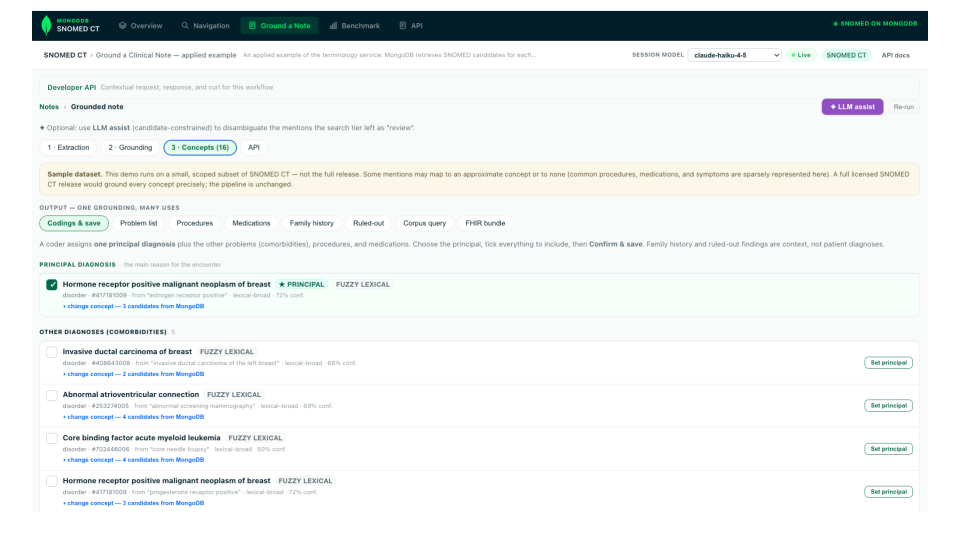
Figura 5. Fundamentando uma nota clínica após a pesquisa de termo com o MongoDB
Exemplos de trechos de API
A solução expõe APIs para os fluxos de trabalho de navegação e nota clínica terrestre. Esses trechos mostram os padrões de solicitação principais.
Pesquisar termos e conceitos SNOMED
Use este ponto de extremidade para pesquisar a projeção de nível de termo. A resposta agrupa os termos correspondentes de volta aos conceitos SNOMED. Ele retorna resultados de nível de conceito com o termo correspondente, exibição preferencial, categoria semântica e proveniência da pesquisa.
POST /api/navigator-search { "query": "heart failure", "languageCode": "en", "mode": "lexical", "limit": 24 }
Use o modo léxico quando o usuário pesquisar por um termo conhecido, sinônimo, nome formal ou identificador SNOMED. A API também oferece suporte a modos semânticos e híbridos quando a demonstração está configurada para MongoDB pesquisa vetorial e reranking.
Expandir um conceito e seus descendentes
Use este ponto de extremidade para expandir um conjunto de conceitos. O SNOMED CT usa o ECL para descrever conjuntos de conceitos. Neste exemplo, a expressão << 84114007 significa “Insuficiência cardíaca e todos os conceitos mais específicos abaixo dela.”
POST /api/ecl { "expr": "<< 84114007", "languageCode": "en", "limit": 200 }
A implementação resolve essa expressão com array de ancestrais pré-computados no MongoDB. Esse padrão torna as query de descendentes comuns rápidas sem exigir um banco de dados de grafo separado para a arquitetura de demonstração.
Aterrar uma nota clínica para candidatos SNOMED
Use este ponto de extremidade para extrair menções clínicas candidatas do texto e recuperar candidatos SNOMED limitados do MongoDB. A resposta gera saída revisável sem persistir códigos automaticamente.
POST /api/nlp-map { "text": "Patient with chronic systolic heart failure and type 2 diabetes. No evidence of chest pain at present.", "languageCode": "en" }
O fluxo de trabalho de aterramento detecta menções clínicas e contexto, como negação, histórico, histórico familiar, planos e expressão temporal. O MongoDB fornece os conceitos SNOMED candidatos. Um revisor confirma as codificações finais.
Salvar codificações confirmadas pelo revisor
Use este ponto de extremidade após a revisão. O aplicativo armazena apenas codificações confirmadas e as enriquece com IDs de ancestral para permitir query semânticas downstream.
POST /api/coding-confirm { "text": "Patient with heart failure.", "languageCode": "en", "codings": [ { "mention": "heart failure", "conceptId": "84114007", "displayTerm": "Heart failure", "semanticTag": "disorder", "accepted": true } ] }
O documento salvo mantém o conceito SNOMED selecionado, o texto de evidência, o contexto de asserção, o status do revisor e os IDs do ancestral. Esse esquema permite que as query downstream localizem notas por um conceito geral ou um descendente específico.
Query Grounded Notes by Meaning
Use este ponto de extremidade para recuperar notas revisadas que contêm um conceito SNOMED selecionado ou seus descendentes clínicos.
POST /api/grounded-corpus { "conceptId": "84114007", "includeDescendants": true, "limit": 10 }
Este ponto de extremidade demonstra o valor downstream de armazenar IDs de ancestral com codificações revisadas. Os aplicativos podem query o significado clínico em vez de pesquisar apenas palavras exatas.
Abordagem do modelo de dados
O SNOMED CT representa dados conectados. Um conceito clínico pode ter muitos termos legíveis por humanos, vários conceitos mais amplos, muitos conceitos mais específicos e relacionamentos formais com outros conceitos.
O MongoDB funciona bem para esse padrão porque a maioria dos aplicativos operacionais precisa de uma visualização centrada no conceito. Quando um usuário abre um conceito, o aplicativo precisa do identificador do conceito, termos de exibição, descrições, pais, filhos, caminho ancestral, relacionamentos, status ativo e metadados de lançamento juntos.
Essa abordagem não remove a estrutura do grafo. Ele armazena os relacionamentos e adiciona arrays amigáveis à query para padrões de navegação comuns. Por exemplo, cada documento de conceito pode armazenar seus pais diretos e seu caminho ancestral. Esse padrão permite que o aplicativo encontre conceitos mais amplos, conceitos filho e descendentes com queries MongoDB indexadas.
Por que esse model funciona
As opções de design abaixo abordam requisitos operacionais específicos: pesquisas rápidas, pesquisas precisas, travessia rápida de hierarquia e codificação auditável.
Mantenha os dados do conceito juntos: um aplicativo de terminologia geralmente precisa renderizar um cartão de conceito completo. O embedding de descrições, resumos de relacionamento, IDs pai, IDs filho e IDs ancestral mantém a visualização operacional mais útil em um documento.
Separe a pesquisa da terminologia de origem: a pesquisa é de nível de termo, não de nível de conceito. Um conceito pode ter muitas descrições em linguagens e dialetos. Uma projeção de nível de termo permite que o MongoDB Search e o MongoDB pesquisa vetorial classifiquem o termo exato que correspondeu enquanto ainda retornam o conceito canônico.
Caminhos de hierarquia de pré-computação: o SNOMED CT tem uma hierarquia rica. Muitos aplicativos precisam de query de descendentes rápidas, como “encontrar este conceito e todos os conceitos mais específicos abaixo dele”. Armazenar IDs de ancestral em cada conceito e cada codificação clínica revisada. Em seguida, use índice de várias chaves para query de hierarquia comuns.
Armazenar evidências com codificações revisadas: a codificação oferece mais valor quando o aplicativo pode explicar sua origem. Armazene o conceito SNOMED selecionado junto com o período de texto clínico, status de asserção, contexto do assunto e status do revisor. Esse padrão oferece suporte a auditoria, revisão e query downstream.

Figura 6. Metamodelo SNOMED CT e mapeamento de coleções MongoDB
Mapeamento de coleções do SNOMED CT Metamodel e MongoDB
A solução usa três coleções de terminologia, além de uma coleção de telemetria separada. As seções abaixo descrevem a forma do documento e os principais campos de cada um.
A coleção snomed-irbd
Use snomed-irbd como a visualização de fonte de verdade para um conceito SNOMED CT. Cada documento representa um conceito em uma versão, carregando suas descrições RF2, definindo relacionamentos, conceitos pai, conceitos filho, status ativo, metadados de versão e o fechamento de ancestral pré-computado que alimenta a hierarquia e a subsunção.
{ "conceptId": "44054006", "active": true, "effectiveTime": "20020131", "moduleId": "900000000000207008", "definitionStatusId": "900000000000074008", "descriptions": [ { "id": "73465010", "term": "Diabetes mellitus type II", "typeId": "900000000000013009", "languageCode": "en", "acceptabilityMap": { "900000000000509007": "..." } } ], "relationships": [ { "typeId": "116680003", "destinationId": "73211009", "relationshipGroup": "0", "active": "1" } ], "inferredParentIds": ["73211009"], "inferredAncestorIds": ["73211009", "64572001", "138875005"], "inferredChildIds": ["..."], "relationshipAttributeKeys": ["116680003|73211009"], "memberOfRefsetIds": ["..."], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "releaseAppliedAt": "2026-07-06T00:00:00.000Z" }
O snomed-irdb contém os seguintes campos relevantes:
conceptId: Representa o identificador SNOMED (SCTID); a identidade do conceito estável.descriptions[]: Representa os nomes legíveis por humanos para o conceito. Cada nome é um sinônimo ou o nome totalmente especificado (o nome clínico formal) e registra sua linguagem e se é preferencial ou aceitável nessa linguagem. Essas entradas mapeiam para as linhas de descrição nos arquivos de lançamento do SNOMED CTrelationships[]: Representa os relacionamentos do conceito com outros conceitos. O relacionamento "Is a" define a hierarquia. Os relacionamentos de atributo definem propriedades clínicas, como site de descoberta ou agente causador.relationshipAttributeKeys[]: Representa cada relacionamento de atributo como um único valor indexado. Isso permite que o aplicativo encontre conceitos por um atributo específico e retorne resultados com um índice em vez de uma varredura completa.inferredParentIds,ChildIds,AncestorIds: Representa o fechamento pré-computado limitado para subsunção sem travessia de grafo. Os descendentes são query com a cláusula{ inferredAncestorIds: conceptId }em vez de armazenados em cada conceito pai.
O teste de coleção de pesquisa de termos snomed
Use snomed-term-search como projeção de pesquisa. Cada documento representa um termo de descrição ativo em um idioma e uma versão, desnormalizado para MongoDB Search, filtro com escopo e MongoDB Vector Search autoincorporado. Essa estrutura permite que os usuários digitem um sinônimo, abreviação, termo localizado, nome clínico formal ou frase em linguagem natural.
O documento de pesquisa repete o contexto do conceito para tornar cada resultado da pesquisa autocontido. Um resultado pode mostrar o termo correspondente, a exibição preferida, a categoria semântica, o status ativo, a versão e o escopo da hierarquia sem buscar o documento completo do conceito para cada candidato.
{ "conceptId": "44054006", "descriptionId": "116680003", "term": "Type 2 diabetes mellitus", "preferredTerm": "Type 2 diabetes mellitus", "fsn": "Type 2 diabetes mellitus (disorder)", "semanticTag": "disorder", "semanticTagKey":"disorder", "termType": "synonym", "preferred": true, "languageCode": "en", "definitionStatusId": "900000000000074008", "moduleId": "900000000000207008", "effectiveTime": "20020131", "parentIds": ["73211009"], "ancestorIds": ["404684003", "73211009"], "topRoots": ["404684003"], "areaTags": ["disorder"], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "embedText": "Type 2 diabetes mellitus | disorder | ..." }
A coleção snomed-term-search contém os seguintes campos relevantes:
conceptId,descriptionId: Link de volta ao conceito e à descrição específica.term,preferredTerm,fsn: Forneça o termo correspondente e o contexto do conceito, para que os resultados da pesquisa sejam autossuficientes.semanticTag,semanticTagKey,termType,preferred: Forneça sinais de filtro e classificação.parentIdsancestorIds,topRoots,areaTags: Filtros de escopo sem retornar asnomed-irbd.releaseId,releaseDate,effectiveTime: Fornecer pesquisa com escopo de lançamento e visibilidade de manutenção de lançamento.embedText: Contém o campo que o MongoDB auto-incorpora usa para pesquisa vetorial.
Este trecho explica a escolha de design mais importante: a projeção de pesquisa é de nível de termo. Ele mostra por que uma pesquisa por “Açúcar elevado no sangue” ainda pode retornar o conceito canônico “Diabetes mellitus”
Com o auto-embedding, você armazena apenas o campo embedText legível por humanos, e a pesquisa vetorial do MongoDB gera e mantém o embedding para esse campo automaticamente. Você não precisa de um pipeline de embedding ou armazenar vetorial separado, porque a camada semântica reside na mesma coleção.
A coleção grounded_notes
Use grounded_notes para armazenar a saída do aplicativo após a revisão. Esses documentos não são dados de terminologia de origem. Cada documento armazena os seguintes dados:
O texto de origem
O conceito SNOMED CT selecionado
O período de evidência
O contexto de asserção, como presente ou ausente
O contexto do assunto, como paciente ou membro da família
O status de revisão
Os IDs ancestrais
O exemplo abaixo mostra essa forma.
{ "tenantId": "demo-hospital", "languageCode": "en", "text": "Patient with type 2 diabetes mellitus.", "codings": [ { "conceptId": "44054006", "system": "http://snomed.info/sct", "display": "Type 2 diabetes mellitus", "semanticTag": "disorder", "role": "principal", "target": "Condition.code", "assertion": "present", "subject": "patient", "status": "accepted", "evidence": { "text": "diabetes mellitus tipo 2" }, "ancestorIds": ["44054006","75934005"] } ], "recordedAt": "2026-07-07T16:22:47.210Z", "createdAt": { "$date": "2026-07-07T16:22:47.210Z" } }
Esse design transforma o texto clínico em significado clínico consultável. Um aplicativo pode pesquisar posteriormente notas revisadas que contenham um conceito ou qualquer conceito mais específico abaixo dele na hierarquia SNOMED CT. Cada codificação mantém suas evidências, para que um revisor possa rastrear cada código até o texto exato e o contexto que o produziu, o que suporta auditoria e uso confiante a jusante.
A coleção de telemetria
Use uma coleção telemetry separada para eventos de pesquisa, solicitações de hierarquia, atividade de aterramento de notas, feedback e diagnósticos. Mantenha os dados de telemetria fora do modelo de dados conceitual.
Construir a solução
O repositório público inclui o código do aplicação , os scripts e um conjunto de dados de amostra. Usuários autorizados podem substituir o conjunto de dados de amostra por seus próprios arquivos de versão do SNOMED CM.
Pré-requisitos
Um cluster do MongoDB Atlas com o MongoDB Search ativado.
Acesso a uma versão licenciada do SNOMED CT ou a um pequeno conjunto de dados de amostra para fins de demonstração.
Node.js e npm para o aplicativo de demonstração.
Opcional: configuração de embedding automatizada do MongoDB pesquisa vetorial para pesquisa semântica.
Opcional: chave de reclassificação do Voyage ou outro reclassificador configurado para o modo híbrido.
Opcional: gateway LLM para extração limitada e desambiguação de candidatos.
Procedimento
Prepare a entrada de terminologia licenciada
Use a distribuição SNOMED CT RF2 da sua organização ou uma distribuição JSON. Carregue essa entrada no MongoDB como a coleção de conceitos canônicos usando seu próprio processo de ingestão. A terminologia padrão corresponde a snomed-irdb. Esta coleção é um pré-requisito.
Os scripts neste repositório operam em uma coleção canônica pré-carregada; eles não leem arquivos RF2. Não confirme um lançamento completo em um repositório público.
Prepare documentos de conceito canônicos
A coleção canônica armazena cada conceito como um documento centrado no conceito, contendo suas descrições, relacionamentos, pais, ancestrais e informações de hierarquia. Este esquema contém metadados de origem para suportar status ativo e inativo, pesquisa com reconhecimento de versão, inspeção de descrição e navegação de relacionamento.
Depois de carregar a coleção, normalize os campos para pesquisas consistentes e registre a versão de lançamento em cada documento, para que os resultados sejam reproduzíveis em todos os lançamentos.
NORMALIZE_APPLY=true npm run model:harden # normalize SCTIDs / strings RELEASE_ID_TARGET=20260601 RELEASE_ID_OVERWRITE=true npm run releaseid:stamp
Crie o sidecar do termo
Gere snomed-term-search a partir da coleção de conceitos canônicos. O sidecar armazena um documento de termo ativo por versão, linguagem, descrição e conceito. Ele repete o contexto do conceito-chave para que os resultados da pesquisa não precisem voltar à coleção de conceitos para cada cartão de resultado.
# Curated demo branches TERM_PROJECTION_SCOPE=demo npm run terms:rebuild # Full licensed local release TERM_PROJECTION_SCOPE=full npm run terms:rebuild # Replace documents while preserving index definitions when possible npm run terms:rebuild:replace
Criar índices MongoDB
Crie os índices btree para pesquisa de conceitos e expansão de hierarquia. Crie o índice do MongoDB Search para pesquisa de terminologia lexical. Crie o índice do MongoDB pesquisa vetorial para pesquisa semântica se você usar o modo semântico ou híbrido.
npm run indexes:build
Use os seguintes índices de coleção de origem recomendados:
db.getCollection("snomed-irbd").createIndex({ releaseId: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, active: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, inferredAncestorIds: 1, active: 1 })
A pesquisa semântica usa o auto-embedding do MongoDB pesquisa vetorial com o voyage-4 como modelo padrão. O modo híbrido adiciona o Voyage rerank-2.5 reranker. Existe um fallback manual de embedding do Voyage para cluster sem auto-embedding.
Configurar pesquisa semântica e reclassificação
A pesquisa semântica e híbrida usa o auto-embedding do MongoDB pesquisa vetorial. Crie um índice de pesquisa vetorial no campo embedText com um modelo de embedding configurado no cluster.
O modo híbrido adiciona um reranker Voyage opcional; defina VOYAGE_API_KEY para ativá-lo. Sem uma chave, a pesquisa híbrida ainda funciona e retorna à ordem de fusão. O reranker tenta seu URL base configurado, depois o gateway Voyage hospedado no MongoDB correspondente a https://ai.mongodb.com/v1, então o próprio ponto de extremidade da plataforma nativa do Voyage.
Execute o aplicativo de demonstração
npm install npm run dev
Use um arquivo .env.local enxuto. Mantenha os padrões operacionais em código ou arquivos de configuração, não como uma longa lista de variáveis de ambiente.
MONGODB_URI= MONGODB_DB=terminology VOYAGE_API_KEY= ENABLE_LLM_GROUNDING=false LLM_BASE_URL= LLM_API_KEY= LLM_AUTH_HEADER=api-key LLM_GROUNDING_MODEL=gpt-5.5 # Semantic / hybrid search MONGODB_VECTOR_MODE=autoEmbed MONGODB_VECTOR_INDEX=snomed_voyage_idx MONGODB_VECTOR_AUTO_EMBED_MODEL=voyage-4 VOYAGE_API_KEY= VOYAGE_RERANK_MODEL=rerank-2.5
Validar navegação
Execute as seguintes operações para verificar seu fluxo de trabalho de navegação:
Execute uma pesquisa lexical para diabetes e insuficiência cardíaca.
Execute uma pesquisa semântica ou híbrida para frases de linguagem natural, como açúcar elevado no sangue ou dificuldade para respirar.
Abra um conceito e inspecione o resumo, as descrições, a hierarquia, os relacionamentos, os descendentes e o JSON bruto.
Execute uma expansão no estilo ECL, como a expressão
<< 84114007.Verifique se os cartões de resultados mostram o termo correspondente, o termo preferencial, a tag semântica, o status ativo e a proveniência da pesquisa.
Validar nota clínica básica
Execute as seguintes operações para validar seu fluxo de trabalho de nota clínica básica:
Carregue uma nota clínica simples e um exemplo mais rico de resumo de alta.
Verifique a extração de span e a detecção de contexto para menções presentes, negadas, histórico familiar, históricas, planejadas e incertas.
Verifique se o sistema não codifica excessivamente os sintomas genéricos para descendentes excessivamente específicos.
Confirme apenas as codificações revisadas e salve-as na coleção
grounded_notes.Execute uma query do MongoDB em
ancestorIdspara comprovar a capacidade de pesquisa operacional.
Principais Aprendizados
Operacionalize o SNOMED CT no MongoDB Atlas: sirva terminologia clínica em formato de grafo por meio de um modelo operacional centrado em documentos que oferece suporte a pesquisa, hierarquia, relacionamento e fluxos de trabalho de aplicativos.
Unifique a navegação de terminologia e a pesquisa semântica: Use o MongoDB Search e o MongoDB Pesquisa Vetorial para ajudar os usuários a encontrar, inspecionar e definir o escopo dos conceitos do SNOMED CT no mesmo serviço com suporte do Atlas.
Fundamente o texto clínico com evidências revisadas: Use o serviço de terminologia para propor candidatos SNOMED CT de notas clínicas e, em seguida, armazene codificações revisadas com evidências, contexto e caminhos ancestrais.
Autores
Francesc Mateu Amengual, MongoDB
Giovanni Rodríguez, MongoDB
Diego Canales, MongoDB
Saiba mais
Visão geral do MongoDB Search: aprenda como o MongoDB oferece suporte a pesquisa de texto completo, preenchimento automático, filtro, pontuação e experiências de aplicativo orientadas a pesquisa.
Visão geral da pesquisa vetorial do MongoDB: saiba como o MongoDB oferece suporte à recuperação semântica e à pesquisa vetorial no Atlas.
Obtenha o SNOMED CM: revise como as organizações acessam o SNOMED CM e entenda o caminho do licenciamento para seu país ou território.
Conceitos, descrições e relacionamentos do SNOMED TOC: Aprenda os blocos de construção básicos do SNOMED TOC que esta solução mapeia para documentos do MongoDB .