보험 분야의 인수, 청구 및 서비스 결정은 일반적으로 정책 관리 시스템, 청구 플랫폼, 텔레매틱스, 타사 위험 데이터 등 여러 시스템에 분산된 컨텍스트에 따라 달라집니다. 매번 수동으로 해당 컨텍스트를 조합하는 것은 느리고 일관성이 없으며 감사하기 어렵습니다.
이 아키텍처는 MongoDB Atlas의 컨텍스트 계층을 설명합니다. 이는 비즈니스 객체 컨텍스트를 에이전트와 애플리케이션이 읽고, 쓰기 (write)하고, 조치를 취할 수 있는 단일 라이브 객체로 조합하는 실시간 운영 데이터 계층입니다.
컨텍스트 계층은 기존 기록 시스템과 AI 기반 언더라이팅, 청구 및 서비스 워크플로 사이에 위치하므로 보험사는 에이전트가 사용할 수 있도록 해당 시스템을 교체할 필요가 없습니다. 이 계층은 유연한 document model, AI 네이티브 검색, 실시간 변경 전파 및 필드 수준 거버넌스를 결합하여 규제 대상인 에이전트 증강 의사 결정 루프가 요구하는 낮은 지연 시간 및 감사 가능성 요구 사항을 충족합니다.
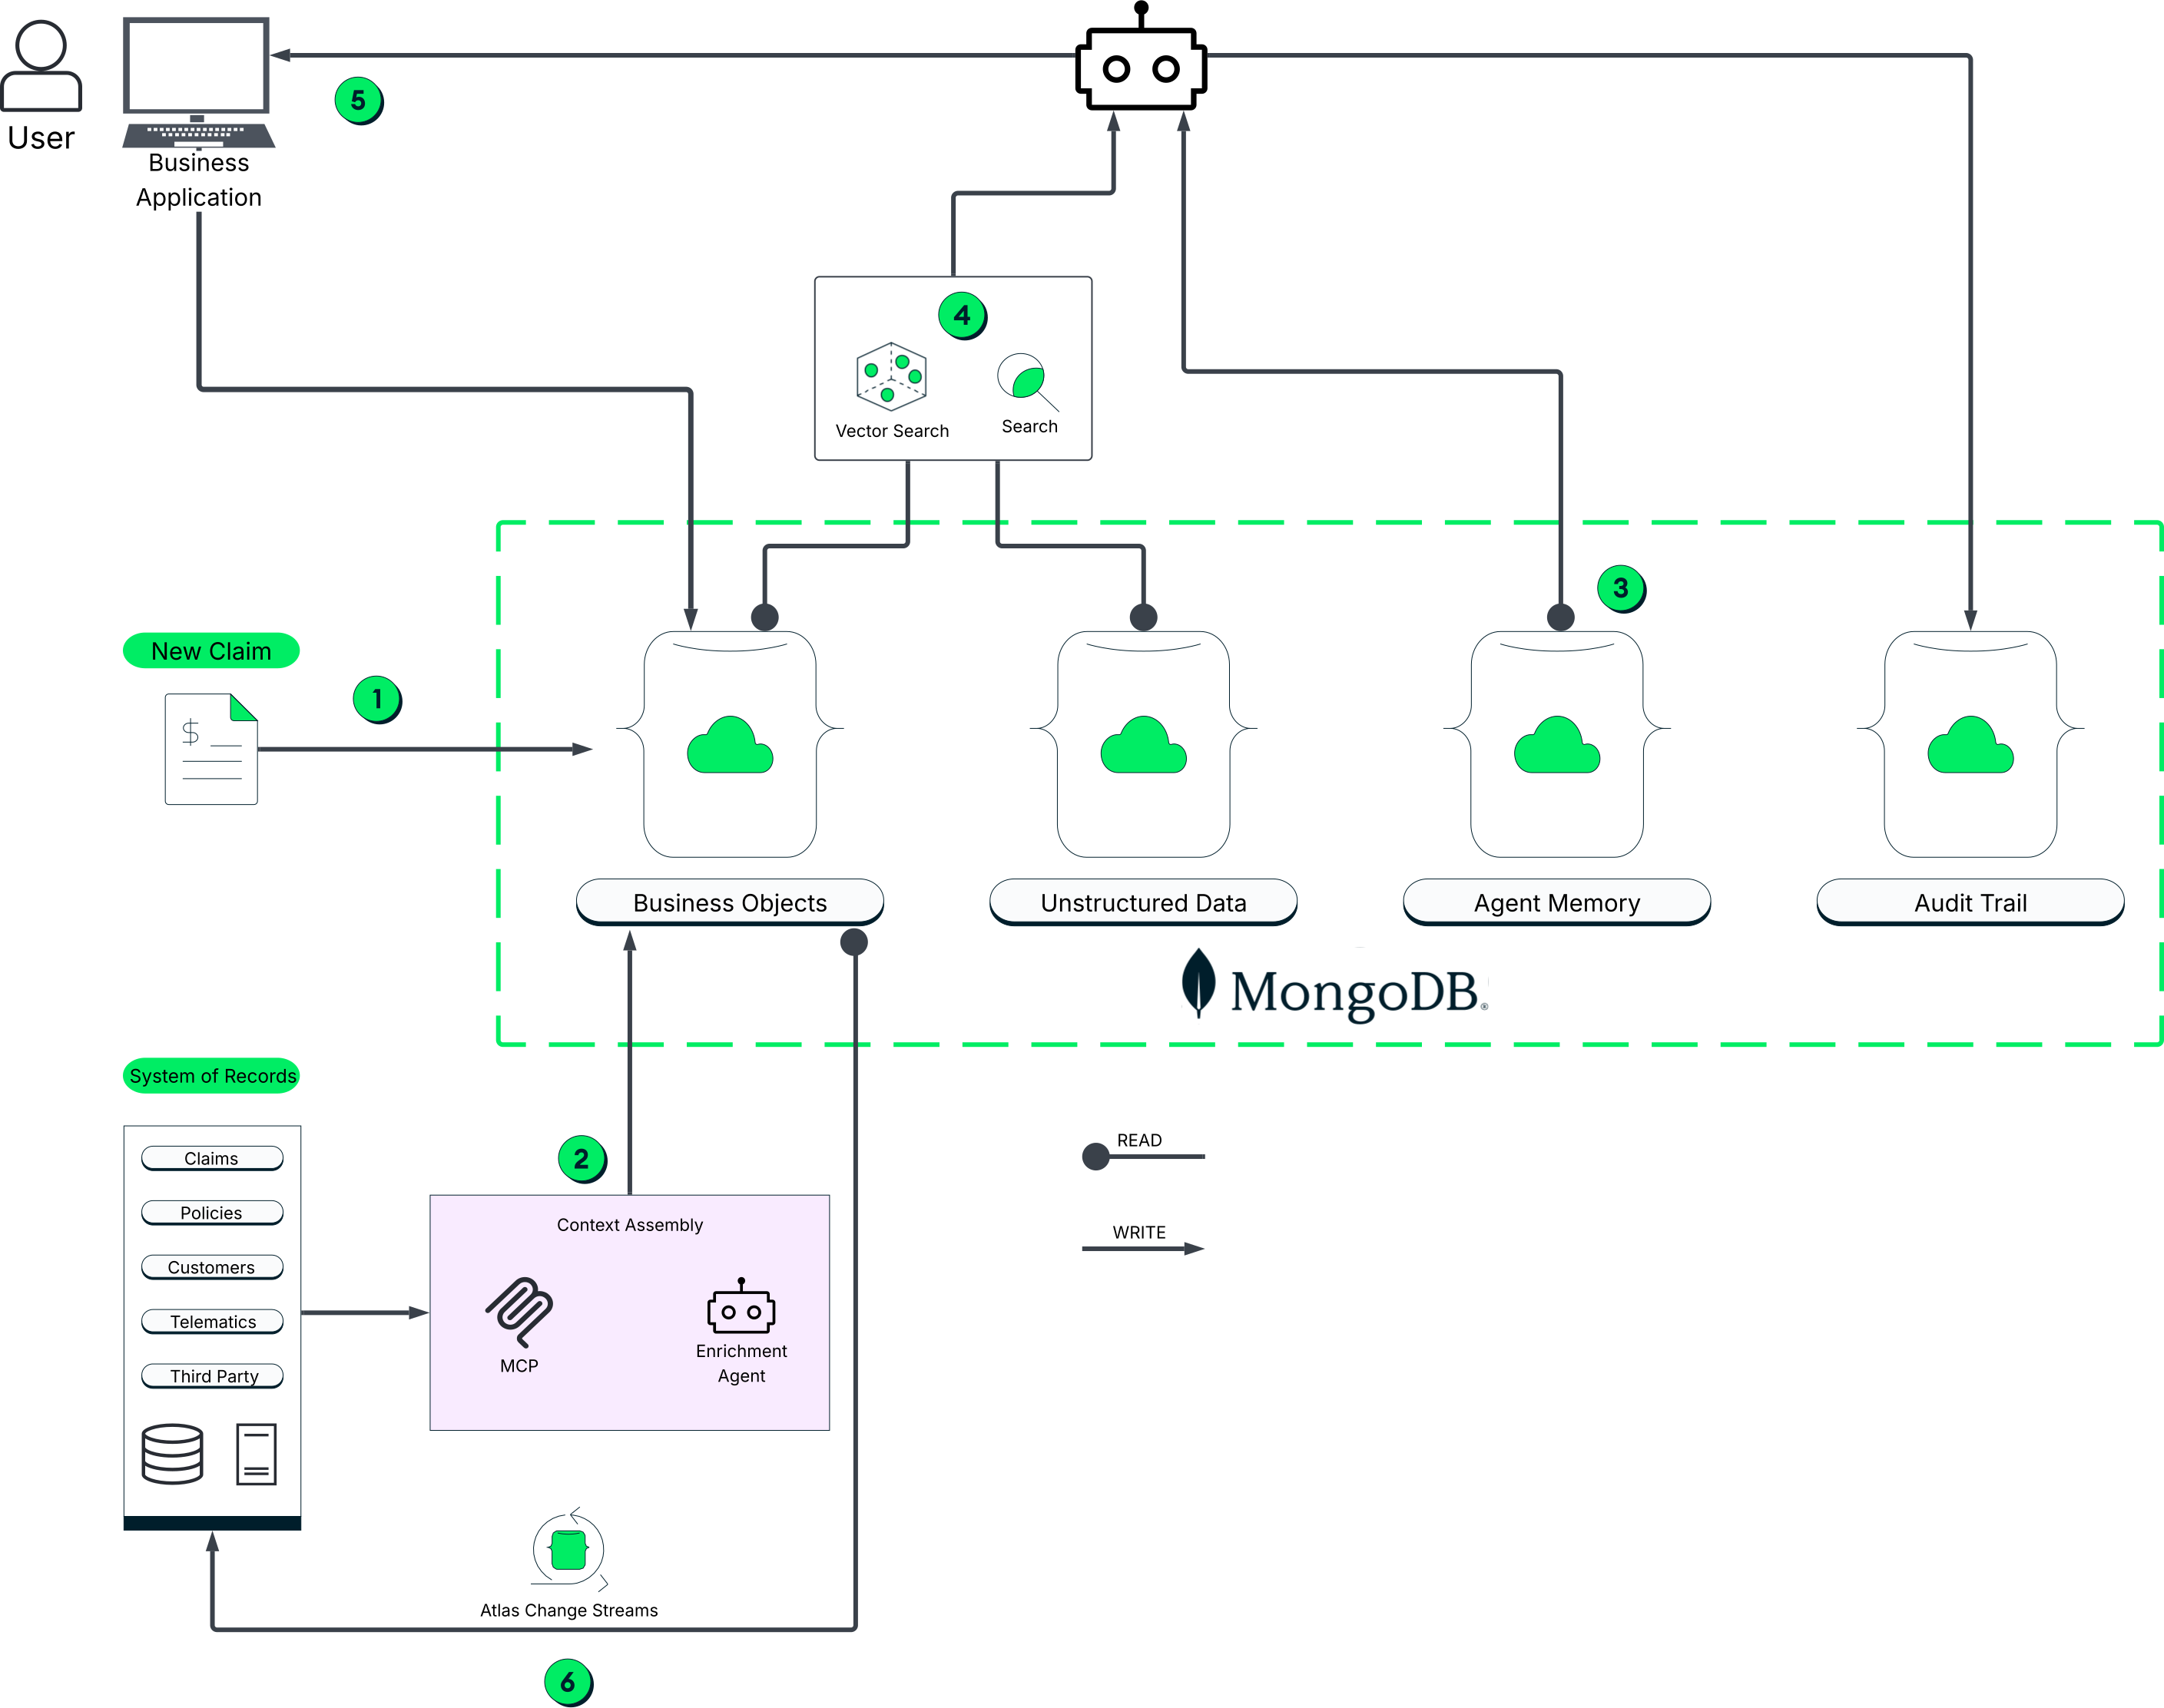
그림 1. 컨텍스트 계층 아키텍처 및 AI 에이전트 데이터 플로우
데이터 흐름
다음 단계는 단일 제출 또는 청구가 컨텍스트 계층을 통해 접수부터 기록되고 감사 가능한 결정에 이르기까지 이동하는 과정을 추적합니다.
제출 또는 청구 접수
새로운 제출이나 청구가 들어오면 인테이크 서비스가 핵심 식별자와 초기 구조화된 필드를 캡처합니다. 해당 정보가 식별되면 인테이크 서비스는 이를 MongoDB Atlas의
business_objects컬렉션에 단일 문서로 쓰기 (write).컨텍스트 강화 및 어셈블리
특수 강화 에이전트는 커버리지 한도, 보증, 손실 설명, 조정자 메모 등 언더라이터나 클레임 담당자가 필요로 하는 나머지 컨텍스트를 수집합니다. 에이전트는 기록 시스템에서 데이터를 수집하여 단일 라이브 기록을 생성합니다. 이제 단일 MongoDB 문서에 언더라이터나 클레임 에이전트가 지식을 수집하고, 결정을 내리고, 조치를 취하는 데 필요한 모든 것이 담겨 있습니다.
에이전트 메모리 및 상태 검색
컨텍스트 강화와 동시에, 이 서비스는 에이전트 메모리에 이 특정 사례에 대한 대화 기록, 의사 결정 추적, 감사 기록 및 감정이 포함되어 있으므로 이 제출 또는 청구에 대한 이전 메모리도 조회합니다. 이를 통해 언더라이팅 또는 청구 에이전트는 이전 차례, 권장 사항 및 사람의 재정의에 대한 완전한 메모리를 가지고 작업을 재개할 수 있습니다.
정형 및 비정형 콘텐츠에 대한 AI 네이티브 검색
이 서비스는 비즈니스 객체와 조정자 메모, 손실 내러티브 또는 이미지 메타데이터와 같은 연결된 비정형 아티팩트에 대해 하이브리드
$vectorSearch및$search쿼리를 실행합니다. 이를 위해 도메인에 맞게 조정된 임베딩과 리랭킹을 사용하여 에이전트가 원시 일치 항목 목록 대신 가장 관련성이 높은 기록과 선례를 먼저 볼 수 있도록 할 수 있습니다.에이전트 결정, Human-In-The-Loop 및 쓰기 (write)-back
에이전트는 조립된 컨텍스트를 검토하고, 견적서 발급이나 추가 정보 요청 같은 조치를 취합니다. 많은 상황에서 이 조치는 사람의 검토과정이 필요하며, 최종 수정은 항상 사람이 제어합니다. 마지막으로 에이전트는 전체 추론 추적과 함께 결정을 MongoDB의 자체 결정 추적 컬렉션에 변경 불가능한 감사 항목으로 다시 기록하여 에이전트 조치에 대한 완전한 컴플라이언스, 추적 가능성 및 투명성을 보장합니다.
Change Streams를 이용한 실시간 전파
MongoDB Change Streams는 제출 또는 클레임을 모니터링하는 모든 에이전트, 대시보드 및 다운스트림 시스템에 업데이트를 브로드캐스팅합니다. 또한, 사용자가 언제든지 새로운 신호를 도입하여 에이전트를 직접 trigger할 수 있습니다. 예를 들어, 청구에 대한 새로운 사기 지표가 발생하면 배치 주기 없이 즉시 청구 에이전트를 실행할 수 있습니다.
구성 요소
기록 시스템
SSoR(Single System of 기록)이라고도 하는 SoR(System of 기록)은 중요한 데이터 요소 또는 데이터 객체에 대한 권한 있는 데이터 소스를 제공하는 단일 컴퓨터 시스템입니다. SoR은 데이터의 "참 상태"를 보유합니다. 즉, 해당 데이터 소스에 대해 사용 가능한 가장 최신의 정확하고 규정을 준수하는 버전입니다.
이 아키텍처에서 기록 시스템은 비즈니스 트랜잭션의 원천으로 유지됩니다. 이들은 원래의 책임을 계속 유지하는 동시에 컨텍스트 계층은 이들 전반에 걸쳐 사용 가능한 의사 결정 컨텍스트를 어셈블합니다.
비즈니스 객체 및 에이전트 메모리
비즈니스 객체는 제출, 청구 또는 고객 기록과 같은 운영 엔터티를 단일의 지속적으로 보강되는 문서로 보유합니다. 이를 통해 모든 소비자는 흩어진 소스에서 정보를 수집할 필요 없이 동일한 최신 뷰에서 작업할 수 있습니다. MongoDB는 이 기록과 함께 에이전트 메모리를 저장하므로 에이전트는 다단계 결정 전반에 걸쳐 컨텍스트와 감사 기록을 유지할 수 있습니다.
AI 네이티브 검색
MongoDB Vector Search를 전체 텍스트 검색 및 리랭킹과 결합하면 에이전트가 별도의 벡터 저장소를 오케스트레이션하는 대신 단일 쿼리로 구조화된 필드와 비정형 아티팩트 모두에서 가장 관련성이 높은 손실 기록, 선례 또는 지침을 조회할 수 있습니다.
실시간 전파
MongoDB Change Streams와 네이티브 Stream Processing은 모든 에이전트와 다운스트림 시스템을 제출 또는 청구의 현재 상태와 동기화된 상태로 유지하며, 폴링이나 배치 주기를 기다릴 필요 없이 새로운 신호나 이벤트가 에이전트를 직접 트리거할 수 있도록 합니다.
감사 추적
컨텍스트 계층은 모든 읽기(write) 및 쓰기(write)에 대한 변경 불가능한 감사 추적을 유지하므로 모든 AI 지원 결정이 항상 투명하고 추적 가능하게 유지됩니다. 하나의 컬렉션은 결정을 내린 사용자/에이전트의 신원부터 결론에 도달하기 위한 단계, 컨텍스트, AI 메타데이터, 결정 결과 등 각 결정에 대한 전체 정보를 수집합니다.
제한 사항
이 패턴은 복잡성을 초래하고 의도적으로 채택되어야 합니다.
운영 계층이 항상 분석 목적에 가장 적합한 것은 아닙니다: 이 아키텍처는 분석 전용 워크로드, 아카이브 리포지토리 또는 실시간 컨텍스트 어셈블리, 쓰기 (write) 또는 감사 가능성이 필요하지 않은 의사 결정이 포함된 사용 사례에는 적합하지 않습니다. 보고나 배치 중심의 분석이 프라이머리 목적이라면, 운영 컨텍스트 계층을 추가하지 않고도 분석 플랫폼만으로 충분할 수 있습니다.
스키마 유연성에는 그 자체의 규율이 필요합니다: 이러한 접근에는 데이터 모델링, 신원 해결, 거버넌스 및 라이프사이클 관리에서의 규율도 필요합니다. 컨텍스트 계층은 크고 복잡한 객체 및 진화하는 스키마를 축적할 수 있습니다. 따라서 팀은 객체 경계, 예상 및 업데이트 패턴을 초기에 정의해야 합니다.
업스트림 시스템의 복잡성이 제거되지는 않습니다: 의사 결정 시점의 파편화는 줄어들지만, 여전히 신뢰할 수 있는 업스트림 데이터 액세스와 데이터 품질에 의존합니다. 소스 품질이 낮거나 이벤트 설계가 미흡하면 컨텍스트 계층 내에서 문제가 드러나게 됩니다.
이 아키텍처는 사전 정의된 데이터 모델을 갖춘 특정 사용 사례에 맞게 조정되고 검증된 참조 워크플로우에서 확장될 때 가장 효과적입니다.
자세히 알아보기
다른 참조 아키텍처를 살펴보세요: