ユースケース: シングル ビュー
業種: 金融サービス
製品: MongoDB Atlas
ソリューション概要
金融機関はネットワーク内で暗黙的に動作します。マネーラッパー、不正組織、ペインの状況は、shell会社、プロキシ役員、階層化トランザクション パスのウェブに依存しています。コンプライアンス チームは、疑似エンティティの周囲の関係関係をマッピングして分析する必要があります。
従来のアプローチは 2 つのボトルネックになります。
コストのかかるクエリ: 関係データベースは再帰的な共通テーブル式(CTES)を使用します。これらのクエリは 2 つまたは 3 つを超えるとコストがかかります。
継続的なネットワーク ラウンドトリップ: クライアント側 のグラフ プロセシング はデータをアプリケーションレイヤーにプルします。クライアントは、ドロップごとに新しいクエリを実行します。
このソリューションでは、次の操作を行います。
MongoDB演算子を使用するネットワーク分析エンジンをビルドして、これらのボトルネックを回避します。
MongoDB の集計フレームワーク内で、マルチホストグラフトラバーサル、最短パス検出、中央性スコアリング、コミュニティ検出、リスク伝達を直接実行します。
このソリューションは、ネットワーク分析エンジンと、それを強化するMongoDB演算子に焦点を当てています。MongoDB Atlas、FastAPI、Next.js を使用して全体的なアーキテクチャを実装するには、前の Solutions Library の金融攻撃の軽減に従ってください。
専用の Graph Database ではなくMongoDB を使用する理由
検索インデックス、vector embeddings、変更ストリームとともにMongoDBにエンティティと関係を保存します。
グラフワークロードはMongoDBで保持されているため、2 つのシステム間でのデータ同期、余計なインフラストラクチャの管理、クロスシステム間レイテンシの発生を避けます。
MongoDB の
$graphLookup演算子を使用して、各ステップで標準的なインデックス作成クエリを使用して幅最初の検索を実行するため、パフォーマンスは別のグラフエンジンではなく、インデックスによって異なります。コンプライアンス調査で一般的な 1 から 5 のトラバーサルでは、アプリケーションがすでに読み取りと書込みを行っている同じデータをクエリしながら、専用のグラフデータベースに一致させます。
注意
コンプライアンス調査では、通常、対象からいくつかのステップをトレースします。即座のカウンターパーティと最初の層の中間者は、1-2 のドロップダウンを行いますが、 シェル構造とマネージド パスは通常 3-5 ホスティング内に収まります。そのため、リンクは意味を持ち、説明するのが困難になるため、ほとんどの実用的な調査はこの 1~5 の範囲に収まります。
参照アーキテクチャ
ネットワーク分析エンジンは、FastAPI サービスレイヤーとMongoDB Atlasの間にあり、集計パイプラインを通じてグラフ操作を処理します。
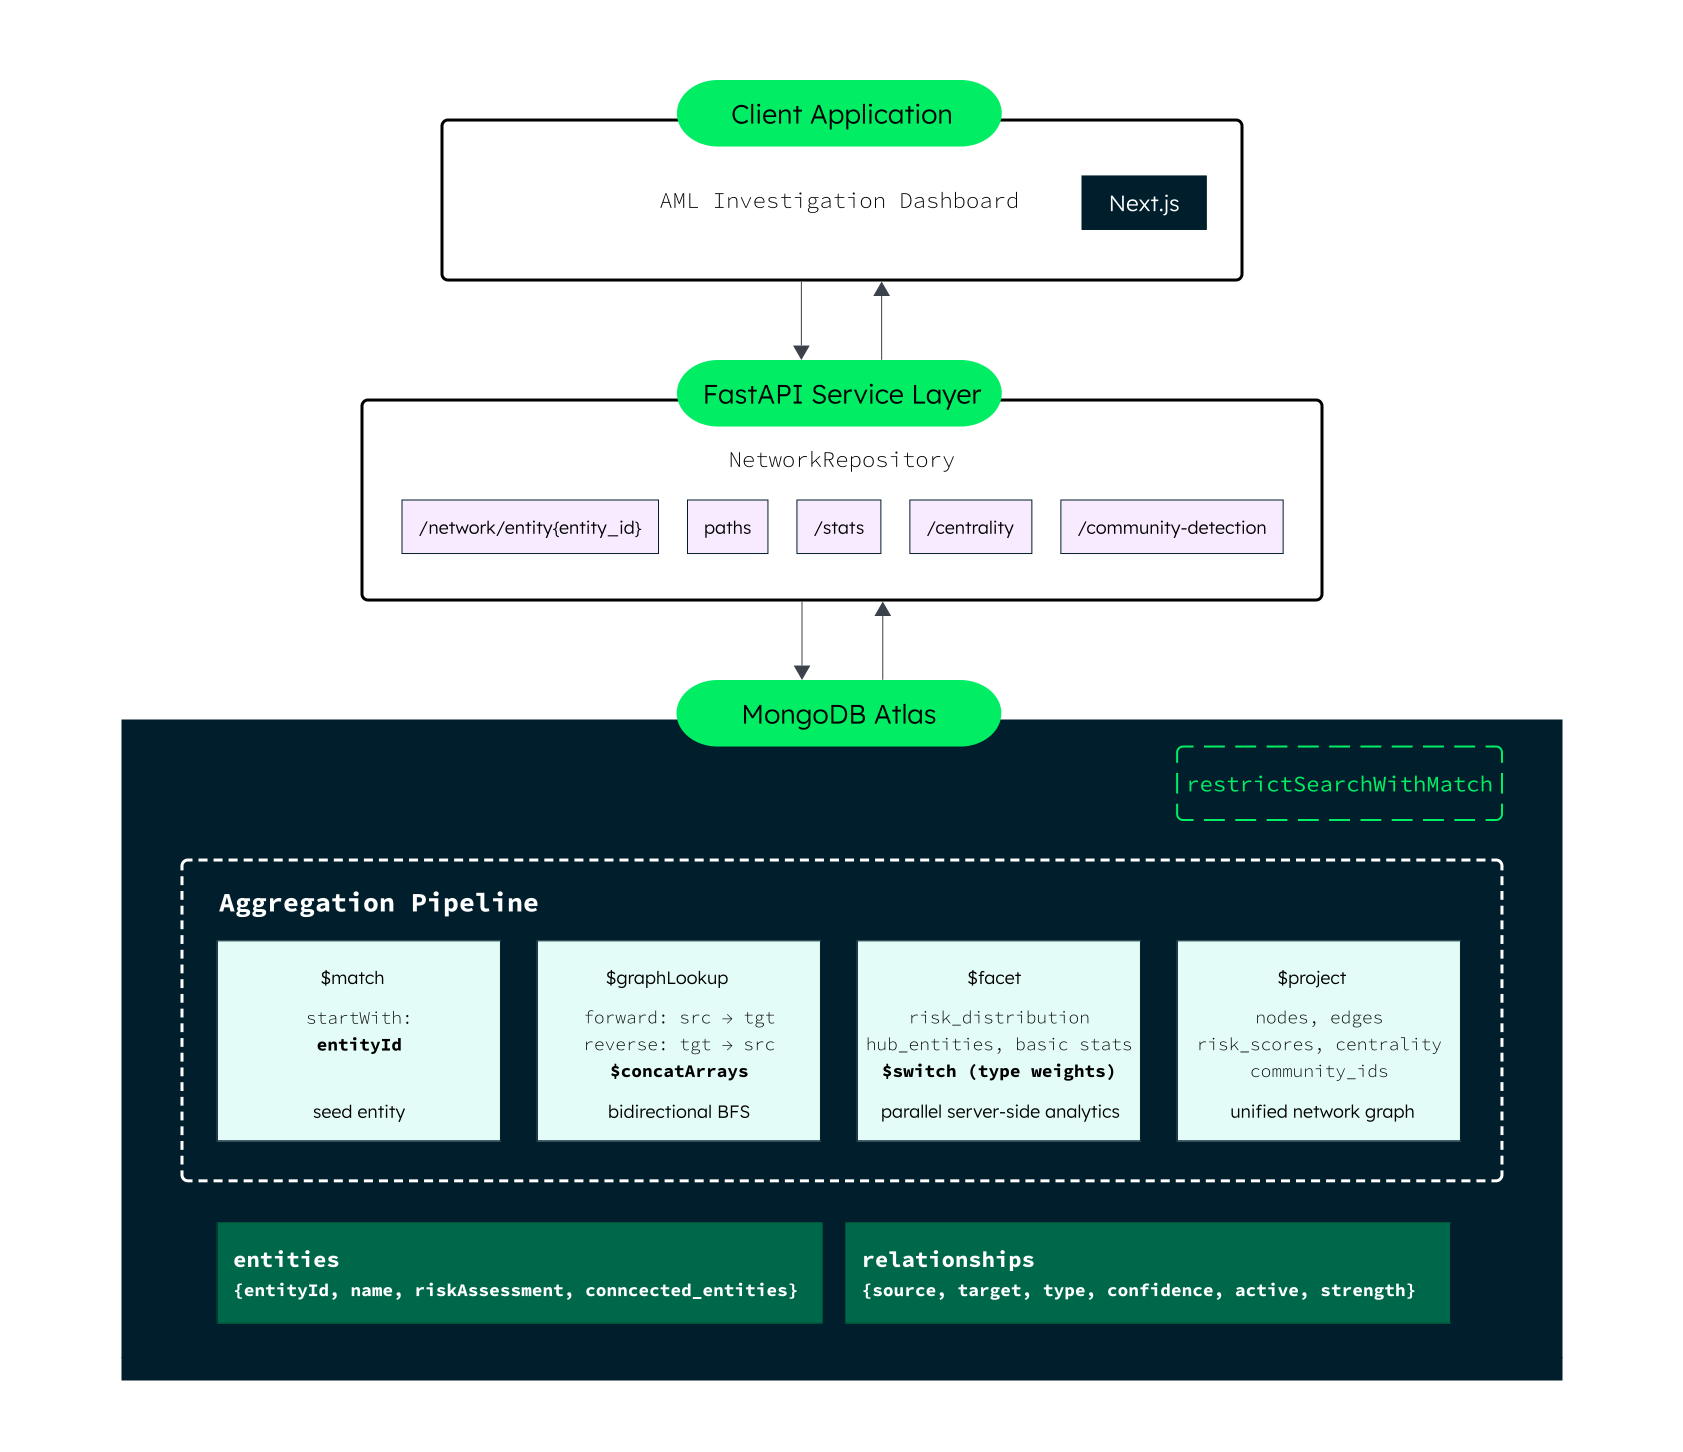
図の 1。エージェント的調査パイプライン
二重 $graphLookup パターン
マネーランディング ネットワークには双方向型フローが含まれます。エンティティは、ある関係で関数をソースし、別の関係で受け取ることができます。
単一の $graphLookup はエッジを一方向のみ走査します。このソリューションは、順方向と逆方向の 2 つの並列検索を実行し、その結果を統合ネットワークグラフにマージします。
pipeline = [    {"$match": {"entityId": center_entity_id}},
    # Forward traversal: follow source → target edges    {"$graphLookup": {        "from": "relationships",        "startWith": "$entityId",        "connectFromField": "target.entityId",        "connectToField": "source.entityId",        "as": "forward_relationships",        "maxDepth": max_depth - 1,        "restrictSearchWithMatch": {            "active": True,            "confidence": {"$gte": min_confidence}        }    }},
    # Reverse traversal: follow target → source edges    {"$graphLookup": {        "from": "relationships",        "startWith": "$entityId",        "connectFromField": "source.entityId",        "connectToField": "target.entityId",        "as": "reverse_relationships",        "maxDepth": max_depth - 1,        "restrictSearchWithMatch": {            "active": True,            "confidence": {"$gte": min_confidence}        }    }},
    # Merge both directions    {"$project": {        "entityId": 1,        "all_relationships": {            "$concatArrays": [                "$forward_relationships",                "$reverse_relationships"            ]        }    }},
    {"$unwind": "$all_relationships"},    {"$replaceRoot": {"newRoot": "$all_relationships"}},    {"$limit": max_relationships}]
図の 2。二重 $graphLookup — 双方向ネットワーク検出
アプリケーションは、1 回のラウンドトリップで完全なネットワークグラフを受け取ります。どちらのトラバーサルも 1 つの集計パイプラインで実行されるため、最初のクエリで返されたdocumentごとに個別の追跡クエリを発行するという N+1 クエリの問題が削除されます。
方法 $graphLookup グラフを走査する
$graphLookup は、分散最初の検索(NFS)を分散したドキュメントで実行します。
シード: input documentに対して
startWithを評価します。配列値はフトランザクションを同時にシードします(マルチルート BFS)。クエリ: 任意の
restrictSearchWithMatchフィルターと統合された{ connectToField: { $in: [frontier_values] }}を構築します。コレクションの に対して標準のインデックス付きクエリとして実行します。展開: 訪問セットに含まれない一致したdocumentごとに、それを結果に追加し、
connectFromField値を抽出し、次のグラフにプッシュします。繰り返し: 深度を増やします。フランクが空になるか、
maxDepthに達するまで、ステップ 2 に戻ります。アセット: すべてのdocumentを、フィールドとして の下の配列に配置します。
サイクル検出は自動です。内部訪問セットは、通貨グラフ(A → B → C → A)の無限ループを防止します。これは、マネーランディング構造で一般的です。各documentは結果に 1 回だけ表示されます。
この restrictSearchWithMatch 利点
restrictSearchWithMatch は、フィルター条件をポストフィルターとしてではなく、トラバーサル自体にプッシュします。MongoDB は、完全なグラフを検出してその後フィルタリングするのではなく、走査中にデッド ブランチをプルします。大規模なネットワークの場合、これによりワーキングセットを一意の規模で縮小できます。

図の 3。走査中のフィルター処理と後フィルター処理
データモデルアプローチ
このソリューションでは、entities と relationships の 2 つのコレクションを使用します。因果関係リストのパターンに従います。エッジメタデータ(構成、エビクション、検証ステータス)は、関係documentのファーストクラスのフィールドとして存在します。
関係スキーマ
{ "relationshipId": "REL_8910", "source": { "entityId": "ENT_123", "entityType": "individual" }, "target": { "entityId": "ENT_456", "entityType": "organization" }, "type": "beneficial_owner_of", "direction": "directed", "strength": 0.85, "confidence": 0.95, "active": true, "verified": true, "evidence": [ { "evidence_type": "corporate_registry", "confidence": 0.95, "source": "Companies House UK" } ], "datasource": "KYC_onboarding"}設計上の重要な決定
ネストされたソースとターゲット参照:
source.entityIdとtarget.entityId構造は、$graphLookupのconnectFromFieldパラメータとconnectToFieldパラメータに直接マップされます。また、結合を必要とせずにエンティティ型のメタデータをエッジ レベルで保持します。個別
strengthおよびconfidenceフィールド: 強度は、距離のあるビジネス関連付けに対して 90% の所有権を保持する UPO のように、関係が本質的にどの程度強力であるかをキャプチャします。コンフィギュレーションは、共有アドレスから推論されたものではなく、2 つの独立したソースによって検証されたデータ点の信頼性をキャプチャします。リスク複製では、両方の値が異なる方法で使用されます。activeソフト削除の場合はブール値: AML システムでは監査するトロールが必要です。document を削除するのではなく、active: falseを設定して関係を削除します。このフラグは、restrictSearchWithMatchの走査フィルターとしても機能します。
ソリューションのビルド
リポジトリをクローンし、GitHub README: の設定手順に従います。
git clone https://github.com/mongodb-industry-solutions/fsi-aml-fraud-detection.gitcd fsi-aml-fraud-detection/aml-backendpoetry installpoetry run uvicorn main:app --host 0.0.0.0 --port 8001 --reload次のサブセクションでは、NetworkRepository に実装された 6 つの主要なグラフ操作について説明します。
必要なインデックスの作成
$graphLookupは、すべての BFS バイトごとに{ connectToField: { $in: [frontier] } }クエリを発行します。両方のトラバース方向のインデックスconnectToField:
db.relationships.createIndex({ "source.entityId": 1, "active": 1, "confidence": -1});db.relationships.createIndex({ "target.entityId": 1, "active": 1, "confidence": -1});インデックスの利点は 1-3 で最も速く、深度が増加するにつれて減少します。AML 調査における 1 から 4 のトラバーサルは、スイート ドットの角に配置されます。
最短パスの検索 (depthField)
リスクの低いカスタマーが認可されたエンティティに接続しているかどうかを判断し、正確なチェーンを再構築します。
depthFieldを使用して、検出された各関係とそのドロップ距離に注釈を付けます。
pipeline = [ {"$match": {"entityId": source_entity_id}}, {"$graphLookup": { "from": "relationships", "startWith": "$entityId", "connectFromField": "source.entityId", "connectToField": "target.entityId", "as": "forward_paths", "maxDepth": max_depth - 1, "depthField": "depth" }}, {"$graphLookup": { "from": "relationships", "startWith": "$entityId", "connectFromField": "target.entityId", "connectToField": "source.entityId", "as": "reverse_paths", "maxDepth": max_depth - 1, "depthField": "depth" }}, {"$project": { "all_paths": {"$concatArrays": ["$forward_paths", "$reverse_paths"]} }}, {"$unwind": "$all_paths"}, {"$match": {"$or": [ {"all_paths.source.entityId": target_entity_id}, {"all_paths.target.entityId": target_entity_id} ]}}, {"$sort": {"all_paths.depth": 1}}, {"$limit": 1}]結果は最小の深度を示します。その深度で境界のある 2 つ目の $graphLookup は、完全な関係チェーンを再構築します。
Customer A → [beneficial_owner_of] → Shell Corp B → [director_of] → Sanctioned Entity Cネットワーク統計を計算 ($facet)
$facetを使用して、リスク分散、エンティティタイプの内訳、ハブ検出、プロファイリング、スコアリング、基本メトリクスなど、同じエンティティパイプラインに対して 5 つの並列分析を実行します。
stats_pipeline = [ {"$match": {"entityId": {"$in": network_entity_ids}}}, {"$addFields": { "connection_count": {"$size": {"$ifNull": ["$connected_entities", []]}} }}, {"$facet": { "basic_stats": [{"$group": { "_id": None, "total_nodes": {"$sum": 1}, "avg_risk_score": {"$avg": "$riskAssessment.overall.score"}, "max_risk_score": {"$max": "$riskAssessment.overall.score"} }}], "risk_distribution": [ {"$group": {"_id": "$riskAssessment.overall.level", "count": {"$sum": 1}}}, {"$sort": {"_id": 1}} ], "hub_entities": [ {"$match": {"connection_count": {"$gte": 2}}}, {"$sort": {"connection_count": -1}}, {"$limit": 5}, {"$project": {"entityId": 1, "name": 1, "connection_count": 1}} ] }}]$facet がない場合、各分析には個別のパイプラインが必要です。$facet はすべてのサブパイプラインを並列に処理し、単一の応答で結果を返します。これは 2–5 ミリ秒で実行されます。
スコア中心性(ドメイン固有の重み付けのための$switch)
最も不正なアクターを接続するエンティティを特定します。
中央性パイプラインは
$facetを使用して送信接続と受信接続を個別に集計し、マージとスコアを付けます。$switch演算子は、集計内の各関係タイプにリスク重みを直接割り当てます。
"outgoing_risk_weighted": { "$sum": {"$multiply": [ "$confidence", {"$switch": { "branches": [ {"case": {"$in": ["$type", [ "confirmed_same_entity", "business_associate_suspected" ]]}, "then": 0.9}, {"case": {"$in": ["$type", [ "director_of", "ubo_of", "parent_of_subsidiary" ]]}, "then": 0.7}, {"case": {"$in": ["$type", [ "household_member", "professional_colleague_public" ]]}, "then": 0.3} ], "default": 0.5 }} ]}}confirmed_same_entity接続は、household_memberリンクよりもリスクのある中央値にはるかに多くの影響を与えます。最終複合スコアは、正規化された度依存関係(40%)、平均信頼重み(30%)、リスク負荷重みのある中央値(30%)を組み合わせたものであり、すべてサーバー側で計算されます。
コミュニティの検出とリスクの伝達
- コミュニティ検出は集計によって因果マップを構築し、
confidence >= 0.7でフィルタリングして、高信頼関係の関係のみを囲むコミュニティ境界を構築します。
adjacency_pipeline = [ {"$match": { "$or": [ {"source.entityId": {"$in": entity_ids}}, {"target.entityId": {"$in": entity_ids}} ], "active": True, "confidence": {"$gte": 0.7} }}, {"$group": { "_id": "$source.entityId", "connections": {"$addToSet": "$target.entityId"} }}]$addToSetは接続を自動的に排除します。shared_addressとbusiness_associateの両方の関係を共有する 2 つのエンティティは、単一の接続として表示されます。
リスク伝達は、$graphLookup がネットワークを検出すると、関係チェーンを通じて指数関数的な減少を適用します。
propagated_risk = ( parent_entity_risk * propagation_factor # decay per hop (default: 0.5) * relationship_confidence # trust level for this edge * type_risk_weight # domain-specific weight)認可されたエンティティの shell 会社(高コンフィギュレーション、高リスクの関係タイプ)は、ほぼ完全なリスク スコアを受け取ります。メディアはほとんど何も受信されません。トラバーサルは幅最初で、深度は 3 に制限され、伝播されたスコアが設定可能なしきい値を下回ると停止します。
キーポイント
二重に使用する
$graphLookup双方向ネットワーク検出の場合は、順方向と逆方向の 2 つの並列検索を実行し、その結果を$concatArraysとマージして、1 回の集計で完全なネットワークを取得します。でトラバースにフィルターをプッシュします
restrictSearchWithMatch: 大規模なネットワークのワーキングセットを削減するために、その後に完全なグラフをフィルターする代わりに、 BFS 中にデッド ブランチをプルします。で複合インデックスを作成
connectToFieldとトラバーサル フィルター:$graphLookupは BFS 遅延ごとに$match/$inクエリを発行するため、connectToFieldをactiveとconfidenceとともにインデックス化すると、各ホストでコレクションスキャンが防止されます。でネットワーク分析サーバーサイドを計算します
$facetおよび$switch: リスク分散、ハブ検出、中央性スコアリングを並行してサブ 3 パイプラインで実行し、$switchを使用して集計内の関係タイプにドメイン固有のリスク重みを割り当てます。リスク伝達に指数関数的な減少を適用します。
$graphLookupベースのネットワーク検出と、関係性とタイプを含む 1 ドロップあたりの減少式とを組み合わせて、modelは高リスクの構造接続と低リスクのソーシャル リンクを自動的に区別します。これは、キー学習をコンシステントな命令形式で保つためのガイドラインに一致します。
作成者
Luis Pazmiño
メトリクスを再構築する
Andrea Alaman Calderon