Le applicazioni moderne devono rimanere disponibili anche quando il traffico aumenta improvvisamente o le query consumano risorse sproporzionate. MongoDB Atlas è progettato per l'alta disponibilità, ma nella pratica la disponibilità riguarda qualcosa di più della semplice sopravvivenza ai guasti degli host o a un'elezione di un replica set. Riguarda anche il modo in cui un cluster si comporta quando la domanda supera ciò che può elaborare in sicurezza.
La scorsa settimana, abbiamo annunciato Intelligent Workload Management (IWM) come GA in MongoDB 9.0. IWM è una funzionalità di disponibilità managed che mantiene i cluster Atlas reattivi e prevedibili anche in condizioni di sovraccarico. IWM accoda i picchi temporanei, mantiene fluide le operazioni a esecuzione breve e stabili quelle a lunga durata e protegge lo stato del cluster senza richiedere modifiche delle applicazioni.
Gli eventi di sovraccarico spesso si verificano più rapidamente di quanto l'infrastruttura possa scalare. Anche con la scalabilità automatica abilitata, il provisioning di capacità aggiuntiva richiede tempo. Nel gap tra un picco di traffico e la disponibilità di una nuova capacità, un cluster può diventare instabile se ogni richiesta viene trattata allo stesso modo e i client effettuano tentativi aggressivi. IWM è progettato per colmare The Gap preservando l'integrità del cluster, ottimizzando le prestazioni e trasformando quella che sarebbe un'interruzione imprevedibile in un evento controllato e osservabile.
In Coinbase, il volume di trading può subire picchi nel giro di pochi minuti e i nostri sistemi devono scalare in tempo reale, o i clienti se ne accorgono. Intelligent Workload Management ci dà la certezza che i nostri cluster rimarranno reattivi durante le finestre di trading di picco.
”In caso di sovraccarico prolungato, i clienti possono facoltativamente abilitare il Load Shedding per rifiutare le operazioni in eccesso. IWM consente di managed la pressione mentre un picco passa o la capacità viene aggiunta; non aggiunge capacità né sostituisce la scalabilità automatica e la pianificazione della capacità.
Figura 1. La gestione intelligente del carico di lavoro (Intelligent Workload Management) si adatta per mantenere i cluster reattivi e prevedibili.
Gestione della pressione del carico di lavoro mentre la capacità si adegua
I picchi di traffico e le operazioni che richiedono molte risorse possono aumentare la domanda più velocemente di quanto l'infrastruttura possa scalare. Anche quando la scalabilità automatica è abilitata, il provisioning di capacità aggiuntiva richiede tempo. I tentativi aggressivi dei client possono aumentare la pressione mentre un cluster è già occupato.
IWM aiuta a managed la pressione del carico di lavoro durante tale periodo. Funziona con o senza scalabilità automatica: quando la scalabilità automatica è abilitata, IWM aiuta a mantenere stabile il cluster mentre la capacità viene resa disponibile; senza di essa, IWM managed il lavoro alla capacità fornita dal cluster. Per una domanda sostenuta o in crescita, potrebbe essere ancora necessario aggiungere capacità.
In che modo l'IWM risponde alla pressione del carico di lavoro
Quando un cluster è sano, IWM è effettivamente invisibile. Quando la domanda supera ciò che il cluster può elaborare in modo sicuro, IWM managed la pressione in fasi:
- Limita il lavoro in entrata e accoda le richieste in eccesso: per impostazione predefinita, IWM accoda le richieste in eccesso invece di rifiutarle in modo proattivo. Ciò può aiutare ad assorbire i picchi transitori, sebbene le richieste accodate potrebbero richiedere più tempo per essere completate mentre le risorse sono limitate. L'accodamento modifica quando viene gestito il lavoro, non la quantità di lavoro che l'applicazione richiede infine al cluster di eseguire.
- Contribuisce a mantenere operative le transazioni di breve durata: Un'operazione di breve durata, come una tipica lettura o scrittura, e un'operazione di lunga durata, come una grande query di reportistica, non pongono le stesse richieste a un cluster. Quando le risorse sono limitate, IWM mantiene le operazioni a breve termine in movimento mentre gestisce quelle a lungo termine in modo più conservativo.
- Aiuta a gestire la pressione delle risorse: Frammentazione della memoria, squilibrio della cache ed esaurimento dello storage possono destabilizzare un cluster sano. L'IWM regola la gestione della memoria e della cache del cluster quando rileva pattern non salutari e può mettere in pausa le nuove scritture pur consentendo letture quando l'utilizzo dello storage raggiunge livelli critici.
Queste protezioni aiutano a preservare l'integrità del cluster durante il sovraccarico. Non rendono la capacità illimitata né sostituiscono un'efficace indicizzazione, una pianificazione della capacità o la scalabilità automatica.
Protezioni predefinite e Load Shedding opzionale
Le protezioni predefinite di IWM sono abilitate senza costi aggiuntivi sui cluster Atlas dedicati idonei che eseguono MongoDB 9.0. Non richiedono modifiche all'applicazione o aggiornamenti dei driver. Per impostazione predefinita, IWM managed il sovraccarico senza rifiutare attivamente il lavoro in eccesso.
Lo shedding del carico è un controllo separato e opzionale per il sovraccarico prolungato. Se abilitato, può rifiutare le operazioni in eccesso e tali rifiuti sono visibili all'applicazione come errori di sovraccarico. Il caricamento dei dati è disponibile senza costi aggiuntivi per i cluster Atlas replica-set dedicati M30+ idonei che eseguono MongoDB 9.0.
Le protezioni IWM predefinite funzionano con qualsiasi driver MongoDB. Se si abilita lo shedding del carico, utilizzare un driver con riconoscimento della contropressione supportato in modo che l'applicazione possa interpretare i segnali di sovraccarico e applicare tentativi limitati con backoff. Controllare la matrice dei driver supportati prima di abilitare il caricamento del carico.
Figura 2. La differenza tra l'impostazione predefinita (accodamento) e il Load Shedding.
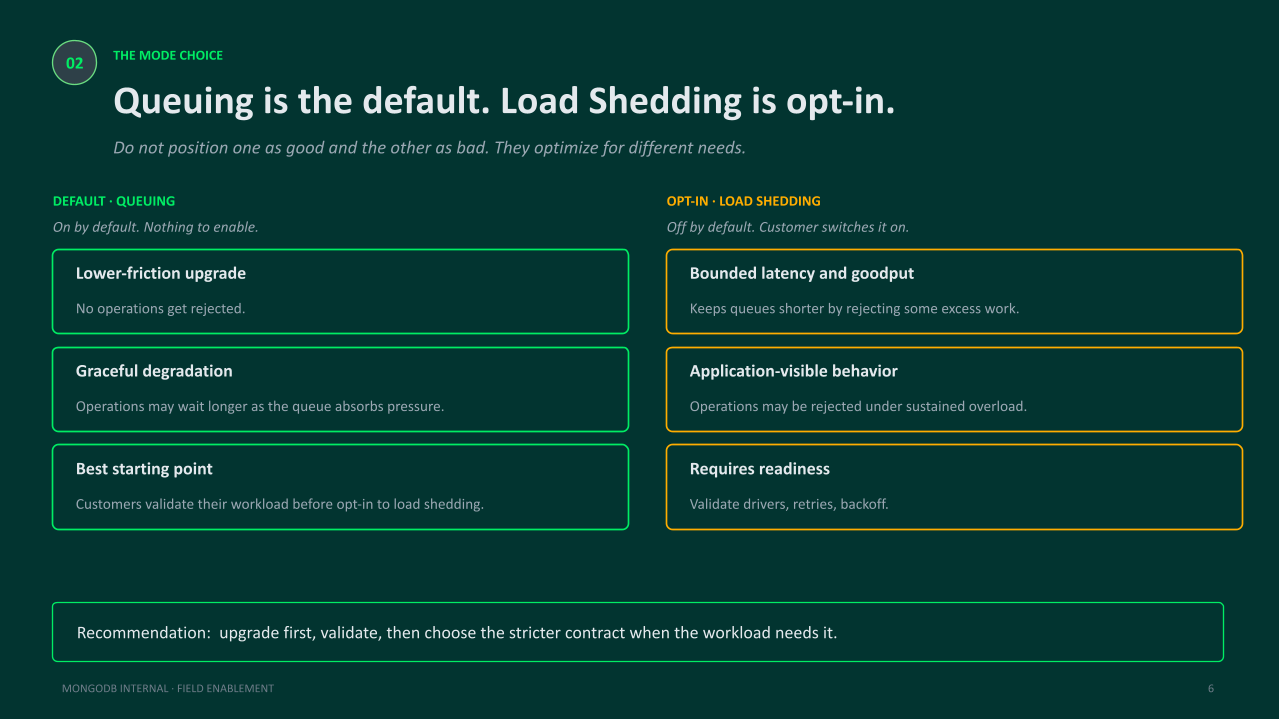
Comprendere gli interventi IWM con l'osservabilità
In Atlas, esamina le metriche di limitazione della velocità delle operazioni e di limitazione della velocità di connessione per operazioni o connessioni in coda o rifiutate. Quando il Load Shedding è abilitato, le operazioni rifiutate appaiono in Limite di velocità delle operazioni. Configura o esamina la condizione di avviso IWM per tenere traccia dell'attività IWM pertinente e controlla il feed attività per gli eventi correlati a IWM. Insieme, queste superfici Atlas ti aiutano a valutare se la pressione continua e se rivedere i pattern del carico di lavoro o aggiungere capacità. Ulteriori informazioni sull'osservabilità di IWM in Atlas.
Per i team che stanno valutando il Load Shedding facoltativo, Atlas fornisce anche un test per convalidare la compatibilità dei driver, la gestione da parte dell'applicazione degli errori di sovraccarico e la visibilità operativa prima di fare affidamento sul controllo in produzione. Quando testato su cluster di prova o di sviluppo attivi, Atlas rifiuta casualmente una piccola percentuale di operazioni indipendentemente dal carico. I team possono seguire le operazioni rifiutate nel grafico delle metriche ed esaminare i risultati al termine del test. Poiché le applicazioni potrebbero incontrare errori di sovraccarico durante il test, i team dovrebbero utilizzare questi test solo per verificare il comportamento del client. I team non dovrebbero eseguire test su un cluster di produzione. Scopri come testare il Load Shedding.
Per dettagli sul comportamento di IWM e su come rispondere al sovraccarico, consultare la documentazione di IWM.
Introduzione
Verifica che il cluster sia un cluster Atlas dedicato idoneo con MongoDB 9.0.
Decidi se la scalabilità automatica debba aggiungere capacità durante il sovraccarico prolungato. IWM aiuta a gestire la pressione mentre la capacità aggiuntiva viene online; non sostituisce la scalabilità automatica o la pianificazione della capacità.
Se abilita il caricamento dei dati, controlli la matrice del driver supportata e confermi che l'applicazione utilizzi tentativi limitati con backoff.
Esamina i dashboard di osservabilità di Atlas per comprendere quando IWM interviene e quali carichi di lavoro ne sono interessati.
Next Steps
Sei pronto a rendere i tuoi cluster più prevedibili durante gli eventi di sovraccarico? Leggi la documentazione IWM, esplora la scalabilità automatica di Atlas o registrati a MongoDB Atlas per iniziare a creare oggi stesso.