Aprenda a modelar, buscar, navegar y fundamentar la terminología clínica SNOMED CT con MongoDB Atlas.
caso de uso: Interoperabilidad
Industrias: Salud
Productos: MongoDB Atlas, MongoDB Search, MongoDB Vector Search, Voyage AI
Descripción general de la solución
Las aplicaciones de atención médica deben comprender el significado clínico, no solo almacenar texto clínico. Un médico puede escribir «insuficiencia cardíaca», «insuficiencia cardíaca» o «insuficiencia cardíaca». Diferentes palabras pueden describir la misma idea clínica. La codificación clínica ofrece a las aplicaciones una forma estándar de representar ese significado con identificadores estables.
Los equipos de atención médica utilizan diferentes sistemas de codificación para diferentes propósitos. Algunos sistemas de codificación agrupan diagnósticos y encuentros para reportes, estadísticas, reembolso o análisis de la actividad hospitalaria. SNOMED CT se centra en el significado clínico dentro del registro de salud. Puede representar problemas, hallazgos, procedimientos, estructuras corporales, organismos, sustancias, productos y muchas otras ideas clínicas. SNOMED CT es compatible con aplicaciones para buscar, intercambiar, analizar o razonar sobre hechos clínicos registrados en un registro de salud electrónico.
SNOMED International describe SNOMED CT como una terminología clínica con conceptos que tienen significados únicos, definiciones formales y organización jerárquica.
SNOMED CT tiene una estructura similar a un grafo. Hay más de 500,000 conceptos clínicos, cada uno de los cuales puede tener varias descripciones legibles por humanos, incluidos sinónimos y traducciones. Puede tener conceptos principales, conceptos secundarios, antepasados y relaciones formales con otros conceptos. SNOMED CT representa el contenido de la terminología a través de conceptos, descripciones y relaciones de la siguiente manera:
Un concepto representa una idea clínica.
Una descripción vincula un término legible por humanos a ese concepto.
Una relación conecta un concepto con otro.
Esta estructura es potente, pero crea desafíos de implementación. Los equipos de aplicaciones necesitan una búsqueda rápida de términos, búsqueda multilingüe, navegación jerárquica, expansión descendente e inspección de relaciones. También necesitan usar la terminología de SNOMED dentro de flujos de trabajo como la revisión de notas clínicas, la creación de listas de problemas, el soporte de decisiones, el descubrimiento de cohortes y la búsqueda semántica. Las implementaciones tradicionales a menudo dividen estas necesidades en varios sistemas:
Una base de datos relacional para los archivos de terminología.
Un motor de búsqueda para la búsqueda de texto.
Una base de datos de grafo para el recorrido de jerarquías.
Una base de datos vectorial para búsqueda semántica.
Esta solución muestra cómo operacionalizar SNOMED CT en MongoDB Atlas de la siguiente manera:
Almacenar cada concepto SNOMED como un documento de MongoDB que mantenga juntos la identidad del concepto, las descripción, las relación, los padres, los hijos y las rutas de los antepasados.
Compila una proyección de búsqueda a nivel de término para MongoDB Search y MongoDB Vector Search.
Utilice arreglos de antepasados e índices multiclave para admitir consultas comunes de jerarquía y descendientes sin una base de datos de grafo separada.
Utilice el mismo servicio de terminología para basar las notas clínicas en los candidatos de SNOMED
Almacene las codificaciones de revisión con pruebas, contexto y rutas de antepasados.
Por ejemplo, un usuario puede buscar “insuficiencia cardíaca”, inspeccionar el concepto clínico seleccionado, ver sus conceptos principales y secundarios, revisar su relación formal y expandir conceptos específicos debajo de él. SNOMED CT, a menudo utiliza ECL para expresar este tipo de expansión descendente. ECL funciona como un languaje del query compacto para describir conjuntos de conceptos SNOMED CT. Por ejemplo, la expresión << Heart failure se refiere a “insuficiencia cardíaca y todos los conceptos por debajo de ella en la jerarquía.” En el diseño de esquema de MongoDB, este patrón se asigna naturalmente a un query sobre arreglos de ancestros precalculados. La referencia oficial de ECL de SNOMED define el operador << como “descendiente o sí mismo de”, que recupera un concepto y sus subtipos.
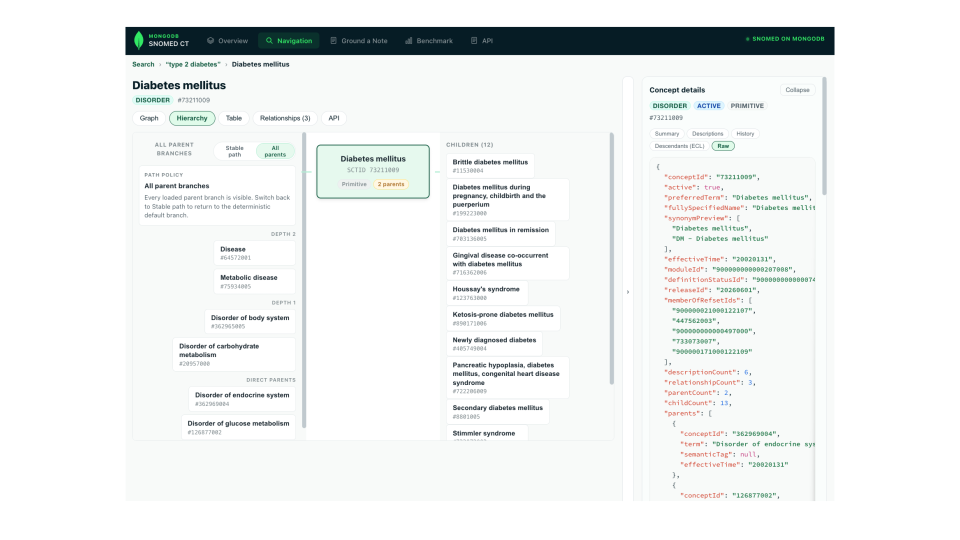
Figura 1. Concepto clínico con su jerarquía de padres e hijos
La solución también demuestra la fundamentación de notas clínicas. Una nota puede contener hallazgos actuales, antecedentes, antecedentes familiares, acción planificada, instrucción incierta y hallazgos negados. La aplicación extrae términos clínicos candidatos, busca SNOMED CT a través de MongoDB, propone conceptos candidatos y almacena codificaciones revisadas solo después de la confirmación. La codificación almacenada mantiene el intervalo de evidencia original, el concepto SNOMED seleccionado, el contexto de aserción, el estado del revisor y la ruta del antecesor. Las aplicaciones posteriores pueden entonces query por significado clínico, no solo por palabras exactas.
Utilice esta solución cuando necesite:
Busque términos clínicos, sinónimos, traducciones e identificadores SNOMED.
Navegue por las vistas de padre, hijo, antepasado, descendiente y relación.
Admite la búsqueda de terminología léxica, semántica e híbrida de una colección de MongoDB.
Amplíe los conjuntos de conceptos con expresiones de jerarquía de estilo ECL, como “todos los descendientes de la insuficiencia cardíaca”.
Notas clínicas básicas para candidatos de SNOMED CT con períodos de evidencia y revisión humana.
Almacene las codificaciones SNOMED revisadas con rutas ancestrales para queries posteriores indexadas.
Este patrón ofrece a los equipos de aplicaciones una plataforma operativa para datos de terminología, búsqueda de terminología, recuperación semántica, query de jerarquía, captura de evidencia clínica y resultados de codificación auditados. Reduce la necesidad de ejecutar sistemas separados para el almacenamiento de documentos, la búsqueda, la recuperación semántica y la navegación de estilo grafo.
Nota de licencia de SNOMED CT: El repositorio público asociado a esta solución incluye solo un pequeño conjunto de datos de muestra. SNOMED CT requiere una licencia adecuada.
Arquitecturas de Referencia
Esta arquitectura de referencia consta de un flujo de trabajo de navegación y nota clínica básica.
La navegación ayuda a un usuario de terminología a buscar, inspeccionar y definir el alcance de los conceptos de SNOMED CT. Ground Clinical Note reutiliza la misma capa de recuperación de terminología, mediante la búsqueda léxica determinista por defecto, para proponer candidatos de SNOMED CT a partir de texto clínico y almacenar solo codificaciones de revisión.
La arquitectura utiliza un conjunto de colecciones de MongoDB:
La colección
snomed-irbdalmacena la vista de terminología de origen único.El
snomed-term-searchadmite la búsqueda de terminología de alta calidad.La colección
grounded_notesalmacena la salida de la aplicación revisada, no los datos de terminología de origen.
El contenido de SNOMED CT tiene forma de grafo. Esta arquitectura mantiene las estructuras conectadas juntas en documentos de MongoDB y utiliza proyecciones de búsqueda y arreglos de antepasados para hacerlas operativas.
Arquitectura de un vistazo
Esta implementación parte de un paquete de contenido SNOMED CT autorizado, ya disponible como modelo conceptual JSON. En la demostración actual, el modelo fuente proviene de la distribución nacional española de SNOMED CT utilizada por el Ministerio de Sanidad. El repositorio público incluye únicamente un conjunto de datos de muestra; no redistribuye la terminología completa de SNOMED CT.
La arquitectura es independiente del formato de origen. Si una organización recibe SNOMED CT como JSON, puede cargar ese modelo directamente en MongoDB.

Figura 2. MongoDB como autoridad de código, con una puerta de enlace LLM opcional y con límites de candidatos.
El modelo de destino tiene las siguientes colecciones de terminología:
snomed-irbdalmacena cada concepto clínico con sus descripciones, relaciones, padres, hijos, antepasados, estado activo, metadatos de lanzamiento y metadatos de membresía. Las aplicaciones utilizan esta colección para la búsqueda de conceptos, la navegación jerárquica, la inspección de relaciones y la expansión de descendientes.snomed-term-search: Almacena un documento que se puede buscar por término, lenguaje y versión activos. Las aplicaciones utilizan esta proyección para búsqueda léxica, búsqueda semántica, búsqueda híbrida, filtro de lenguaje y filtro de alcance.
La API de navegación utiliza el snomed-term-search para encontrar conceptos coincidentes. A continuación, enriquece los resultados seleccionados de la colección snomed-irbd. Un usuario puede buscar una frase clínica como “insuficiencia cardíaca”, inspeccionar el concepto seleccionado, ver conceptos más amplios y más específicos, y abrir ejemplos de API para la misma operación.
La API de fundamentación reutiliza la capa de recuperación de terminología dentro de un flujo de trabajo de notas clínicas. La recuperación de fundamentación utiliza por defecto la búsqueda léxica determinista, mientras que la navegación ofrece modos léxicos, semánticos e híbridos. El nivel LLM opcional puede ayudar a interpretar texto y elegir entre los candidatos proporcionados por MongoDB, pero no debe crear nuevos identificadores SNOMED CT.
Después de la revisión, la aplicación almacena las codificaciones confirmadas en grounded_notes. Cada codificación mantiene el concepto SNOMED CT seleccionado, el texto de la evidencia, el contexto de la aserción, el contexto del sujeto, el estado del revisor y los ID de los antepasados. Las aplicaciones posteriores pueden query los hechos clínicos revisados por significado, no solo por palabras exactas.
Flujo de trabajo de navegación
Un usuario busca un término clínico como “insuficiencia cardíaca”. La aplicación query la proyección de búsqueda de términos y devuelve resultados a nivel de concepto agrupados por concepto SNOMED.
Cada resultado muestra:
El término que coincide con la query del usuario
La visualización preferida para el concepto
El nombre clínico formal
El identificador SNOMED
El estado activo
La categoría semántica
El lanzamiento
La procedencia de la búsqueda
El usuario puede abrir la vista de enfoque del concepto. Esta vista muestra el resumen del concepto, la descripción, los conceptos principales, los conceptos secundarios, la relación, los descendientes, el documento sin procesar y los ejemplos de API.
La navegación admite estos modos de búsqueda:
La búsqueda léxica utiliza MongoDB Search para términos exactos, sinónimos, nombres formales, identificadores, prefijos y texto difuso.
La búsqueda semántica utiliza MongoDB búsqueda vectorial, que incrusta automáticamente el campo
embedTextdel término con el modelo de referencia voyage-4. Como tal, la recuperación por significado se ejecuta en la misma colección sin necesidad de un almacén vectorial o pipeline de incrustación independiente.La búsqueda híbrida combina la recuperación léxica y vectorial. Si se configura un reranker de Voyage cross-encoder, la aplicación rerankea el grupo de candidatos fusionados; de lo contrario, recurre al orden de fusión.
La pantalla de búsqueda también admite el alcance semántico. Un usuario puede limitar los resultados a un área clínica amplia, como hallazgo clínico, procedimiento, estructura corporal o sustancia. Un usuario también puede usar una expresión descendente como << 404684003 para restringir los resultados a un concepto y sus conceptos más específicos.
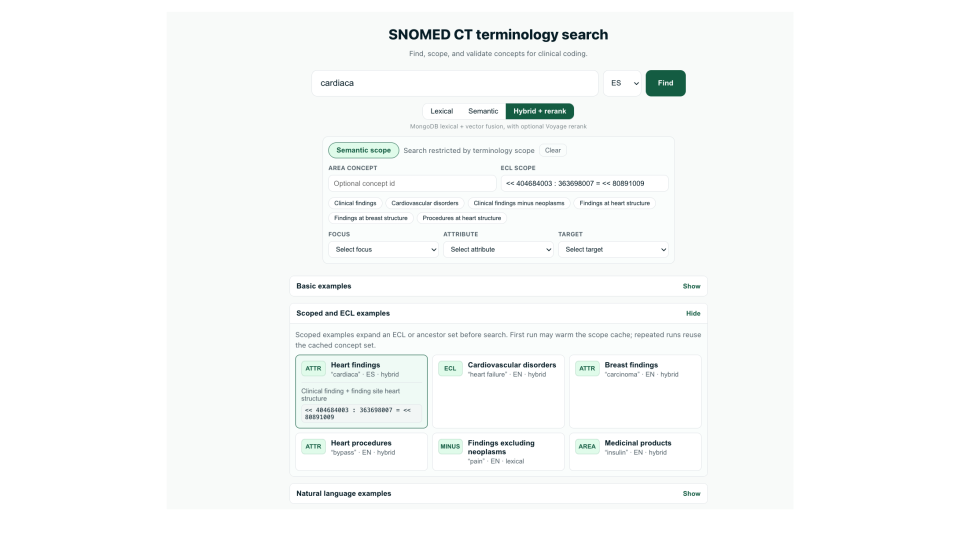
Figura 3. Búsqueda semántica ampliada con ámbitos ECL
Flujo de trabajo de notas clínicas básicas
Un usuario pega una nota clínica. El flujo de trabajo extrae menciones clínicas y señales de contexto, como hallazgos actuales, negación, historial, antecedentes familiares, acciones planificadas, incertidumbre y expresiones temporales.
El flujo de trabajo busca candidatos de SNOMED CT a través de MongoDB. Devuelve candidatos revisables con intervalos de evidencia y contexto. Un revisor puede aceptar, rechazar o marcar cada candidato para su revisión.
El nivel LLM opcional puede ayudar con la interpretación de texto y la selección de candidatos. Solo debe elegir entre los candidatos devueltos por MongoDB. No debe crear nuevos identificadores SNOMED ni conservar codificaciones sin revisión.
Después de la revisión, la aplicación almacena las codificaciones confirmadas en grounded_notes. Cada codificación guardada incluye el intervalo de evidencia, el concepto SNOMED seleccionado, la aserción, el sujeto, el estado y los ID de antepasado. Este patrón permite que las aplicaciones posteriores query el significado. Por ejemplo, una aplicación puede encontrar notas revisadas que contengan cualquier descendiente aceptado de un concepto clínico seleccionado.
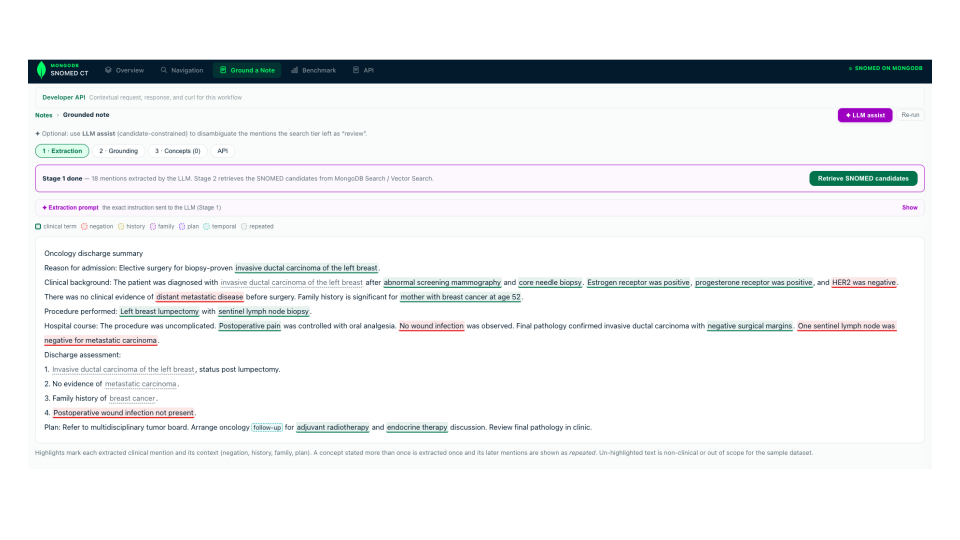
Figura 4. Fundamentación de una nota clínica: proceso LLM
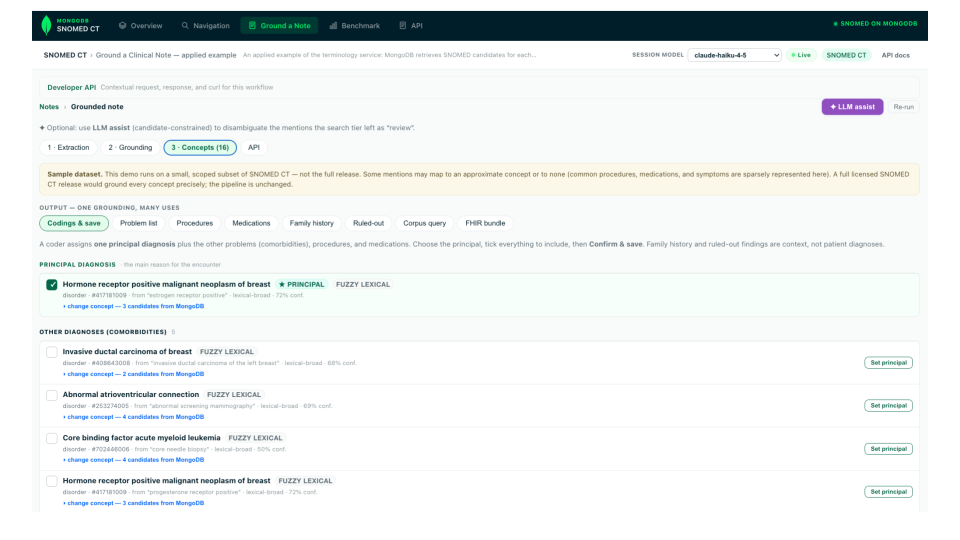
Figura 5. Fundamentación de una nota clínica después de la búsqueda de términos con MongoDB
Ejemplo de fragmentos de API
La solución expone API para los flujos de trabajo de navegación y notas clínicas básicas. Estos fragmentos muestran los patrones de solicitud principales.
Buscar términos y conceptos SNOMED
Utilice este endpoint para buscar la proyección a nivel de término. La respuesta agrupa los términos coincidentes en conceptos SNOMED. Devuelve resultados a nivel de concepto con el término coincidente, la visualización preferida, la categoría semántica y la procedencia de la búsqueda.
POST /api/navigator-search { "query": "heart failure", "languageCode": "en", "mode": "lexical", "limit": 24 }
Utilice el modo léxico cuando el usuario busque por un término conocido, sinónimo, nombre formal o identificador SNOMED. La API también admite modos semánticos e híbridos cuando la demostración está configurada para MongoDB búsqueda vectorial y reordenación.
Expandir un concepto y sus descendientes
Utilice este endpoint para expandir un conjunto de conceptos. SNOMED CT utiliza ECL para describir conjuntos de conceptos. En este ejemplo, la expresión << 84114007 significa “Insuficiencia cardíaca y todos los conceptos más específicos que se encuentran debajo de ella”.
POST /api/ecl { "expr": "<< 84114007", "languageCode": "en", "limit": 200 }
La implementación resuelve esta expresión con arreglos de antepasados precalculados en MongoDB. Este patrón acelera las query de descendientes comunes sin necesidad de una base de datos de grafo independiente para la arquitectura de demostración.
Basar una nota clínica en candidatos SNOMED
Utilice este punto final para extraer menciones clínicas candidatas del texto y recuperar candidatos SNOMED delimitados de MongoDB. La respuesta genera resultados revisables sin persistir códigos automáticamente.
POST /api/nlp-map { "text": "Patient with chronic systolic heart failure and type 2 diabetes. No evidence of chest pain at present.", "languageCode": "en" }
El flujo de trabajo de conexión a tierra detecta menciones clínicas y contexto, como negación, historial, historial familiar, planes y expresiones temporales. MongoDB proporciona los conceptos SNOMED candidatos. Un revisor confirma las codificaciones finales.
Guardar codificaciones confirmadas por el revisor
Utilice este punto final después de la revisión. La aplicación solo almacena codificaciones confirmadas y las enriquece con ID de antepasados para habilitar queries semánticas posteriores.
POST /api/coding-confirm { "text": "Patient with heart failure.", "languageCode": "en", "codings": [ { "mention": "heart failure", "conceptId": "84114007", "displayTerm": "Heart failure", "semanticTag": "disorder", "accepted": true } ] }
El documento guardado mantiene el concepto SNOMED seleccionado, el texto de evidencia, el contexto de aserción, el estado del revisor y los ID de antepasados. Este esquema permite que las querys posteriores ubiquen notas mediante un concepto general o un descendiente específico.
Query Grounded Notes por significado
Utilice este punto final para recuperar notas revisadas que contengan un concepto SNOMED seleccionado o sus descendientes clínicos.
POST /api/grounded-corpus { "conceptId": "84114007", "includeDescendants": true, "limit": 10 }
Este endpoint demuestra el valor downstream de almacenar ID de ancestros con codificaciones de revisión. Las aplicaciones pueden query el significado clínico en lugar de buscar solo palabras exactas.
Enfoque de modelo de datos
SNOMED CT representa datos conectados. Un concepto clínico puede tener muchos términos legibles por humanos, varios conceptos más amplios, muchos conceptos más específicos y relaciones formales con otros conceptos.
MongoDB funciona bien para este patrón porque la mayoría de las aplicaciones operativas necesitan una vista centrada en el concepto. Cuando un usuario abre un concepto, la aplicación necesita el identificador del concepto, los término de visualización, las descripción, los padres, los hijos, la ruta del antepasado, las relación, el estado activo y los metadatos de lanzamiento juntos.
Este enfoque no elimina la estructura del grafo. Almacena las relaciones y agrega arreglos amigables para query para patrones de navegación comunes. Por ejemplo, cada documento de concepto puede almacenar sus padres directos y su ruta de ancestros. Este patrón permite que la aplicación encuentre conceptos más amplios, conceptos secundarios y descendientes con query de MongoDB indexadas.
Por qué funciona este model
Las opciones de diseño a continuación abordan requisitos operativos específicos: búsquedas rápidas, búsquedas precisas, recorrido rápido de jerarquías y codificación auditable.
Mantener los datos de concepto juntos: una aplicación de terminología a menudo necesita renderizar una tarjeta de concepto completa. La incrustación de descripciones, resúmenes de relaciones, ID de padres, ID de hijos e ID de antepasados mantiene la vista operativa más útil en un solo documento.
Separe la búsqueda de la terminología de origen: La búsqueda es a nivel de término, no a nivel de concepto. Un concepto puede tener muchas descripciones en diferentes lenguajes y dialectos. Una proyección a nivel de término permite a MongoDB Search y MongoDB búsqueda vectorial clasificar el término exacto que coincidió mientras sigue devolviendo el concepto canónico.
Rutas de jerarquía de precómputo: SNOMED CT tiene una jerarquía enriquecida. Muchas aplicaciones necesitan query de descendientes rápidas, como “encontrar este concepto y todos los conceptos más específicos debajo de él”. Almacene los ID de los antepasados en cada concepto y en cada codificación clínica revisada. Luego, utilice índices multiclave para query de jerarquía comunes.
Almacenar evidencia con codificaciones revisadas: la codificación ofrece más valor cuando la aplicación puede explicar su origen. Almacene el concepto SNOMED seleccionado junto con el intervalo de texto clínico, el estado de la aserción, el contexto del sujeto y el estado del revisor. Este patrón admite auditar, revisión y query posteriores.

Figura 6. Metamodelo SNOMED CT y asignación de colecciones de MongoDB
SNOMED CT Metamodel y MongoDB colección Mapping
La solución utiliza tres colecciones de terminología, además de una colección de telemetría independiente. Las secciones siguientes describen la forma del documento y los campos principales de cada uno.
La colección snomed-irbd
Utilice snomed-irbd como vista de fuente de verdad para un concepto SNOMED CT. Cada documento representa un concepto en una versión, que contiene sus descripciones RF2, la definición de relaciones, conceptos principales, conceptos secundarios, estado activo, metadatos de versión y el cierre de antepasados precalculado que impulsa la jerarquía y la subsunción.
{ "conceptId": "44054006", "active": true, "effectiveTime": "20020131", "moduleId": "900000000000207008", "definitionStatusId": "900000000000074008", "descriptions": [ { "id": "73465010", "term": "Diabetes mellitus type II", "typeId": "900000000000013009", "languageCode": "en", "acceptabilityMap": { "900000000000509007": "..." } } ], "relationships": [ { "typeId": "116680003", "destinationId": "73211009", "relationshipGroup": "0", "active": "1" } ], "inferredParentIds": ["73211009"], "inferredAncestorIds": ["73211009", "64572001", "138875005"], "inferredChildIds": ["..."], "relationshipAttributeKeys": ["116680003|73211009"], "memberOfRefsetIds": ["..."], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "releaseAppliedAt": "2026-07-06T00:00:00.000Z" }
El snomed-irdb contiene los siguientes campos relevantes:
conceptIdRepresenta el identificador SNOMED (SCTID); la identidad de concepto estable.descriptions[]: Representa los nombres legibles para el concepto. Cada nombre es un sinónimo o el nombre totalmente especificado (el nombre clínico formal), y registra su lenguaje y si es preferido o aceptable en ese lenguaje. Estas entradas se asignan a las filas de descripción en los archivos de lanzamiento de SNOMED CTrelationships[]: Representa las relaciones del concepto con otros conceptos. La relación “Es un” define la jerarquía. Las relaciones de atributos definen propiedades clínicas como el sitio de hallazgo o el agente causal.relationshipAttributeKeys[]: Representa cada relación de atributo como un único valor de índice. Esto permite que la aplicación encuentre conceptos por un atributo específico y devuelva resultados con un índice en lugar de un análisis completo.inferredParentIds,ChildIds,AncestorIds: Representa el cierre precalculado acotado para la subsunción sin recorrido de grafo. Los descendientes se consultan con la cláusula{ inferredAncestorIds: conceptId }en lugar de almacenarse en cada concepto principal.
La prueba de colección snomed-term-search
Utilice snomed-term-search como proyección de búsqueda. Cada documento representa un término de descripción activo en un lenguaje y una versión, desnormalizado para MongoDB Search, filtrado con ámbito y MongoDB Vector Search autoincrustado. Esta estructura permite a los usuarios escribir un sinónimo, una abreviatura, un término localizado, un nombre clínico formal o una frase en lenguaje natural.
El documento de búsqueda repite el contexto del concepto para que cada resultado de búsqueda sea independiente. Un resultado puede mostrar el término coincidente, la visualización preferida, la categoría semántica, el estado activo, la versión y el alcance de la jerarquía sin recuperar el documento de concepto completo para cada candidato.
{ "conceptId": "44054006", "descriptionId": "116680003", "term": "Type 2 diabetes mellitus", "preferredTerm": "Type 2 diabetes mellitus", "fsn": "Type 2 diabetes mellitus (disorder)", "semanticTag": "disorder", "semanticTagKey":"disorder", "termType": "synonym", "preferred": true, "languageCode": "en", "definitionStatusId": "900000000000074008", "moduleId": "900000000000207008", "effectiveTime": "20020131", "parentIds": ["73211009"], "ancestorIds": ["404684003", "73211009"], "topRoots": ["404684003"], "areaTags": ["disorder"], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "embedText": "Type 2 diabetes mellitus | disorder | ..." }
La colección snomed-term-search contiene los siguientes campos relevantes:
conceptIddescriptionId: Vuelva a vincular al concepto y a la descripción específica.term,preferredTerm,fsn: Proporcione el término coincidente y el contexto del concepto, de modo que los resultados de la búsqueda sean autocontenidos.semanticTagsemanticTagKey,termType,preferred: Proporciona señales de filtro y clasificación.parentIds,ancestorIds,topRoots,areaTags: Filtros de alcance sin volver a unirse asnomed-irbd.releaseIdreleaseDate,effectiveTime: Proporcionar búsqueda con alcance de versión y visibilidad del mantenimiento de la versión.embedTextContiene el campo que MongoDB auto-incrusta utiliza para la búsqueda vectorial.
Este snippet explica la opción de diseño más importante: la proyección de búsqueda es a nivel de término. Muestra por qué una búsqueda de “Azúcar en sangre alto” aún puede devolver el concepto canónico “Diabetes mellitus”
Con la incrustación automática, solo almacena el campo embedText legible por humanos, y MongoDB Vector Search genera y mantiene la incrustación de ese campo automáticamente. No necesita un pipeline de incrustación o un almacén vectorial separados, ya que la capa semántica reside en la misma colección.
La colección grounded_notes
Utilice grounded_notes para almacenar la salida de la aplicación después de la revisión. Estos documentos no son datos de terminología de origen. Cada documento almacena los siguientes datos:
El texto de origen
El concepto SNOMED CT seleccionado
El lapso de evidencia
El contexto de aserción, como presente o ausente
El contexto del sujeto, como el paciente o un miembro de la familia
El estado de revisión
Los ID de ancestros
El siguiente ejemplo muestra esta forma.
{ "tenantId": "demo-hospital", "languageCode": "en", "text": "Patient with type 2 diabetes mellitus.", "codings": [ { "conceptId": "44054006", "system": "http://snomed.info/sct", "display": "Type 2 diabetes mellitus", "semanticTag": "disorder", "role": "principal", "target": "Condition.code", "assertion": "present", "subject": "patient", "status": "accepted", "evidence": { "text": "diabetes mellitus tipo 2" }, "ancestorIds": ["44054006","75934005"] } ], "recordedAt": "2026-07-07T16:22:47.210Z", "createdAt": { "$date": "2026-07-07T16:22:47.210Z" } }
Este diseño convierte el texto clínico en un significado clínico consultable. Una aplicación puede buscar más tarde notas revisadas que contengan un concepto o cualquier concepto más específico debajo de él en la jerarquía SNOMED CT. Cada codificación conserva su evidencia, por lo que un revisor puede rastrear cada código hasta el texto y el contexto exactos que lo produjeron, lo que respalda la auditoría y el uso posterior seguro.
La colección de telemetría
Utilice una colección telemetry separada para eventos de búsqueda, solicitudes de jerarquía, actividad de fundamentación de notas, comentarios y diagnósticos. Mantenga los datos de telemetría fuera del modelo de datos conceptual.
Compilar la solución
El repositorio público incluye el código de la aplicación, los scripts y un conjunto de datos de ejemplo. Los usuarios con licencia pueden reemplazar el conjunto de datos de ejemplo con sus propios archivos de la versión SNOMED CT.
Requisitos previos
Un clúster de MongoDB Atlas con MongoDB Search habilitado.
Acceso a una versión con licencia de SNOMED CT o a un pequeño conjunto de datos de muestra para fines de demostración.
Node.js y npm para la aplicación de demostración.
Opcional: configuración de incrustación automatizada de MongoDB búsqueda vectorial para búsqueda semántica.
Opcional: clave de reclasificación de Voyage u otro reclasificador configurado para el modo híbrido.
Opcional: puerta de enlace LLM para la extracción acotada y la desambiguación de candidatos.
Procedimiento
Preparar la entrada de terminología con licencia
Utilice la distribución SNOMED CT RF2 de su organización o una distribución JSON. Cargue esta entrada en MongoDB como la colección de conceptos canónicos utilizando su propio proceso de ingestión. La terminología por defecto corresponde a snomed-irdb. Esta colección es un requisito previo.
Los scripts de este repositorio operan en una colección canónica precargada; no leen archivos RF2. No confirme una versión completa en un repositorio público.
Preparar documentos de concepto canónicos
La colección canónica almacena cada concepto como un documento centrado en el concepto, que contiene sus descripciones, relaciones, padres, antepasados e información de jerarquía. Este esquema contiene metadatos de origen para admitir el estado activo e inactivo, la búsqueda con conocimiento de la versión, la inspección de descripciones y la navegación de relaciones.
Una vez que cargue la colección, normalice los campos para búsquedas coherentes y registre la versión de la versión en cada documento, de modo que los resultados sean reproducibles en todas las versiones.
NORMALIZE_APPLY=true npm run model:harden # normalize SCTIDs / strings RELEASE_ID_TARGET=20260601 RELEASE_ID_OVERWRITE=true npm run releaseid:stamp
Compilar el sidecar de términos
Genere snomed-term-search a partir de la colección de conceptos canónicos. El sidecar almacena un documento de término activo por versión, lenguaje, descripción y concepto. Repite el contexto del concepto clave para que los resultados de la búsqueda no necesiten unirse de nuevo a la colección de conceptos para cada tarjeta de resultados.
# Curated demo branches TERM_PROJECTION_SCOPE=demo npm run terms:rebuild # Full licensed local release TERM_PROJECTION_SCOPE=full npm run terms:rebuild # Replace documents while preserving index definitions when possible npm run terms:rebuild:replace
Crear índices de MongoDB
Cree los índices btree para la búsqueda de conceptos y la expansión de jerarquías. Cree el índice de MongoDB Search para la búsqueda de terminología léxica. Cree el índice de MongoDB búsqueda vectorial para la búsqueda semántica si utiliza el modo semántico o híbrido.
npm run indexes:build
Utilice los siguientes índices de colección de origen recomendados:
db.getCollection("snomed-irbd").createIndex({ releaseId: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, active: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, inferredAncestorIds: 1, active: 1 })
La búsqueda semántica utiliza la incrustación automática de MongoDB Vector Search con voyage-4 como modelo por defecto. El modo híbrido añade el reranker Voyage rerank-2.5 . Existe una reserva de incrustación manual de Voyage para clústeres sin incrustación automática.
Configurar búsqueda semántica y reclasificación
La búsqueda semántica e híbrida utiliza la incrustación automática de MongoDB búsqueda vectorial. Cree un índice de búsqueda vectorial en el campo embedText con un modelo de incrustación configurado en el clúster.
El modo híbrido añade un reordenador de Voyage opcional; configure VOYAGE_API_KEY para habilitarlo. Sin una clave, la búsqueda híbrida sigue funcionando y recurre al orden de fusión. El reordenador prueba primero la URL base configurada, luego la puerta de enlace de Voyage alojada en MongoDB correspondiente a https://ai.mongodb.com/v1 y, finalmente, el punto final de la plataforma nativa de Voyage.
Ejecute la aplicación de demostración
npm install npm run dev
Utilice un archivo .env.local delgado. Mantenga los valores predeterminados operativos en código o archivos de configuración, no como una larga lista de variables de entorno.
MONGODB_URI= MONGODB_DB=terminology VOYAGE_API_KEY= ENABLE_LLM_GROUNDING=false LLM_BASE_URL= LLM_API_KEY= LLM_AUTH_HEADER=api-key LLM_GROUNDING_MODEL=gpt-5.5 # Semantic / hybrid search MONGODB_VECTOR_MODE=autoEmbed MONGODB_VECTOR_INDEX=snomed_voyage_idx MONGODB_VECTOR_AUTO_EMBED_MODEL=voyage-4 VOYAGE_API_KEY= VOYAGE_RERANK_MODEL=rerank-2.5
Validar navegación
Ejecute las siguientes operaciones para verificar su flujo de trabajo de navegación:
Ejecute una búsqueda léxica de diabetes e insuficiencia cardíaca.
Ejecute una búsqueda semántica o híbrida de frases en lenguaje natural como azúcar en sangre alto o dificultad para respirar.
Abra un concepto e inspeccione el resumen, las descripciones, la jerarquía, las relaciones, los descendientes y el JSON sin procesar.
Ejecute una expansión de estilo ECL, como la expresión
<< 84114007.Verifique que las tarjetas de resultados muestren el término coincidente, el término preferido, la etiqueta semántica, el estado activo y la procedencia de la búsqueda.
Validar nota clínica en tierra
Ejecute las siguientes operaciones para validar su flujo de trabajo de Ground Clinical Note:
Cargue una nota clínica simple y un ejemplo más completo de resumen de alta.
Verifique la extracción de intervalos y la detección de contexto para menciones presentes, negadas, de antecedentes familiares, históricas, planificadas e inciertas.
Verifique que el sistema no codifique en exceso los síntomas genéricos para descendientes demasiado específicos.
Confirma solo las codificaciones revisadas y guárdalas en la colección
grounded_notes.Ejecute una query de MongoDB en
ancestorIdspara demostrar la capacidad de búsqueda operativa.
Lecciones clave
Ponga en funcionamiento SNOMED CT en MongoDB Atlas: sirva terminología clínica con forma de grafo a través de un modelo operativo centrado en documentos que admita búsquedas, jerarquías, relaciones y flujos de trabajo de aplicaciones.
Unificar la navegación de terminología y la búsqueda semántica: utilice MongoDB Search y MongoDB búsqueda vectorial para ayudar a los usuarios a encontrar, inspeccionar y definir el alcance de los conceptos SNOMED CT desde el mismo servicio respaldado por Atlas.
Texto clínico básico con evidencia revisada: utilice el servicio de terminología para proponer candidatos SNOMED CT a partir de notas clínicas y, a continuación, almacene codificaciones revisadas con evidencia, contexto y rutas ancestrales.
Autores
Francesc Mateu Amengual, MongoDB
Giovanni Rodríguez, MongoDB
Diego Canales, MongoDB
Obtén más información
Descripción general de la búsqueda en MongoDB: Aprenda cómo MongoDB admite la búsqueda de texto completo, el autocompletado, el filtrado, la puntuación y las experiencias de aplicaciones basadas en la búsqueda.
Obtenga SNOMED CT: Revise cómo las organizaciones acceden a SNOMED CT y comprenda el proceso de obtención de licencias para su país o territorio.
Conceptos, descripciones y relaciones de SNOMED CT: Aprenda los componentes básicos de SNOMED CT que esta solución asigna a los documentos de MongoDB.