Transforma los datos no estructurados de la fábrica en registros de trazabilidad listos para auditar. Cumple los requisitos de EPCIS 2.0 y del pasaporte digital de productos de la UE en tiempo real.
caso de uso: IA agencial, vista única
Productos: Atlas deMongoDB, Procesamiento de flujos de Atlas
emparejar: Amazon Web Services
Descripción general de la solución
El rastreo y seguimiento es la práctica de registrar cada evento en el recorrido de un producto, desde el abastecimiento de materias primas hasta la fabricación, distribución y entrega, en una cronología conectada y auditable.
La presión para actuar es real
Se prevé que el mercado mundial de seguimiento y localización alcance los 12 10.000 millones de dólares para 2030 el 2011. Tres plazos regulatorios obligan a los fabricantes a actuar:
US DSCSA: Requiere la serialización de fármacos a nivel de artículo para rastrear cada fármaco recetado a través de la cadena de suministro.
Pasaporte de batería de la UE: exige a los fabricantes que documenten el ciclo de vida completo de los vehículos eléctricos y las baterías industriales antes de febrero de 2027.
Pasaporte digital de productos de la UE: requiere un registro digital verificable para todos los productos vendidos en la UE antes del 2030.
Cada uno de estos mandatos comparte el mismo requisito: los fabricantes deben demostrar, en cualquier momento, dónde ha estado un producto y qué le sucedió. El costo de no cumplir con esto es alto. Por ejemplo, las retiradas de dispositivos médicos aumentaron un 8.67600% interanual en 2020, y 2024 una sola retirada de un producto farmacéutico puede costar hasta 13600 millones de dólares.
Los datos existen: el problema es acceder a ellos
El cumplimiento de estos requisitos depende de los datos, y la mayoría de los fabricantes ya los generan. El problema es que 90el 10 % de estos datos nunca se utiliza. Permanecen fragmentados: registros de operadores en texto libre, marcas de tiempo inconsistentes y unidades de medida mixtas que los procesos ETL tradicionales no pueden manejar sin esquemas rígidos y reglas de análisis poco flexibles. Para cuando los datos se limpian y estructuran, ya es demasiado tarde para evitar una retirada del mercado o cumplir con un plazo de cumplimiento.
Cómo funciona esta solución
La brecha entre los datos de fábrica fragmentados y los registros listos para el cumplimiento es un problema de ingeniería. Esta solución la cierra conectando eventos brutos de la planta de fábrica a un historial de productos estructurado y consultable mediante MongoDB Atlas y Amazon Web Services Bedrock.
Los datos brutos de la planta de producción se almacenan en MongoDB a medida que llegan y, posteriormente, se procesan mediante un sistema de limpieza basado en IA con tecnología AWS Bedrock. Este sistema normaliza cada evento, convirtiéndolo en un registro estructurado que cumple con la normaEPCIS..2 0 El recorrido completo del producto reside en un único documento, lo que permite a un auditor de cumplimiento o a un gestor de la cadena de suministro recuperar toda la información de la cadena de custodia en una sola lectura, sin uniones ni consultas a sistemas independientes.
Las industrias reguladas ya ejecutan esta arquitectura a escala:
McKesson 1rastrea.2 mil millones de números de serie farmacéuticos por año y cumplió con su plazo federal DSCSA en MongoDB Atlas.
GE HealthCare reduce el tiempo de recuperación de datos en un 9 83% utilizando Change Streams y Atlas Search.
Bosch realiza 6 un seguimiento de millones de eventos de fijación por aeronave con un registro de auditoría completo que cumple con las normas de la FAA.
Arquitecturas de Referencia
La arquitectura propuesta se basa en los siguientes componentes:
MongoDB Atlas sirve como plataforma de datos unificada.
AWS Bedrock gestiona el razonamiento de IA.
Una aplicación web Next.js muestra el recorrido del producto en tiempo real.
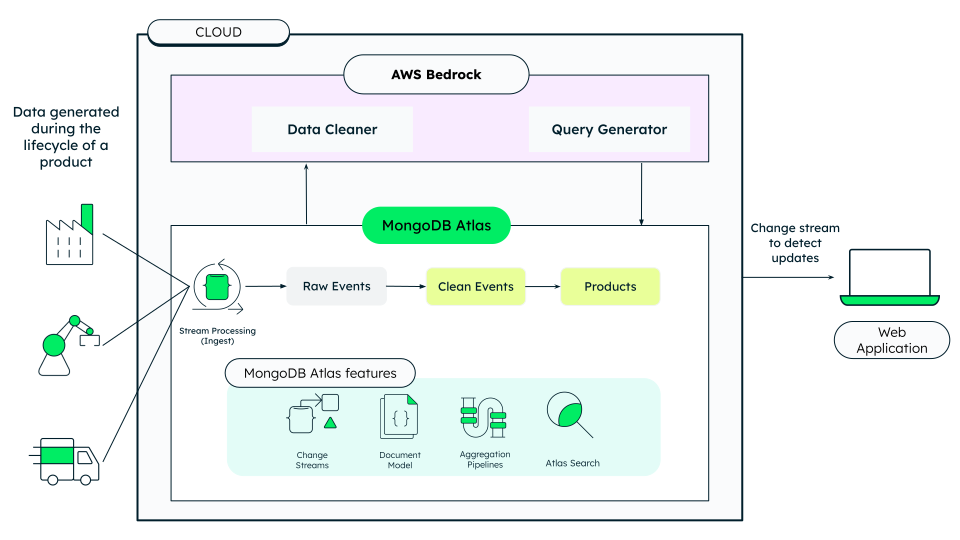
Figura 1. Arquitectura de la solución de rastreo y seguimiento
El flujo de trabajo comienza cuando los eventos de la fábrica llegan a MongoDB sin validación ni preprocesamiento. A continuación, Atlas Stream Processing dirige cada evento a una cola de procesamiento. A partir de ahí, un flujo de cambios activa AWS Bedrock, que normaliza el texto sin formato no estructurado y lo convierte en un registro estructurado que cumple con la norma EPCIS 2.0. Finalmente, MongoDB almacena el evento procesado y actualiza el documento del recorrido del producto, completando todo el proceso en cuestión de segundos.
El historial completo del producto reside en un único documento. La aplicación web recupera la cadena de custodia completa en una query, sin uniones.
Enfoque de modelo de datos
Un documento de producto en MongoDB comienza de forma sencilla y crece con cada etapa de fabricación. Los dos documentos siguientes muestran esa evolución.
El evento sin procesar
Los eventos de la planta de producción llegan exactamente como los escriben los operadores, sin validación ni preprocesamiento.
{ "text": "ALERT | BATCH-GM005-037 | ShenZhn WH | 06:15:00Z - rcvd \n raw mat'ls from Tianhe Biosci. Qty: 1000u glucose oxidase. \n Temp: 4.2C avg. Purity: 99.3%. 12 units MISSING — QA hold \n ref#QH-2024-001.", "stage": "Raw Materials Sourcing", "_timestamp": "2025-01-15T06:15:00.000Z" }
El documento del producto
Después del procesamiento, el evento limpio actualiza el documento del producto. Cada etapa de fabricación agrega una nueva entrada al arreglo journey. La cadena de custodia completa se encuentra en un solo lugar, como se muestra a continuación.
{ "_id": "GM-005", "productName": "Continuous Glucose Monitor", "status": "in_production", "currentStage": "Enzyme Coating", "journey": [ { "stage": "Raw Materials Sourcing", "status": "completed", "location": "Shenzhen, CN", "startTime": "2025-01-15T06:15:00.000Z", "eventCount": 3 }, { "stage": "Electrode Fabrication", "status": "completed", "location": "Penang, MY", "startTime": "2025-01-16T07:00:00.000Z", "eventCount": 4 }, { "stage": "Enzyme Coating", "status": "in_progress", "location": "Penang, MY", "startTime": "2025-01-17T08:00:00.000Z", "eventCount": 1 } ] }
Compilar la solución
Sigue los pasos que se indican en el archivo README del repositorio de GitHub para replicar esta solución.
Configurar el entorno
Copie el archivo .env.example en el archivo .env y, a continuación, agregue sus credenciales:
MONGODB_URI=mongodb+srv://<user>:<password>@<cluster>.mongodb.net/ DATABASE_NAME=track-and-trace AWS_ACCESS_KEY_ID=<your-access-key> AWS_SECRET_ACCESS_KEY=<your-secret-key> AWS_REGION=us-east-1
Ejecuta la aplicación
Inicie la aplicación localmente ejecutando el siguiente comando:
npm run dev
Navegue a http://localhost:8080 y haga clic en Start Simulation para comenzar a procesar eventos a través de la canalización.
Lecciones clave
Separación de la ingesta del procesamiento: Los eventos sin procesar llegan a MongoDB inmediatamente, independientemente de la carga posterior. Atlas Stream Processing gestiona el enrutamiento de forma independiente, lo que mantiene la capa de ingesta rápida y sencilla.
Utilice Change Streams para compilar pipelines de IA reactivos: un Change Stream activa el procesamiento de IA en el momento en que llega cada evento, lo que elimina la necesidad de sondeos o colas de mensajes con cero riesgo de eventos perdidos.
Acepte cualquier esquema en la ingestión; aplique la estructura en la salida: la capa de ingestión funciona sin validación; en su lugar, la estructura se aplica en el pipeline de limpieza de IA, donde cada evento se normaliza a EPCIS 2.0 antes de escribir en la colección de eventos.
Incorpore el recorrido, no solo el último estado: cada etapa, ubicación y anomalía se encuentran en un único documento de producto, lo que permite a los auditores de cumplimiento recuperar la cadena completa de custodia en una sola lectura, sin uniones.
Transforme datos desordenados en información utilizable con IA: un pipeline de limpieza impulsado por IA puede gestionar abreviaturas, errores tipográficos, unidades inconsistentes y campos faltantes. Cuando cambian los estándares, puede actualizar el prompt en lugar de reescribir código ETL complejo.
Autores
Humza Akthar, MongoDB
Javier Guajardo, MongoDB