Les bases de données documentaires présentent divers avantages, notamment :
- Un modèle de données intuitif qui est rapide et facile à utiliser pour les développeurs
- Un schéma flexible qui permet au modèle de données d’évoluer à mesure que les besoins de l’application changent
- La possibilité d’évoluer à l’horizontale
Du fait de ces avantages, les bases de données documentaires sont des bases de données à usage général qui peuvent être utilisées dans une variété de cas d’utilisation et de secteurs.
Les bases de données documentaires sont considérées comme des bases de données non relationnelles (ou NoSQL). Au lieu de stocker les données dans des lignes et colonnes fixes, les bases de données orientées documents utilisent des documents flexibles. Les bases de données orientées documents sont l'alternative la plus populaire aux relational databases tabulaires. En savoir plus sur les bases de données NoSQL.
Table des matières :
- Qu’est-ce que des documents ?
- Quelles sont les principales caractéristiques des bases de données documentaires ?
- Qu’est-ce qui différencie les bases de données documentaires des relational databases ?
- Dans quelle mesure les documents sont-ils plus faciles à manipuler que les tables ?
- Quelles sont les relations entre les bases de données documentaires et les autres bases de données ?
- Pourquoi ne pas simplement utiliser JSON dans une relational database ?
- Quels sont les points forts et les faiblesses des bases de données documentaires ?
- Quels sont les cas d’utilisation des bases de données documentaires ?
Qu’est-ce que des documents ?
Un document est un enregistrement dans une base de données de documents. Un document stocke généralement des informations sur un objet et ses métadonnées associées.
Les documents stockent les données sous forme de paires champ-valeur. Les valeurs peuvent être de divers types et structures, y compris des chaînes de caractères, des nombres, des dates, des tableaux ou des objets. Les documents peuvent être stockés dans des formats tels que JSON, BSON et XML.
Voici un document JSON qui stocke des informations sur un utilisateur nommé Tom.
Collections
Une collection est un groupe de documents. Les collections stockent généralement des documents ayant un contenu similaire.
Tous les documents d’une collection ne doivent pas nécessairement contenir les mêmes champs, car les bases de données orientées documents ont des schémas flexibles. Notez que certaines bases de données documentaires comportent une validation de schéma, de sorte que vous pouvez verrouiller le schéma si nécessaire.
En continuant avec l’exemple ci-dessus, le document contenant des informations sur Tom pourrait être stocké dans une collection nommée users. D’autres documents pourraient être ajoutés à la collection users pour stocker des informations sur d’autres utilisateurs. Par exemple, le document ci-dessous qui stocke des informations sur Donna pourrait être ajouté à la collection users.
Notez que le document de Donna ne contient pas les mêmes champs que celui de Tom. La collection users utilise un schéma flexible pour stocker les informations dont dispose chaque utilisateur.
Opérations CRUD
Les bases de données documentaires disposent généralement d’une API ou d’un langage de requête qui permet aux développeurs d’exécuter les opérations CRUD (Create, Read, Update et Delete).
- Create : les documents peuvent être créés dans la base de données. Chaque document a un identifiant unique.
- Read : les documents peuvent être lus à partir de la base de données. L'API ou le langage de requête permet aux développeurs d'interroger des documents en utilisant leurs identifiants uniques ou leurs valeurs de champs. Des index peuvent être ajoutés à la base de données pour améliorer les performances de lecture.
- Update : les documents existants peuvent être mis à jour, soit en totalité, soit en partie.
- Delete : les documents peuvent être supprimés de la base de données.
Quelles sont les principales caractéristiques des bases de données documentaires ?
Les principales caractéristiques des bases de données documentaires sont les suivantes :
- Document model : les données sont stockées dans des documents (contrairement aux autres bases de données qui stockent les données dans des structures telles que des tables ou des graphiques). Les documents correspondent à des objets dans la plupart des langages de programmation populaires, ce qui permet aux développeurs de développer rapidement leurs applications.
- Schéma flexible : les bases de données documentaires possèdent des schémas flexibles, ce qui signifie que tous les documents d'une collection n'ont pas besoin de contenir les mêmes champs. Notez que certaines bases de données documentaires prennent en charge la validation de schéma, de sorte que vous pouvez verrouiller le schéma si nécessaire.
- Distribuées et résilientes : les bases de données documentaires sont distribuées, ce qui permet une mise à l’échelle horizontale (généralement moins coûteuse que la mise à l’échelle verticale) et la distribution des données. Les bases de données documentaires offrent une résilience grâce à la réplication.
- Interrogation via une API ou un langage de requête : les bases de données documentaires possèdent une API ou un langage de requête qui permet aux développeurs d'effectuer les opérations CRUD sur la base de données. Les développeurs ont la possibilité de lancer une requête sur des documents en fonction d'identificateurs uniques ou de valeurs de champ.
Qu’est-ce qui différencie les bases de données documentaires des relational databases ?
Trois facteurs clés différencient les bases de données documentaires des relational databases :
- L'intuitivité du modèle de données : les documents correspondent aux objets du code, ce qui les rend beaucoup plus simples à manipuler. Il n'est pas nécessaire de décomposer les données entre les tables, d'effectuer des jointures coûteuses ni d'intégrer une couche distincte de mappage relationnel-objet (ORM). Les données auxquelles on accède ensemble sont stockées ensemble, ce qui permet aux développeurs d'écrire moins de code et aux utilisateurs finaux de bénéficier de meilleures performances.
- L'omniprésence des documents JSON : JSON est devenu une norme établie pour l'échange et le stockage de données. Les documents JSON sont légers, indépendants du langage et lisibles par l'homme. Les documents sont un sur-ensemble de tous les autres modèles de données, permettant aux développeurs de structurer les données selon les besoins de leurs applications : objets riches, paires clé-valeur, tables, données géospatiales et time series, ou les nœuds et arêtes d'un graphe.
- La flexibilité du schéma : le schéma d’un document est dynamique et auto-descriptif, si bien que les développeurs n’ont pas besoin de le prédéfinir au préalable dans la base de données. Les champs peuvent varier d’un document à l’autre. Les développeurs peuvent modifier la structure à tout moment, évitant ainsi des migrations de schéma perturbatrices. Certaines bases de données documentaires proposent une validation de schéma de sorte que vous pouvez éventuellement appliquer des règles régissant les structures des documents.
En savoir plus sur NoSQL vs relational databases.
Dans quelle mesure les documents sont-ils plus faciles à manipuler que les tables ?
Les développeurs trouvent généralement que travailler avec des données dans des documents est plus facile et plus intuitif qu’avec des données dans des tableaux. Les documents se mettent en correspondance avec les structures de données dans la plupart des langages de programmation populaires. Les développeurs n’ont pas à se préoccuper de fractionner manuellement les données connexes sur plusieurs tables lors de leur stockage ou de les rassembler lors de leur récupération. Ils n’ont pas non plus besoin d’utiliser un ORM pour gérer la manipulation des données automatiquement. Au lieu de cela, ils peuvent facilement travailler directement avec les données dans leurs applications.
Examinons à nouveau un document pour un utilisateur nommé Tom.
Utilisateurs
Toutes les informations concernant Tom sont stockées dans un seul document.
Voyons maintenant comment nous pouvons stocker ces mêmes informations dans une relational database. Nous allons commencer par créer une table qui stocke les informations de base sur l’utilisateur.
Utilisateurs
Comme un utilisateur peut aimer de nombreuses choses (ce qui signifie qu’il existe une relation un-à-plusieurs entre un utilisateur et des likes), nous allons créer une nouvelle table nommée « Likes » pour stocker les likes d’un utilisateur. La table Likes disposera d’une clé étrangère qui renvoie à la colonne ID dans la table Users.
Likes
De même, un utilisateur peut gérer plusieurs entreprises. Nous allons donc créer une nouvelle table nommée « Businesses » pour stocker les informations sur les entreprises. La table Businesses aura une clé étrangère qui fera référence à la colonne ID dans la table Users.
Businesses
Dans cet exemple simple, nous voyons que les données relatives à un utilisateur peuvent être stockées dans un seul document dans une base de données documentaire ou dans trois tables dans une relational database. Lorsqu’un développeur souhaite récupérer ou mettre à jour des informations sur un utilisateur dans la base de données documentaire, il peut écrire une requête sans jointure. L’interaction avec la base de données est directe, et la modélisation des données dans la base de données est intuitive.
Consultez la page Correspondance des termes et concepts entre SQL et MongoDB pour en savoir plus.
Quelles sont les relations entre les bases de données documentaires et les autres bases de données ?
Le document model est un sur-ensemble d’autres modèles de données, y compris de paires les clé-valeur, relationnel, objets, graphes et données géospatiales.
- Les paires clé-valeur peuvent être modélisées avec des champs et des valeurs dans un document. N'importe quel champ d'un document peut être indexé, offrant ainsi aux développeurs une flexibilité supplémentaire dans l'interrogation des données.
- Les données relationnelles peuvent être modélisées différemment (et certains diraient de manière plus intuitive) en regroupant les données associées dans un seul document à l'aide de documents intégrés et de tableaux. Les données connexes peuvent également être stockées dans des documents séparés et les références de base de données peuvent être utilisées pour connecter les données connexes.
- Les documents correspondent à des objets dans la plupart des langages de programmation populaires.
- Les nœuds et/ou les arêtes graphiques peuvent être modélisés comme des documents. Les arêtes peuvent également être modélisées via les références de base de données. Les requêtes graphiques peuvent être exécutées à l’aide d’opérations telles que $graphLookup.
- Les données géospatiales peuvent être modélisées sous forme de gammes dans des documents.
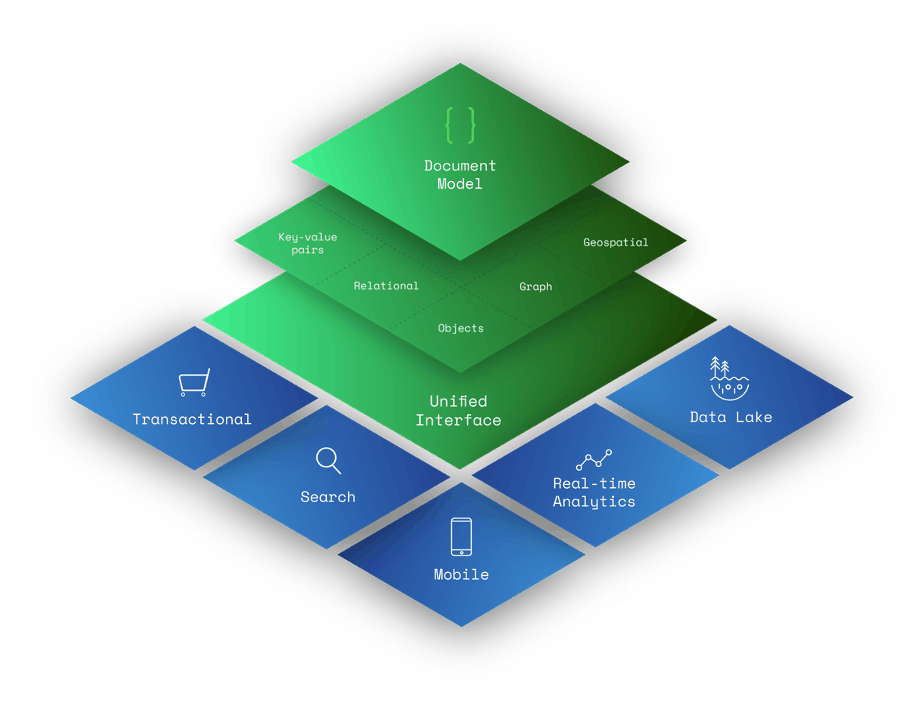
En raison de leurs riches capacités de modélisation des données, les bases de données documentaires sont des bases de données à usage général qui peuvent stocker des données pour divers cas d’utilisation.
Pourquoi ne pas simplement utiliser JSON dans une relational database ?
Avec les bases de données documentaires qui permettent aux développeurs de créer plus rapidement, la plupart des relational databases ont ajouté la prise en charge de JSON. Cependant, le simple ajout d’un type de données JSON n’apporte pas les avantages d’une base de données avec prise en charge native de JSON. Pourquoi ? Parce que l’approche relationnelle abaisse la productivité des développeurs, au lieu de l’améliorer. Voici quelques-uns des aspects avec lesquels les développeurs doivent composer.
Extensions propriétaires
Travailler avec des documents signifie utiliser des fonctions SQL personnalisées, spécifiques aux fournisseurs, qui ne sont pas familières à la plupart des développeurs et qui ne fonctionnent pas avec vos outils SQL préférés. Ajoutez des pilotes JDBC/ODBC de bas niveau et des ORM et vous vous retrouvez confronté à des processus de développement complexes qui abaissent la productivité.
Traitement des données primitives
Présenter les données JSON sous forme de simples chaînes et nombres plutôt que sous forme de types de données riches pris en charge par des bases de données orientées documents natives telles que MongoDB rend le calcul, la comparaison et le tri des données complexes et sujets aux erreurs.
Mauvaise qualité des données et tableaux rigides
Les relational databases offrent peu de possibilités de valider le schéma des documents ; vous n'avez donc aucun moyen d'appliquer des contrôles de qualité à vos données JSON. Et vous devez encore définir un schéma pour vos données tabulaires régulières, avec toutes les complications supplémentaires que cela implique lorsque vous devez modifier vos tables à mesure que les fonctionnalités de votre application évoluent.
Faibles performances
La plupart des relational databases ne maintiennent pas de statistiques sur les données JSON, ce qui empêche le planificateur de requêtes d'optimiser les requêtes par rapport aux documents et vous empêche d'ajuster vos requêtes.
Pas de scaling horizontal natif
Les relational databases traditionnelles ne vous permettent pas de partitionner (sharding) la base de données sur plusieurs instances pour évoluer à mesure que les charges de travail augmentent. Vous devez plutôt implémenter vous-même le sharding dans la couche applicative ou recourir à des systèmes de scaling vertical coûteux.
Quels sont les points forts et les faiblesses des bases de données documentaires ?
Les bases de données documentaires ont de nombreux atouts :
- Le document model est omniprésent, intuitif et permet un développement logiciel rapide.
- Le schéma flexible permet au modèle de données d’évoluer à mesure que les exigences de l’application changent.
- Les bases de données documentaires disposent de API riches et de langages de requête qui permettent aux développeurs d’interagir facilement avec leurs données.
- Les bases de données documentaires sont distribuées (permettant une mise à l’échelle horizontale ainsi qu’une distribution globale des données) et résilientes.
Ces atouts font des bases de données documentaires un excellent choix pour un usage général.
Une faiblesse couramment citée à propos des bases de données documentaires est que beaucoup d'entre elles ne prennent pas en charge les transactions ACID multidocuments. Nous estimons que 80 %-90% des applications qui exploitent le document model n'auront pas besoin d'utiliser des transactions multidocuments.
Notez que certaines bases de données documentaires comme MongoDB prennent en charge les transactions ACID multidocuments.
Consultez la page Que sont les transactions ACID ? pour en savoir plus sur la façon dont le document model élimine principalement le besoin de transactions multidocuments et dont MongoDB prend en charge les transactions dans les rares cas où elles sont nécessaires.
Quels sont les cas d’utilisation des bases de données documentaires ?
Les bases de données documentaires sont des bases de données polyvalentes qui répondent à une variété de cas d’utilisation pour des applications transactionnelles et analytiques :
- Vue unique ou hub de données
- Gestion et personnalisation des données clients
- Internet of Things (IoT) et données de time series
- Catalogues de produits et gestion de contenu
- Traitement des paiements
- Applications mobiles
- Déchargement du mainframe
- Analyses opérationnelles
- Analyses en temps réel
Résumé
Les bases de données documentaires utilisent un modèle de données documentaire intuitif et flexible pour stocker les données. Les bases de données documentaires sont des bases de données à usage général qui peuvent être utilisées dans une variété de cas d’utilisation et de secteurs.
Commencez à utiliser les bases de données documentaires en créant une base de données dans MongoDB Atlas, la plateforme de données de MongoDB. MongoDB Atlas propose une version généreuse et gratuite à vie que vous pouvez utiliser pour expérimenter et explorer le document model.