Todos los equipos que crean agente de IA descubren una verdad fundamental: sin la información correcta, un agente no puede dar una respuesta de forma fiable ni tomar la acción correcta.
A medida que las ventanas de contexto de los grandes modelos de lenguaje se hicieron más grandes, fue tentador suponer que simplemente darle a un agente más información mejoraría su precisión. En la práctica, un mayor contexto ralentiza a los agentes y aumenta sus costos, a la vez que reduce su precisión al enterrar las señales útiles entre información irrelevante.
Por eso, el éxito de un agente ahora depende de la ingeniería de contexto, la práctica de seleccionar, organizar y presentar a un agente solo la información que necesita para completar una tarea con éxito.
Y el núcleo de ese trabajo ocurre en la recuperación. La pregunta no es cuánto puede introducir en el contexto. Es qué diez cosas de diez millones elige.
La plataforma de datos inteligente de MongoDB reúne los modelos de incrustación y reclasificación de mejor clase de Voyage AI con una plataforma para crear, operar y evolucionar sistemas de recuperación complejos. Con la presentación hoy de la serie Rerank 3 y $rerank en el pipeline de agregación, los desarrollador pueden mejorar la calidad y el orden del contexto recuperar en el mismo sistema en el que se encuentran sus datos operativos. El resultado es una forma más sencilla de compilar sistemas de recuperación que proporcionen a los agentes el contexto que necesitan para llevar a cabo una acción.
La pila de recuperación
Una recuperación eficaz requiere un sistema coordinado para encontrar información útil, determinar qué es lo más importante y entregársela de forma eficiente al agente.
La estrategia determina cómo busca el sistema sus datos. La búsqueda por palabras clave puede mostrar términos exactos, mientras que la búsqueda vectorial encuentra contenido conceptualmente similar. Los filtro y los enfoques híbridos añaden precisión y control, lo que garantiza que solo se recupere el contexto relevante.
Los modelos determinan qué significa la relevancia para sus datos. Un modelo de incrustación más sólido ayuda a la búsqueda vectorial a identificar mejores candidatos mediante la comprensión de la similitud conceptual y la intención de la query. Un clasificador permite que la recuperación en la primera etapa se optimice para la recuperación y, a continuación, separa las coincidencias más sólidas del conjunto de candidatos.
El motor adecuado reúne estas tecnologías dispares, manteniendo los datos actualizados y las query eficientes a medida que el sistema se ejecuta en producción.
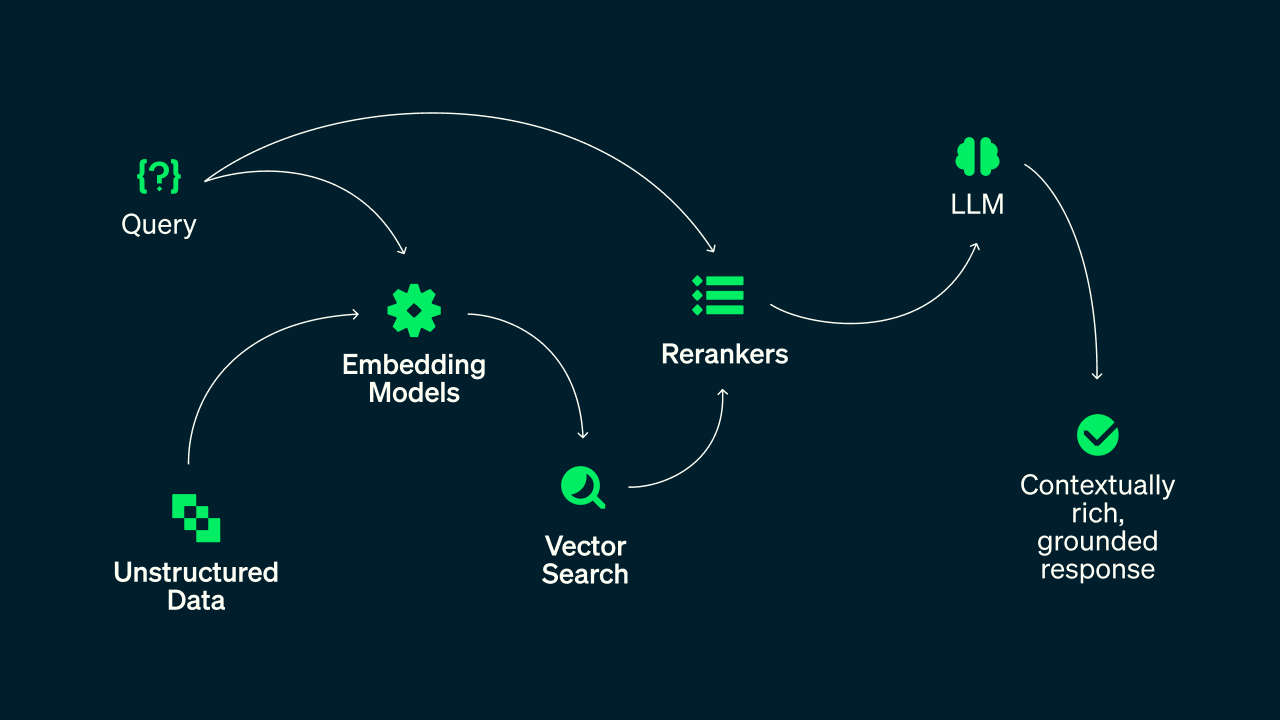
Sin una plataforma unificada para gestionar la recuperación, el trabajo se complica rápidamente. Puede que utilice un proveedor para las incrustaciones, otro para la clasificación y varios proveedores de bases de datos para sus datos operativos, de búsqueda y vectoriales. Eso significa más integraciones, tareas de sincronización y llamadas a la API que mantener. También puede crear problemas silenciosos: es posible que el índice de búsqueda vectorial utilice una versión del modelo de incrustación mientras que la aplicación utilice otra, lo que afecta a la relevancia sin causar un error explícito.
Figura 1. El pipeline de recuperación desconectado.
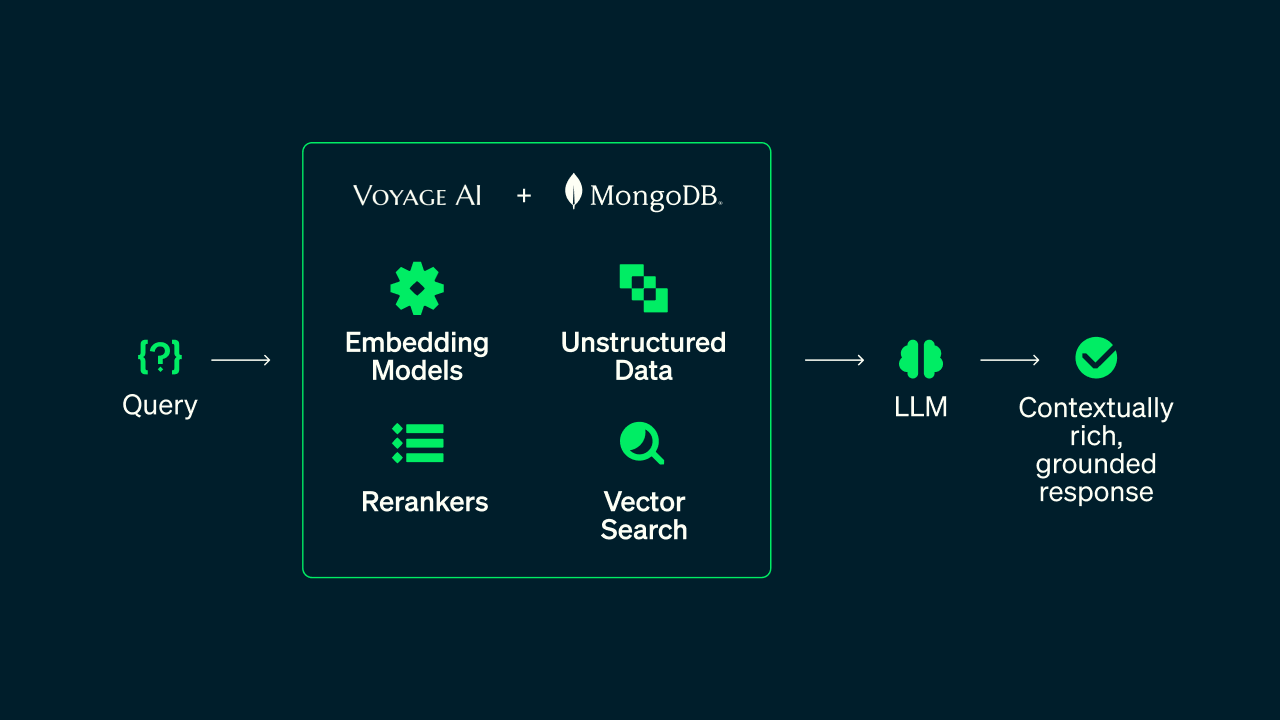
MongoDB reúne estas piezas en una sola plataforma. Es compatible con las estrategias de búsqueda que necesitan los desarrollador, incluidas la recuperación de texto, de vectores, híbrida y filtrada, y las combina con los modelos de incrustación y rerankers de última generación de Voyage AI. incrustación automatizada mantiene los vectores sincronizados a medida que cambian los datos, mientras que la nueva clasificación nativa permite a los desarrollador perfeccionar los resultados en el mismo pipeline de agregación. El resultado es una única query que puede buscar en los datos operativos, aplicar la estrategia de recuperación correcta, volver a clasificar los resultados y devolver el contexto que un agente necesita.
Figura 2. La pipeline de recuperación unificada impulsada por MongoDB.
Los modelos
La introducción de hoy de rerank-3 y rerank-3-lite ofrece una mayor precisión en todas las tarea, con las mayores ganancias en documento extensos y código. rerank-3 supera a Cohere Rerank v4.0 Pro en un 2,72% y a Qwen3-Reranker-8B en un 3,02% en general. Si usa rerank-2.5 en la actualidad, actualizar es un cambio de una sola línea en el nombre del modelo. La misma API, el mismo precio.
rerank-3 mejora la relevancia independientemente de cómo se recupere el conjunto inicial de candidatos. La tabla siguiente muestra el aumento de la precisión en varios métodos comunes de recuperación de primera etapa.
Table 1. Comparaciones de precisión.
El motor
MongoDB es el motor de recuperación operativa que subyace a todo esto, y cada estrategia se ejecuta de forma nativa frente a los mismos datos en los que la aplicación ya guardar. La búsqueda léxica detecta identificadores, códigos de error y nombres de productos exactos. La búsqueda vectorial detecta conceptos y paráfrasis. La recuperación híbrida los combina, y los filtros de metadatos mantienen el conjunto de candidatos lo suficientemente pequeño para mantener la velocidad. Nada de esto requiere mover datos a un sistema separado o mantener dos copias sincronizadas.
La incrustación automatizada gestiona la parte que normalmente se rompe. Los vectores se generan y actualizan a nivel de campo en tiempo real, con el consumo de tokens y el estado del índice visibles en la Interfaz de Usuario de Atlas. No hay tarea de incrustación que poseer, ni posibilidad de una división entre la versión del modelo en la que se compiló el índice y la versión del modelo con la que se ejecutan los query.
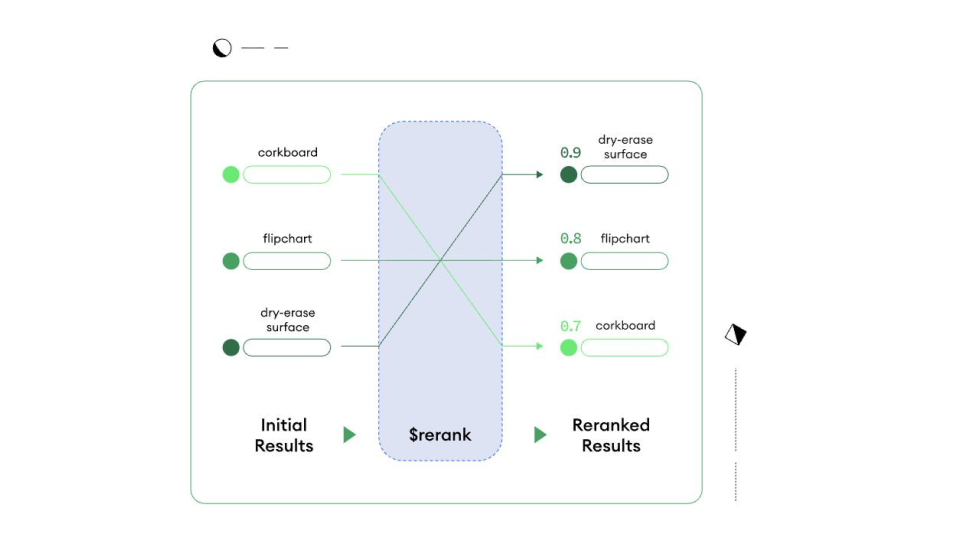
$rerank, disponible hoy, añade el paso de ordenación final a ese mismo pipeline. Se trata de una etapa sin índice que puede tomar cualquier conjunto de candidatos que la etapa anterior haya producido y volver a puntuarlo con rerank-3 o rerank-3-lite. Sin un proveedor independiente, sin ninguna llamar a una API externa, sin pasos de reensamblaje en el código de la aplicación, algo importante cuando un agente realiza varias llamadas de recuperación por tarea en lugar de una.
Figura 3. $rerank en acción.
Gravedad: qué sucede cuando esto funciona
Gravity está creando una red publicitaria que optimiza la publicidad para la era de la IA. La relevancia no es algo deseable; es el producto. Su problema no era la recuperación. Los modelos anteriores de incrustación y clasificación ofrecían puntuaciones de relevancia agrupadas de forma demasiado estrecha, por lo que Gravity no podía diferenciar con confianza una coincidencia sólida de una débil.
“Lo más importante que descubrimos en nuestras pruebas comparativas fue la capacidad de Voyage AI para distinguir a los candidatos que no encajan bien y promocionar realmente a los que sí encajan”, afirmó Leo Martinez, cofundador y CTO de Gravity. Cambiar a Voyage AI redujo la latencia de recuperación en aproximadamente un 50 % y mejoró la precisión a medida que aumentaba el volumen de solicitudes.
Cerrando The Gap
La calidad de la recuperación es una capa de lo que MongoDB está creando para que se ejecuten los agentes. MongoDB 9.0 y Atlas Infinite son la capa de rendimiento y de escalar elásticamente, absorbiendo el tráfico irregular que crean las cargas de trabajo de los agentes. Atlas Agent motor es la capa de memoria y gobernanza, que brinda a los agentes contexto y barandillas persistentes durante las sesiones; la recuperación se realiza a través de Atlas Vector Search y Voyage AI. Un agente decide qué recuperar antes de decidir qué hacer. Una infraestructura más rápida sobre una mala recuperación solo significa actuar antes sobre lo incorrecto.
Obtener una recuperación correcta ya no requiere una arquitectura compleja. La incrustación automatizada gestiona las incrustación, $rerank gestiona el orden y ambas se ejecutan en sus datos operativos directamente en MongoDB. Los modelos también están disponibles de forma autónoma a través de la Atlas Embedding and Reranking API.
Próximos pasos
Empiece con la incrustación automatizada y la reranking nativo aquí. Para obtener todo lo que anunciar en MongoDB.local NYC, así como las últimas actualizar de productos, visite nuestra página Qué hay de nuevo.