什么是向量搜索?
生成式人工智能使用向量对非结构化数据(文本、图像和音频)进行智能语义搜索。向量对于构建推荐引擎、异常检测和对话式人工智能至关重要。MongoDB 的原生功能使得广泛的应用场景得以实现,并提供了变革性的用户体验。
向量和 MongoDB 的结合力量
金融时报 FT 核心平台技术总监
金融时报 FT 核心平台技术总监
Novo Nordisk 内容数字化主管

Okta 工程主管

Delivery Hero 高级数据科学家
Kovai 公司 CEO


学习资源中心


常见问答
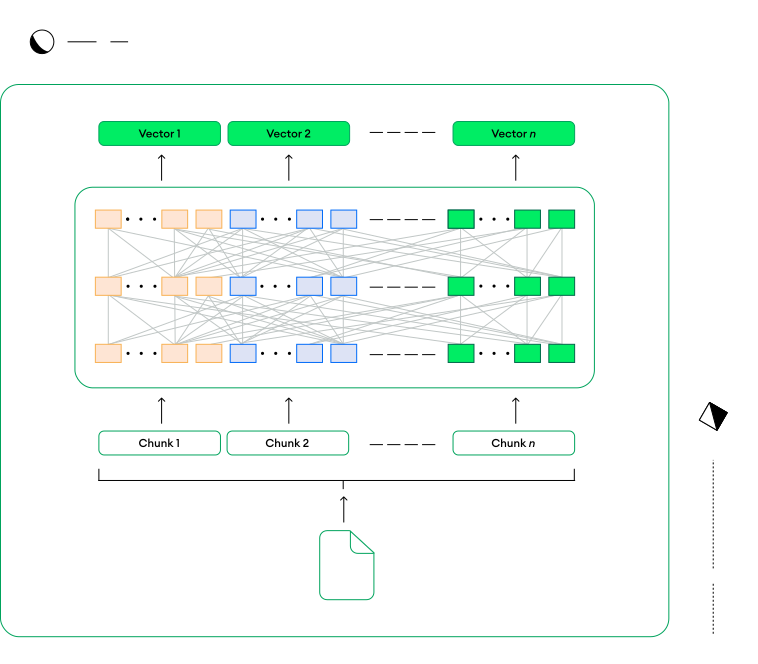
自动嵌入是直接在 MongoDB 中为数据生成向量嵌入的功能。当您在向量搜索索引中定义自动嵌入字段时,MongoDB 会在摄取、更新和查询时自动使用 Voyage AI 模型创建嵌入,从而使向量与您的文档同步,而无需外部管道。
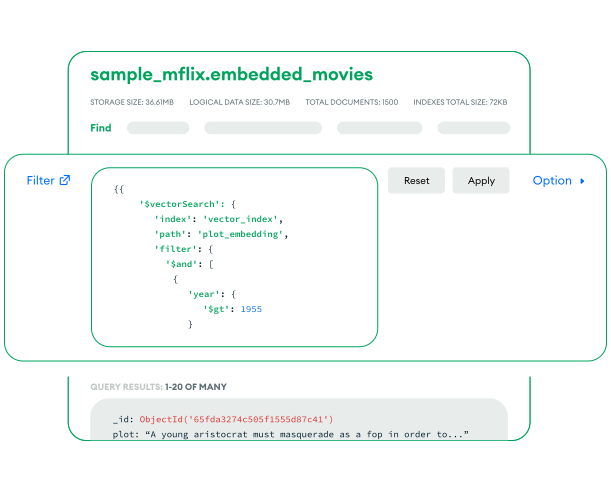
MongoDB Vector Search 支持根据向量中捕获的语义来搜索数据,而 MongoDB Search 则支持关键字搜索(即基于实际文本和任何定义的同义词映射)。
可以,MongoDB 是向量数据库。Atlas 是完全托管的、AI 就绪的智能数据平台,具有丰富的功能,包括文本或词汇和向量搜索。不同于使用独立或附加的向量数据库,我们平台的多功能性使用户能够存储其操作数据、元数据和向量嵌入,并无缝使用向量搜索进行索引、检索和构建高性能的生成式人工智能应用程序。MongoDB Vector Search 也适用于 MongoDB Enterprise Advanced,这是在本地和私有云生产中运行 MongoDB 的最灵活的方式。它也可用于 MongoDB Community Edition。
在使用“自动嵌入”时,推理、身份验证、扩展、重试和同步由 MongoDB 进行管理。无需预配外部嵌入服务,无需轮换密钥,也无需操作同步基础架构。嵌入模型将根据您的实际令牌用量计费。
在使用“自带嵌入”时,您负责引入来自您选择的提供程序的生成向量嵌入。所有相关操作(计费、费率限制、API 密钥管理)均需要由您处理。
KNN 是“K-最近邻”的缩写,是一种常用于查找相邻向量的算法。
ANN 是“近似最近邻”的缩写,是一种寻找相似向量的途径,以牺牲准确性为代价来提升性能。这是用于支持 Atlas Vector Search 的核心算法之一。我们的近似最近邻搜索算法使用分层可导航小世界 (HNSW) 图来有效地索引和查询数百万个向量。
ENN 是“精确最近邻”的缩写,是一种查找相似向量的方法,以牺牲一些性能来换取准确性。此方法返回与查询向量最接近的向量,向量数量由变量限制指定。精确向量搜索 (ENN) 查询执行可以为最多 10,000 个文档的未筛选查询保持亚秒级延迟。它还可以为高度选择性的过滤器提供低延迟响应,将大量文档限制为 10,000 个或更少,并按向量相关性排序。
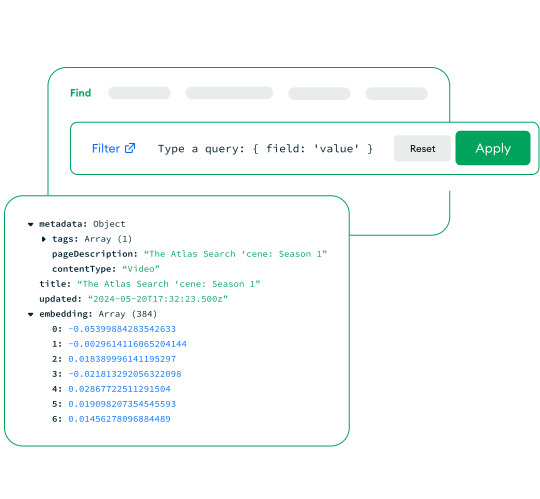
是的,MongoDB Vector Search 可以查询任何可以转化为向量嵌入的数据。document model 的好处之一是您可以将嵌入与丰富的数据一起存储在文档中。
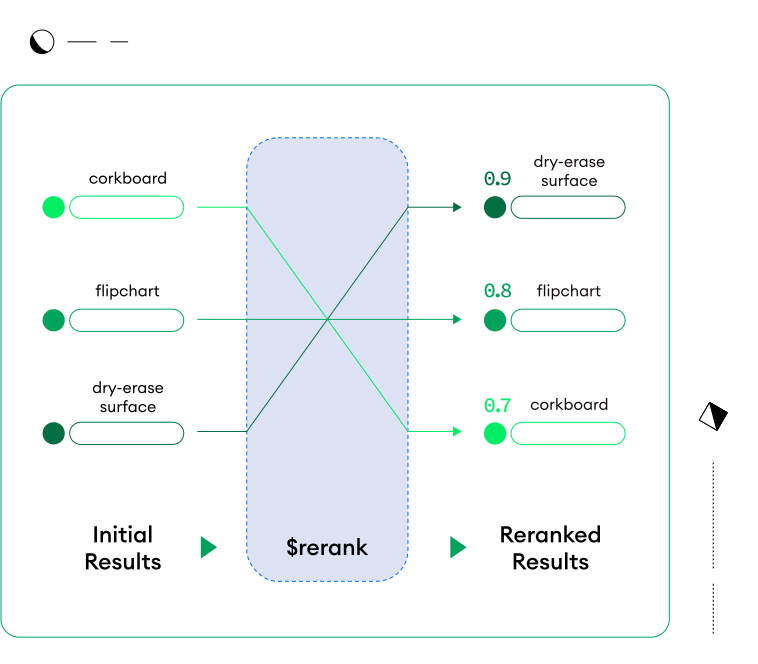
原生重排序 ($rerank) 通过将 Voyage AI 的顶级重排序模型直接集成到 MongoDB 查询引擎中,瞬间提高了检索精度。MongoDB 原生重排序允许用户确保仅将高度相关的数据传送到 LLM,从而优化词元开销并提高准确性。
- 简化部署
- 统一的开发人员体验
- 水平、垂直、独立扩展
- 集成的AI生态系统
- 全球超过 125 个地区