Les applications modernes génèrent des télémétries à chaque couche de la pile, mais il reste souvent difficile de comprendre ce qui a changé et pourquoi. Les signaux de base de données se trouvent fréquemment dans des workflows distincts, obligeant les équipes à basculer entre les tableaux de bord, à corréler les données déconnectées et à résoudre les problèmes de performance sans disposer de tout le contexte opérationnel.
Avec MongoDB 9.0, nous facilitons la compréhension du comportement des bases de données et accélérons la résolution des problèmes. Nous introduisons trois améliorations en matière d’observabilité qui aident les équipes à passer plus rapidement de la détection au diagnostic :
Des améliorations d'OpenTelemetry qui intègrent les métriques, les journaux et les événements d'Atlas dans les outils d'observabilité déjà utilisés par les équipes d'ingénierie.
Une UI de métriques repensée qui offre une vue plus claire de l’état de santé et des performances au niveau du cluster.
Query Shape Insights pour les opérations d’écriture, qui étend les diagnostics au niveau des requêtes au-delà des lectures.
Ensemble, ces fonctionnalités d’observabilité aident les équipes à passer moins de temps à chercher des réponses et plus de temps à résoudre les problèmes, à optimiser les performances et à maintenir des applications fiables.
Intégrez la télémétrie de MongoDB Atlas dans la pile d'observabilité
Lorsque le contexte critique de la base de données réside dans des systèmes distincts, le dépannage peut nécessiter de changer d'outil et de reconstituer manuellement ce qui a changé ; MongoDB Atlas aide à combler cette lacune en intégrant la télémétrie de la base de données dans les workflows d'observabilité que les équipes utilisent déjà. Désormais, Atlas Events Integration fournit aux équipes une nouvelle source de contexte opérationnel.
Atlas Events Integration permet aux clients d’exporter les événements du flux d’activité Atlas, notamment les modifications de cluster, les changements liés à la gestion des utilisateurs, les mises à jour de l’accès réseau et les changements de configuration des projets ou de l’organisation, vers des destinations compatibles avec OpenTelemetry et d’autres intégrations prises en charge. En mettant ces événements à disposition aux côtés des données d’observabilité existantes, les équipes peuvent mieux comprendre non seulement qu’un changement a eu lieu, mais aussi ce qui a changé.
En les associant aux intégrations de métriques et de journaux de MongoDB Atlas, les équipes peuvent corréler les problèmes de performance avec l’activité opérationnelle qui peut y avoir contribué. Par exemple, un pic de latence peut être consulté parallèlement aux changements de configuration récents, aux mises à jour des accès ou aux événements de mise à l'échelle, aidant ainsi les équipes à passer plus rapidement du symptôme à la cause profonde.
Ensemble, les métriques, les journaux et les événements offrent une vision plus complète des opérations de base de données. Il en résulte une expérience d’observabilité plus connectée qui aide les équipes à résoudre les problèmes plus rapidement, à réduire la complexité opérationnelle et à acquérir le contexte nécessaire pour résoudre les problèmes avec confiance.
Un moyen plus simple de comprendre l'état de santé du cluster
Les intégrations externes aident les équipes à intégrer Atlas dans une stratégie d'observabilité plus large. La nouvelle UI des métriques permet de mieux comprendre l'état de santé des clusters directement dans Atlas.
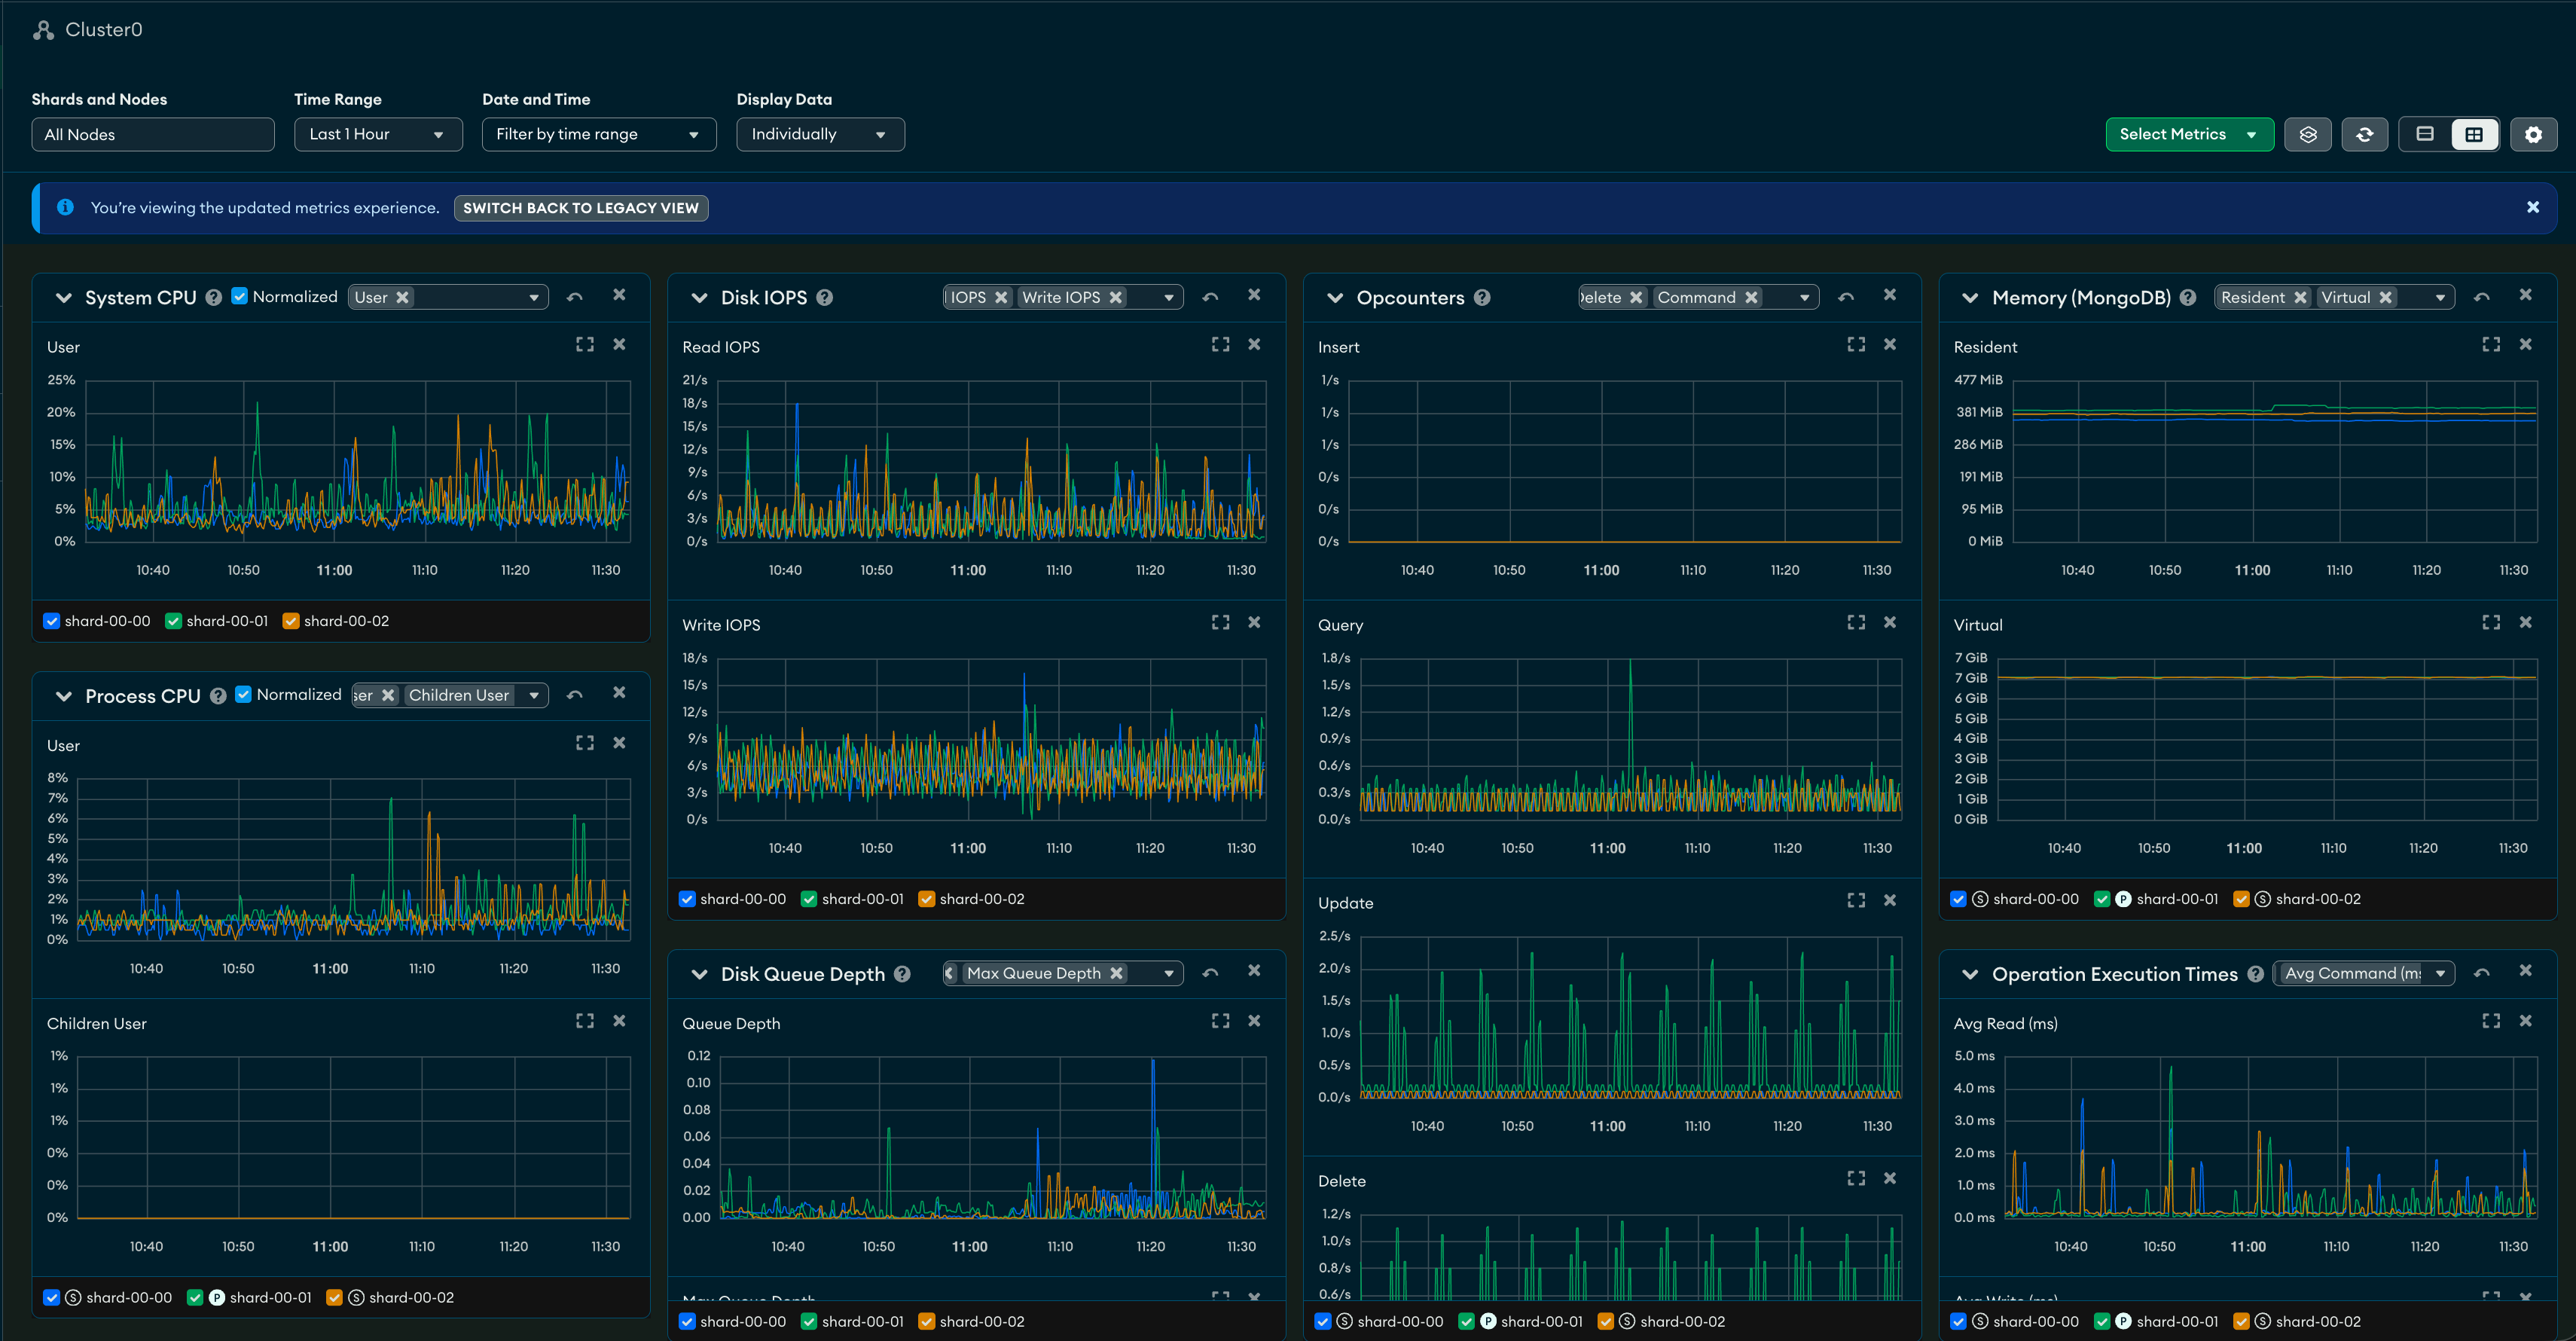
L’expérience repensée remplace un workflow de métriques fragmenté par une vue unifiée unique des métriques de cluster. Les métriques sont présentées dans une expérience plus claire, au niveau du cluster, avec des sélecteurs de nœuds qui aident les utilisateurs à se concentrer sur les systèmes pertinents pour une enquête.
Cela compte lorsque le temps est limité. Les ingénieurs de plateforme, les SRE et les DBA ne devraient pas avoir à naviguer entre plusieurs pages pour se faire une idée du comportement du cluster. Les développeurs d’applications et les responsables de l’ingénierie devraient pouvoir associer un symptôme d’application au signal Atlas correspondant sans avoir à devenir spécialistes de l’observabilité. Un flux de travail plus cohérent aide les deux groupes à passer moins de temps à chercher et plus de temps à diagnostiquer.
Figure 1. L'UI de métriques Atlas repensée fournit une vue unifiée de la performance et de la santé du cluster, avec une navigation simplifiée, des métriques au niveau du cluster et des contrôles de sélection des nœuds.
La nouvelle expérience vise également à offrir une base plus solide pour la prise en charge future des métriques et à garantir un service plus fiable. Les liens existants vers l’ancienne expérience continuent de fonctionner via des redirections, et les workflows environnants, notamment les intégrations tierces, les points de terminaison de métriques de l’API Admin Atlas, la diffusion d’alertes, la facturation, ainsi que Performance Advisor ou Query Insights, ne sont pas modifiés par cette refonte de l’UI.
Les analyses des formes de requête couvrent désormais les opérations d’écriture
Les performances des applications dépendent à la fois des opérations de lecture et d’écriture. Si la visibilité sur les lectures est essentielle, des opérations d’écriture inefficaces peuvent également entraîner de la latence, une consommation excessive de ressources et une augmentation des coûts d’infrastructure. Avec les clusters Atlas exécutant MongoDB 9.0 ou une version ultérieure, Query Shape Insights prend désormais en charge les opérations d’insertion, de mise à jour et de suppression, ce qui permet aux équipes de mieux comprendre l’impact des modèles de requête sur les performances de la charge de travail.
Avec la prise en charge des écritures, les équipes peuvent :
Identifiez les opérations de mise à jour et de suppression inefficaces, y compris les filtres non indexés et les mises à jour importantes.
Analysez l'impact des écritures à l'aide de mesures telles que Docs mis en correspondance, Docs modifiés, Docs insérés/mis à jour, Docs insérés et Docs supprimés.
Examinez l’activité des index liée aux écritures, notamment Clés insérées et Clés supprimées.
Utilisez le temps CPU et d’autres indicateurs de performance pour comprendre l’utilisation des ressources et réduire les coûts d’infrastructure superflus.
Filtrez et examinez le comportement des requêtes sur les replica sets et les clusters partitionnés.
Dans MongoDB 9.0 et versions ultérieures, Query Shape Insights utilise un échantillon aléatoire léger de 1 % des opérations de lecture et d’écriture. Cela permet d’obtenir une visibilité sur les charges de travail en production avec une surcharge minimale. Notez que les totaux affichés ne reflètent que les opérations échantillonnées, soit environ 1 % de la charge de travail réelle, et non le volume total. Les formes de requête exécutées rarement peuvent ne pas apparaître.
Les analyses des formes de requête regroupent les opérations par forme — en capturant la structure de la requête sans ses valeurs spécifiques — de sorte que des milliers de requêtes individuelles se réduisent à une poignée de formes. Les équipes peuvent identifier les schémas récurrents de charge de travail, établir un lien entre les problèmes de performance et les requêtes qui les provoquent, et valider l’impact de l’indexation ou des modifications apportées à l’application.
Disponible pour les clusters Atlas dédiés exécutant MongoDB 8.0 ou une version ultérieure, Query Shape Insights offre une vue plus complète du comportement de la charge de travail et, avec MongoDB 9.0, un moyen plus rapide d’optimiser les lectures et les écritures.
Une observabilité adaptée à la façon dont les équipes travaillent
À mesure que les applications deviennent plus distribuées et que les environnements opérationnels se complexifient, les équipes ont besoin d’outils d’observabilité qui leur offrent à la fois visibilité et contexte.
MongoDB 9.0 aide les entreprises à intégrer la télémétrie de la base de données dans les workflows d’observabilité existants, à simplifier les investigations sur les performances au sein de MongoDB Atlas et à mieux comprendre les modèles de requête qui affectent les performances des applications.
Que vous acheminiez des métriques, des journaux ou des événements Atlas vers votre plateforme d’observabilité globale, que vous analysiez l’état de santé du cluster directement dans Atlas ou que vous optimisiez les charges de travail de lecture et d’écriture avec Query Shape Insights, l’objectif est le même : aider les équipes à passer plus rapidement de la détection d’un problème à la compréhension de sa cause et à la prise de mesures. L’observabilité ne se limite pas à la collecte de signaux ; elle permet également de transformer ces signaux en informations opérationnelles exploitables.
Pour aller plus loin
Commencez à utiliser ces fonctionnalités dès aujourd'hui gratuitement sur mongodb.com/atlas.
Configurez votre premier point de terminaison des métriques OpenTelemetry via l'UI ou Terraform d'Atlas, exportez les journaux et événements d'Atlas, explorez la nouvelle UI des métriques et utilisez les insights de la forme de la requête pour étudier les performances de lecture et d'écriture sur vos clusters dédiés.