重要なポイント
- 検索拡張生成(RAG)は、関連データを取得して言語モデルと組み合わせ、正確でコンテキストに応じた回答を得るための手法です。
- キーワード検索は、入力されたキーワードに基づいて検索結果を生成するのに対し、ベクトル検索はセマンティック検索を使用してコンテキストを認識した結果を生成します。ハイブリッド検索は両方を組み合わせます。
- 再ランク付けは複数の検索手法の結果を並べ替え、最も関連性の高いドキュメントが上位に表示されるようにします。
- RRF は、複数の検索手法のランキングを一つのランキングにまとめる効率的な再ランキングアルゴリズムであり、精度と関連性を向上させます。
- RRF の重要なユースケースには、医療支援とリサーチ、製品検索、財務予測、市場分析などがあります。
目次
- キーワード検索を使用した検索結果
- ベクトル検索を使用した検索結果
- ハイブリッド検索
- 異なるタイプの取得方法
- ハイブリッド検索を使用した検索拡張生成(RAG)
- クエリ変換の例
- RRF を使用した RAG のユースケース
- よくある質問
- 関連コンテンツ
相互ランク融合(RRF)は、ハイブリッド検索を実装するための一般的なアルゴリズムです。これは、キーワード検索、ベクトル検索など、複数の検索からのランキングを、より正確な単一のランキングに集約します。
RRF について深く掘り下げる前に、キーワード検索とベクトル検索を個別に利用した場合の制限について説明します。
キーワード検索を使用した検索結果
キーワード検索は、ユーザーのクエリで指定されたキーワードのみに依存します。検索結果はキーワードの一致のみに基づいており、特には曖昧なクエリの場合、文脈上の関連性は無視されます。たとえば、キーワード検索を使用して「reciprocal rank fusion」を検索すると、これらの正確なキーワードを含む結果のみが返されますが、ランクの再設定、検索拡張生成、ハイブリッド検索など、関連していて文脈的に適切な結果が得られない場合があります。
ベクトル検索を使用した検索結果
ベクトル検索は、KNN アルゴリズムに基づいて、意味的に適切な結果を検索します。検索には次の2つのタイプがあります。
スパースベクトル検索
この方法は、検索語の出現頻度(少/多/なし/あり)を探す、重み付けされた高次元の低密度ベクトルを使用することで、キーワード検索を拡張します。ただし、検索クエリのコンテキストや意味を完全には捉えられません。
高密度ベクトル検索
高密度ベクトルは、テキストなどのデータを複数の次元を持つ数値ベクトルとして表現するもので、各次元はデータの何らかの詳細を捉えます。これらの高密度ベクトルは、ディープラーニングモデルを使用して作成されます。クエリが実行されると、ベクトル間の類似性が測定され、互いに最も近いベクトル表現が特定されます。ベクトル同士が近いほど、コンテキスト上の関連性が高くなります。このようにして、高密度ベクトル検索は意味的に適切な検索結果を提供します。
ハイブリッド検索
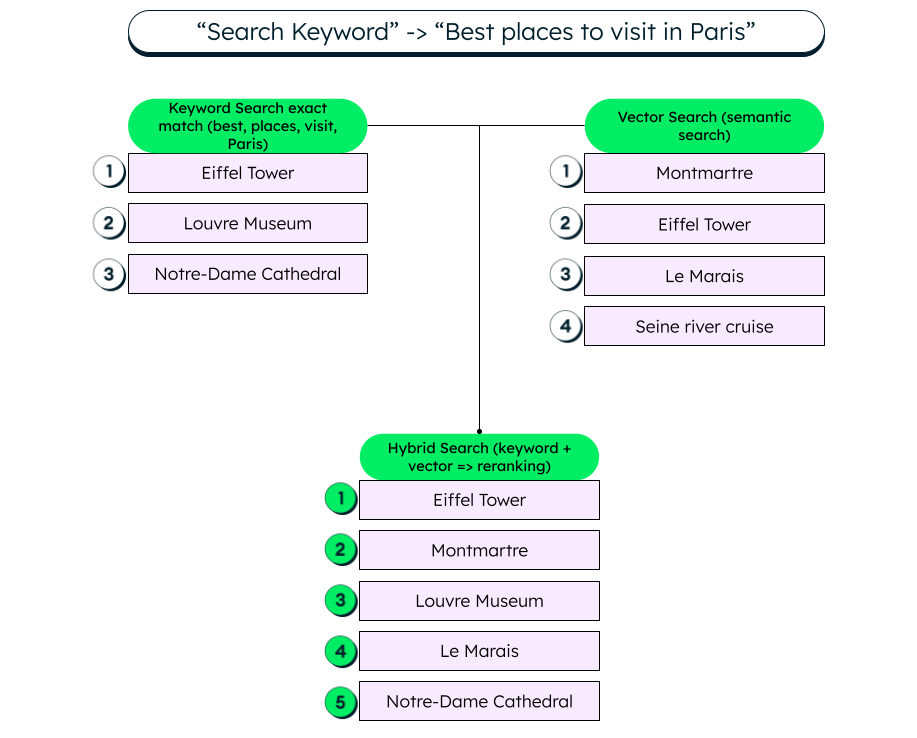
ハイブリッド検索は、キーワード検索やベクトル検索など、さまざまな種類の検索を組み合わせて、関連性の高いドキュメントのリストを複数生成します。これらの組み合わせた結果を再ランク付けモジュールに渡すと、関連性シグナルや学習済みスコアリングに基づいて最終的なランキング順序が最適化されます。以下に例を示します。
異なるタイプの取得方法
基本的な方法からより高度な検索方法まで、それぞれに長所と短所があり、異なるユースケースに適しています。以下に、重要な検索手法の概要を簡単に示します。
BM25
BM25 は、ユーザーが入力した正確な単語に基づいて結果が返される従来のキーワード検索アルゴリズムです。ドキュメント検索のように完全一致の結果が必要な場合は、BM25 が最適です。
vectorSearch
ベクトル検索の取得は、入力用語間のセマンティック類似性を捉え、コンテキストに関連する結果を提供するように試みます。高密度ベクトル埋め込みを使用して、近接する単語を見つけ、応答の関連性を向上させます。LLM ベースの質問応答システムやチャットボットに非常に便利です。
マルチクエリ検索
マルチクエリリトリーバーは、大規模言語モデル(LLM)を使用して、同じユーザークエリの複数のバージョンまたは解釈を生成します。その後、各クエリの検索結果を集約して、より包括的な最終クエリ応答を取得します。これは、製品推奨システム、ドキュメント検索、学術研究に役立つ場合があります。
アンサンブル
アンサンブルリトリーバーは、キーワード検索(BM25 のような低密度リトリーバー)と高密度リトリーバー(ベクトル検索)を組み合わせて、関連ドキュメントのリストを作成します。相互ランク融合などの手法を使用して、複数の検索方法からのスコアを結合し、最終的なランク付けと統一された結果を提供します。セマンティック一致とキーワード一致を組み合わせることで、より効果的で正確な結果が得られます。アンサンブルリトリーバーは、検索エンジン、推奨システム、その他多くのユースケースに適しています。
ハイブリッド検索を使用した検索拡張生成(RAG)
ハイブリッド検索を使用すると、キーワード検索やセマンティック検索のみを使用する場合よりも正確な結果が得られるため、RAG が大幅に強化されます。相互ランク融合を使用した検索結果の再ランク付けにより、高品質の結果がさらに保証されます。次の図は、再ランク付けを使用するハイブリッド検索 RAG パイプラインを示しています。
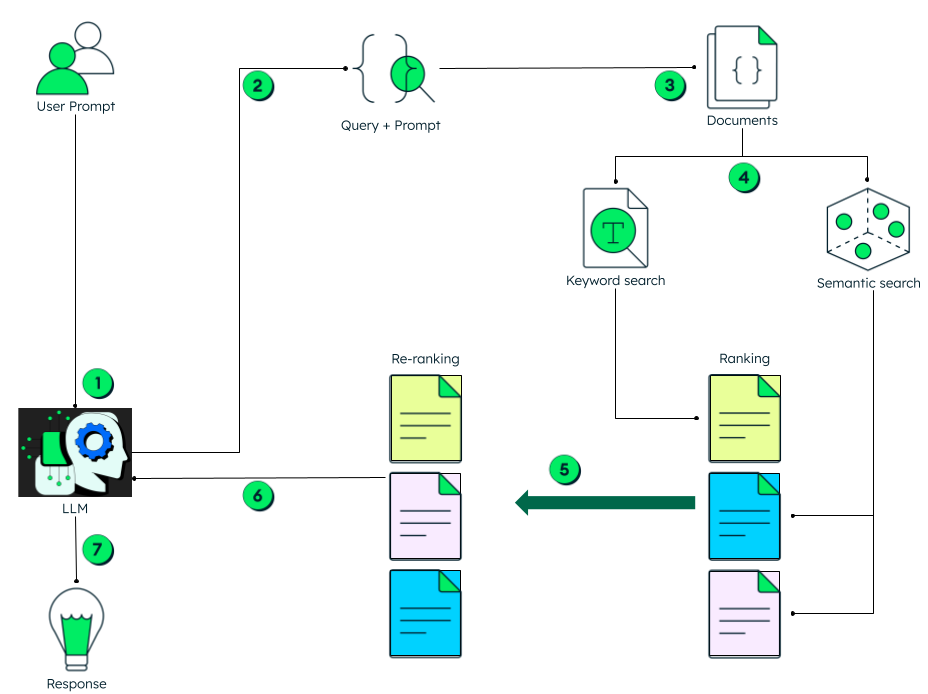
LLM はユーザープロンプトを受け取ると、クエリを生成し、関連するドキュメントを抽出するためにクエリとプロンプトの両方をデータストアに送信します。ハイブリッド検索が使用されるため、スコア付きの個別のランキングリストが 2 つ生成されます。1 つはキーワード検索から、もう 1 つはベクトル検索から生成されます。その後、これらのスコアは通常、相互ランク融合などの融合手法を使用して組み合わせられ、続いて再ランキングされます。最終的な結果セットは LLM に返され、LLM はその情報を使用してエンドユーザー向けの応答を生成します。
RRF を使用する理由
相互ランク融合の実装には、いくつかの利点があります。低密度ベクトルの結果や高密度ベクトル結果など、さまざまな手法の強みを組み合わせているため、結果の関連性が向上します。RRF アルゴリズムは、複数の検索メソッドのドキュメントランクに基づいて、逆数順位スコアを割り当てます。これにより、ハルシネーションが減り、個別のメソッドの使用によって発生する可能性のあるエラーが軽減されるため、検索結果のパフォーマンスと信頼性が向上します。コンテンツの要約、情報の検索、質問への回答システムといった RAG アプリケーションでは、精度と信頼性が極めて重要です。
RRF の仕組み
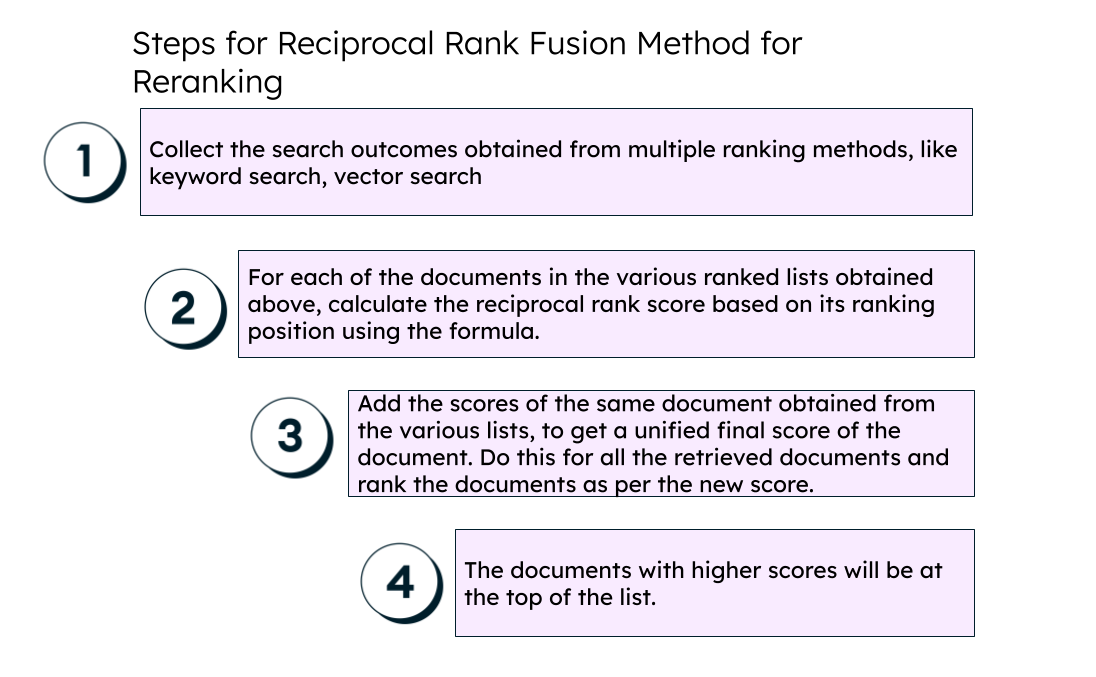
最初のステップとして、ユーザーがクエリを実行するたびに、複数の検索が開始されます。キーワード検索、セマンティック検索、またはその両方を使用できます。これらの各方法では、結果のランキングが生成されます。次のステップでは、生成された各結果の逆数順位スコアを計算します。スコアは次のように計算されます。
k は、個々のランキングの影響のバランスを取るのに役立つ定数です。k の値は、ランク位置に対する感度を決定します。
上記の式では、rank はリスト内のドキュメントの位置を表します。
一部の実装では、スコアを結合する前に、異なる検索戦略に異なる重みを割り当てることができます。これにより、ユースケースやドメインの要件に応じて、システムで特定の検索メソッド(セマンティック検索など)を優先できるようになります。
次のステップでは、各戦略から取得したスコアを組み合わせて合計し、単一のスコアを取得します。次に、組み合わせたスコアに基づいてドキュメントを再度ランク付けします(再ランク付け)。スコアが高いドキュメントは、最終的なランキングの上位に配置されます。
最終的な統合ランキングは、上記の手順から得られたリストです。これは正規化された結果ではなく混合された結果であり、結果をランク付けするより正確な方法です。
クエリ変換の例
「Best places to visit in Paris(パリで訪れるべき最高の場所)」という前回の例を考えて、相互ランク統合を複数のアルゴリズムの結果に適用して、最も関連性の高い結果を生成する方法を説明します。
まず、k の値を 60 に保持したまま、キーワード検索で得られた結果の逆数順位スコアを計算します。
- エッフェル塔 = 1/(1+60) = 0.0164
- ルーヴル美術館 = 1/(2+60) = 0.0161
- ノートルダム大聖堂 = 1/(3+60) = 0.0159
次に、セマンティック検索を通じて得られた結果の逆数順位スコアを計算します。
- モンマルトル = 1/(1+60) = 0.0164
- エッフェル塔 = 1/(2+60) = 0.0161
- マレ地区 = 1/(3+60) = 0.0159
- セーヌ川クルーズ = 1/(4+60) = 0.0156
次に、スコアを追加して結果を結合し、最もスコアが高いものを上に配置します。
- エッフェル塔 = 0.0164 + 0.0161 = 0.0325
- モンマルトル = 0.0164
- ルーヴル美術館 = 0.0161
- Le Marais = 0.0158
- ノートルダム大聖堂 = 0.0158
キーワード検索が観光場所のような正確なキーワードに焦点を当てる一方で、セマンティック検索はブログやレビューから得た個人の体験も考慮します。両方を組み合わせることで、ユーザーは両方のメリットを最大限に得られます。
RRF を使用した RAG のユースケース
RRF を使用した RAG の一般的なユースケースをいくつか紹介します。
- e コマースと小売:顧客は正確な製品名を検索する必要がなく、欲しいものを入力するだけで済みます。再ランク付けにより、ユーザーの検索語に基づいて、ユーザーにとって最も役立つ結果を提供できます。
- 医療・医学研究:キーワード(正確な検索語)とセマンティック検索(類似した研究)に基づいて検索データを取得することで、診断や治療に関する最も関連性の高いエビデンスが得られます。
- 市場分析:ニュースレポート、トランスクリプト、ブログ、提出書類などの複数の情報源からのデータを使用し、それをドメイン固有のデータ検索と組み合わせることで、分析対象の金融データについて、より正確で統合された視点が得られます。
- 採用プロセス: RAG は、履歴書の詳細と個人の面接トランスクリプトを組み合わせることで、採用プロセスを迅速化できます。RRF は、履歴書のデータに加えて、実践的な面接の経験に基づいて、複数の候補者の正確なランク付けを生成できます。