AIエージェントを構築するすべてのチームは、一つの基本的な真実を発見します。それは、正しい情報がなければ、エージェントは信頼できる答えるや正しいアクションを実行できないということです。
大規模言語モデルのコンテキストWindowsが拡大するにつれて、エージェントに提供する情報量を増やすだけで精度が向上すると考えがちです。しかし実際には、コンテキストを増やすとエージェントの速度は遅くなりコストが増加します。また、無関係な情報の中に有用なシグナルが埋もれてしまい、精度が低下する可能性もあります。
そのため、エージェントが成功するかどうかは、今やコンテキストエンジニアリングにかかっています。コンテキストエンジニアリングとは、タスクを効果的に完了するために必要な情報だけを選択、整理してエージェントに提示する手法のことです。
そして、その作業の中心は検索にあります。重要なのは、コンテキストにどれだけ詰め込めるかではありません。1,000万個の中からどの10個を選択するかです。
MongoDBのインテリジェント・データ・プラットフォームは、Voyage AIのクラス最高の埋め込みモデルとランキング・モデルを、複雑な抽出システムの構築、運用、進化のためのプラットフォームと融合させます。Rerank 3シリーズの導入と集計パイプラインでの$rerankの提供により、開発者は運用データと同じシステムで抽出されるコンテキストの品質と順序を向上できるようになります。その結果、エージェントがアクションを実行するために必要なコンテキストを提供する抽出システムをビルドする、よりシンプルな方法が実現します。
検索スタック
効果的な検索を行うには、有用な情報を見つけ出し、最も重要な要素を判断し、エージェントに効率的に提供するための統合システムが必要です。
この戦略によって、システムはデータを検索します。キーワード検索では正確な期間を抽出できますが、ベクトル検索では概念的に類似したコンテンツを検出できます。フィルターとハイブリッド・アプローチにより、精度と制御が強化され、関連するコンテキストのみが確実に抽出されます。
モデルは、データにとって「関連性」がどのようなものかを決定します。より優れた埋め込みモデルは、概念の類似性とクエリの意図を理解することで、ベクトル検索がより良い候補を特定するのに役立ちます。リランカーを使用すると、第1段階の取得で再現率を最適化し、候補セットから最も強い一致を分離できます。
適切なエンジンがこれらの異種テクノロジーを結集し、システムが本番環境で実行する間もデータの鮮度を維持し、クエリを効率化します。
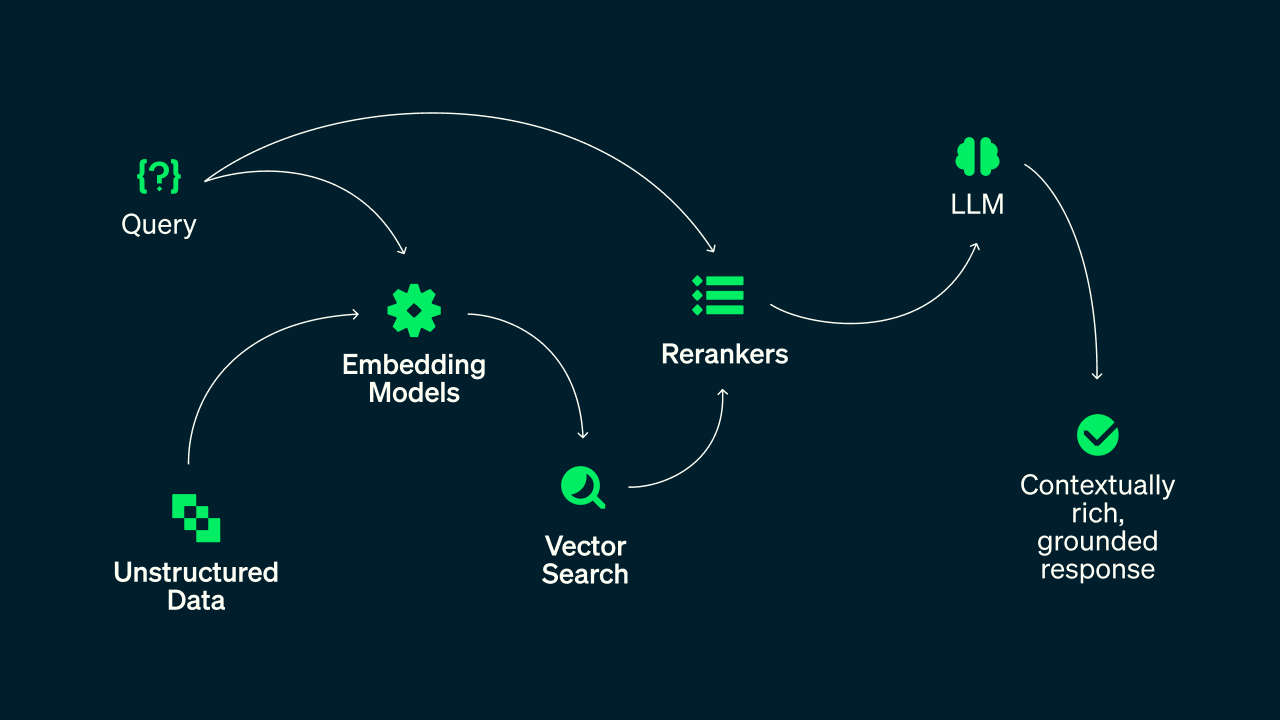
検索を管理する統合プラットフォームがなければ、作業はすぐに複雑になります。埋め込み用に1つのプロバイダ、リランキング用に別のプロバイダ、そして運用、検索、ベクトルデータ用に複数のデータベースベンダーを使用する場合があります。それは、保守すべき統合、同期ジョブ、API呼び出しが増えることを意味します。また、静かな問題を引き起こす可能性もあります。アプリケーションが別のバージョンを使用している間に、ベクトル検索インデックスが1つの埋め込みモデルバージョンを使用している場合、明示的なエラーを引き起こすことなく関連性が損なわれる可能性があります。
図 1.接続が解除された取得パイプライン。
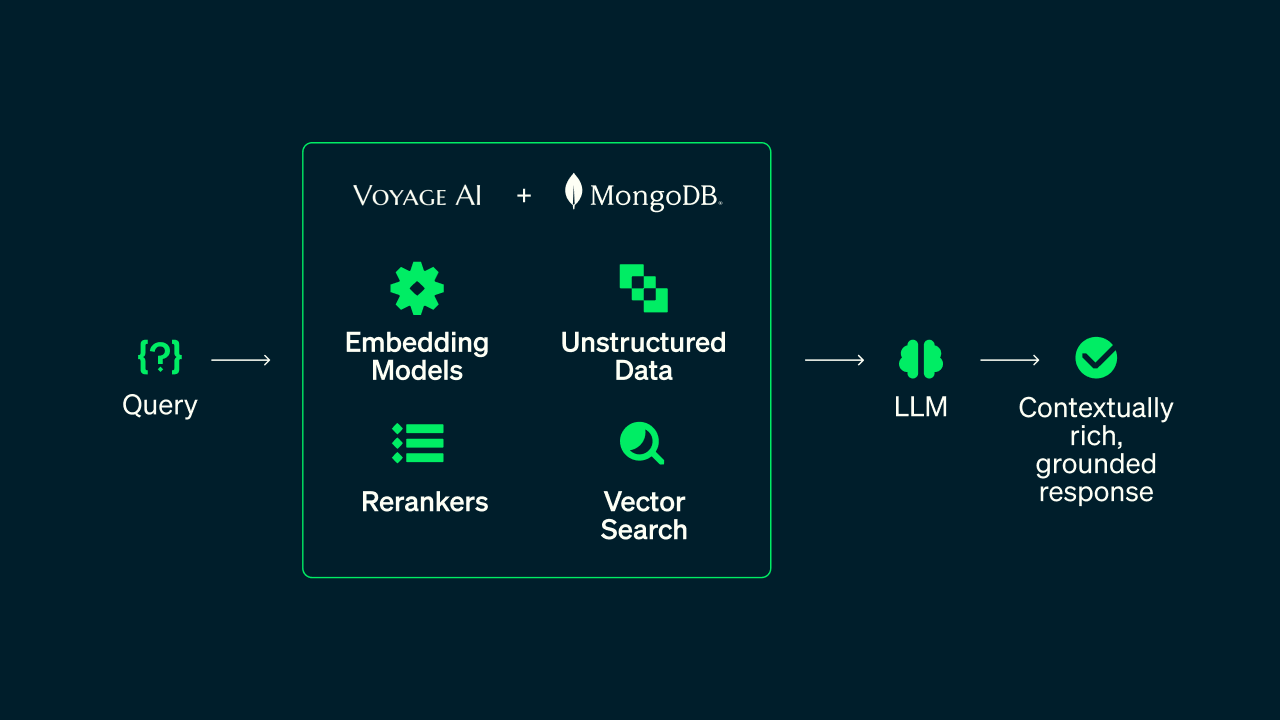
MongoDBは、これらの要素を単一のプラットフォームにまとめました。開発者が必要とするテキスト、ベクトル、ハイブリッド、フィルターによる検索戦略をサポートし、Voyage AIの最新の埋め込みモデルおよびリランカーと組み合わせることができます。Automated 埋め込みは、データが変更されてもベクトルを同期させ、ネイティブなリランクによって、開発者は同じ集計パイプラインで結果を洗練させることができます。その結果、運用データを検索し、適切な取得戦略を応用し、結果をリランクして、エージェントが必要とするコンテキストを返す単一のクエリが実現します。
図2. MongoDBによって駆動される統一された取得パイプライン。
モデル
本日発表されたrerank-3とrerank-3-liteは、すべてのタスクで精度が向上しており、長いドキュメントやコードで最大の成果が得られます。rerank-3は、Cohere Rerank v4.0 Proを全体で2.72%、Qwen3-Reranker-8Bを3.02%上回っています。現在、rerank-2.5をお使いの場合は、アップグレードはモデル名を1行変更するだけです。APIも価格も同じです。
rerank-3は、初期の候補セットがどのように抽出されるかに関係なく、関連性を向上させます。以下の表は、いくつかの一般的な第1段階の抽出手法全体における精度向上の結果を示しています。
表1.精度比較。
エンジン
MongoDBは、このすべてを支える運用上の検索エンジンであり、すべての戦略がアプリケーションがすでに書き込み (write)している同じデータに対してネイティブに実行されます。語彙検索は、識別子、エラーコード、正確な製品名をキャッチします。ベクトル検索は概念や言い換えを捉えます。ハイブリッド検索ではこれらを組み合わせ、メタデータフィルターで候補設定するを小さく保つことで高速性を維持します。そのため、データを別のシステムに移行したり、2つのコピーを同期させて維持したりする必要はありません。
Automated 埋め込みは、通常は問題が発生しやすい部分を取り扱います。ベクトルはフィールドレベルでリアルタイムに近い状態で生成および更新され、トークンの消費量とインデックスの状態はAtlas UIで確認できます。所有する埋め込みジョブはなく、インデックスのビルドに使用されたモデルバージョンと、クエリの実行するモデルバージョンの間に分裂が生じる可能性もありません。
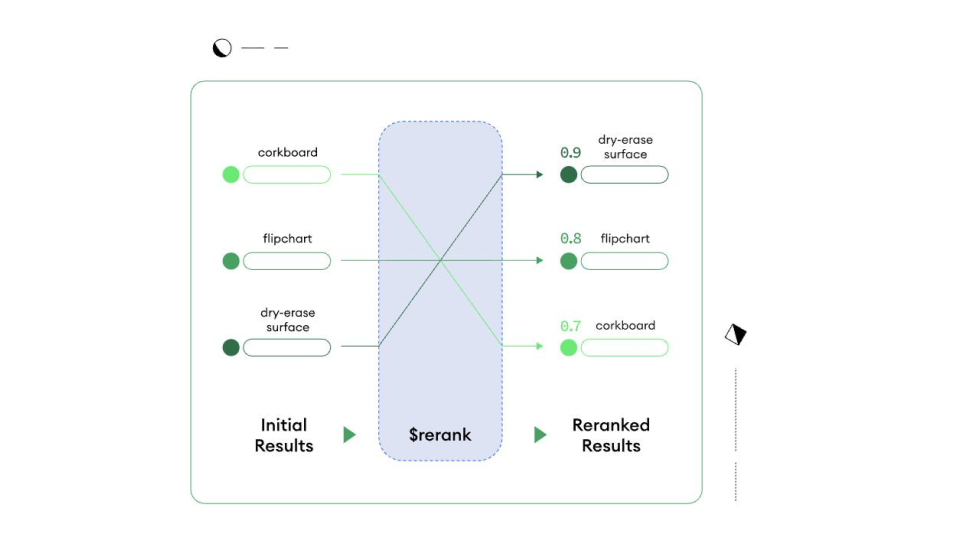
本日より利用可能な「$rerank」は、同じパイプラインの最後のステップとして並べ替え機能を追加します。これはインデックスを使わない段階で、前の段階で生成された候補セットを取得し、rerank-3またはrerank-3-liteを使ってスコアを再計算します。別のベンダーを使用する必要も、外部APIを呼び出す必要も、アプリケーションコードで再構築の手順を実行する必要もありません。これは、エージェントがタスクごとに1回ではなく、複数回検索を呼び出す場合に重要になります。
図 3。 $rerankのアクション
Gravity(重力):これが機能しているときの様子
Gravityは、AI時代の広告を最適化する広告ネットワークを構築しています。そこでは、レレバンス(関連性)があれば良いというわけではなく、レレバンスこそが製品そのものです。彼らの問題は再現率ではありませんでした。以前の埋め込みモデルとリランキングモデルでは、関連性スコアが密接にクラスタリングされていたため、Gravityは強力な一致と弱い一致を確信を持って分離できませんでした。
「私たちのベンチマークで明らかになった最も重要なことは、Voyage AIの能力が一致しない候補を識別し、一致する候補を実際に促進することでした」と、Gravityの共同設立者兼CTOであるLeo Martinez氏は述べています。Voyage AIに切り替えることで、リクエストの増加に伴い、取得レイテンシが約50%削減され、精度が向上しました。
The Gapを埋める
検索品質は、MongoDBがエージェントを実行するために構築しているレイヤーの一つです。MongoDB 9.0とAtlas Infiniteは、パフォーマンスと伸縮性のある増やすのレイヤーであり、エージェントのワークロードが作成する突発的なトラフィックを吸収します。Atlas Agent Engineはメモリとガバナンスのレイヤーであり、エージェントにセッション全体で持続的なコンテキストとガードレールを提供します。抽出はAtlas Vector SearchとVoyage AIによって駆動されます。エージェントは、何をすべきかを決定する前に、何を抽出するかを決定します。検索が不適切なままインフラストラクチャを高速化しても、間違ったことに対してより迅速に行動するだけです。
検索を正しく行うために、複雑なアーキテクチャはもう必要ありません。Automated Embeddingが埋め込みを取り扱い、$rerankが順序付けを行い、両方がMongoDBのオペレーショナルデータに対して直接実行されます。これらのモデルは、Atlas Embedding and Reranking APIを通じてスタンドアロンとしても利用可能です。
次のステップ
Automated 埋め込みとネイティブ Rerankingの概要は、こちらをご覧ください。MongoDB.local NYCでの発表内容や最新vの製品アップデート情報については、What's Newページをご覧ください。