目次
- 近似最近傍探索:AI 検索技術の基盤
- 近似最近傍探索に至るまでの検索の進化
- 近似最近傍探索のメカニズム
- 近似最近傍探索の仕組み
- ベクトルデータベースにおける近似最近傍の役割
- 近似最近傍探索を活用するアプリケーション
- 近似最近傍探索の利点
- MongoDB Atlas Vector Search と近似最近傍探索の検索クエリ
近似最近傍探索:AI 検索技術の基盤
近似最近傍探索(ANN)検索は、最近傍探索の一種であり、ベクトルデータベースにおいて特定の近似レベルで与えられたクエリ点に最も近いデータ点を見つけるために使用される手法です。
従来の検索方法とは異なり、近似最近傍探索は、特に高次元データの処理において効率化を目的としています。これは、精度と計算能力のバランスを考慮した近似レベルで、特定のクエリ点またはベクトルとの距離が近いデータポイントまたはベクトルを検索します。
近似最近傍探索は、大規模で複雑なデータセットを扱うことが不可欠な AI および機械学習アプリケーションにおいて特に価値があります。
たとえば、音楽ストリーミングサービスでは、近似最近傍探索は完全に同じではないとしても、ユーザーの嗜好に密接に一致する曲を推奨できます。医療画像診断においては、類似した診断画像を迅速に識別するのに役立ち、より迅速かつ正確な診断を可能にします。
近似最近傍探索は、より広範な最近傍探索アルゴリズムの一種ですが、精度と同様に速度が重要なシナリオ向けに特別に設計されています。このアプローチは、現代の AI アプリケーションで一般的な高次元空間において特に有効です。このような環境では、従来の厳密最近傍探索は計算負荷が高くなり、実現可能性が低下する場合があります。
この速度と精度の組み合わせにより、近似最近傍探索は現代のデータ駆動型アプリケーションにおいて不可欠なツールとなっています。
近似最近傍探索に至るまでの検索の進化
検索技術の歴史は初期の情報検索システムの探求に端を発しますが、商業的なユースケースにおける検索の普及は、AltaVista や Yahoo! といった初期の検索エンジンを通じてインターネットが登場したことで実現しました。これらのエンジンは、主に基本的なアルゴリズムを使用して、キーワードの頻度に基づいて Web ページをインデックス化し、ランキングしていました。キーワードの頻度はある程度有効でしたが、このアルゴリズムにはキーワードの詰め込みなどの問題がありました。インターネットの進化に伴い検索技術も進化し、Google はページ関連性とリンク分析に重点を置いたより洗練されたアルゴリズムを導入して、 Web ページの権威性と品質を判断するようになりました。
機械学習と人工知能の発展に伴い、検索技術は新しい時代を迎えました。これには、クエリの背景や意味を理解するセマンティック検索のような技術や、より直感的で正確な検索結果を得るためのニューラルネットワークベースのアプローチが含まれていました。
近似最近傍探索のメカニズム
近似最近傍探索の概念は K 近傍法(KNN)に似ていますが、高次元空間における効率とパフォーマンスに重点を置いています。
近似最近傍探索の機能と重要な概念
近似最近傍探索の中核となるのは、データセット内でクエリ点に最も近い点、または最も類似したデータ点を見つけるという原則です。これはさまざまな距離尺度を使用して実現され、その中で最も一般的なのは数値ベクトルに対するユークリッド距離です。近似最近傍探索の効率の鍵は、類似した項目を同じバケットに配置する局所性鋭敏型ハッシュなどのアルゴリズムを使用することにあり、これにより検索時間が大幅に短縮されます。
データセット内の他のすべての点を評価する網羅的な検索方法とは異なり、ANN はより効率的なアプローチを採用しています。このアプローチには、データポイントがグラフ内のノードであり、最近傍の検索がこのグラフ内の経路探索問題となるグラフベースの方法が含まれることがよくあります。この方法は、検索速度を向上させるだけでなく、結果のユーザー品質も向上させます。
近似最近傍探索の挑戦の1つは、欲張り検索アルゴリズムで発生する可能性がある局所的最小値を回避することです。近似最近傍探索アルゴリズムは、複数のパスを探索したり、直近の点を超えた手法を使用したりすることでこれを軽減し、より包括的な検索結果を保証するように設計されています。
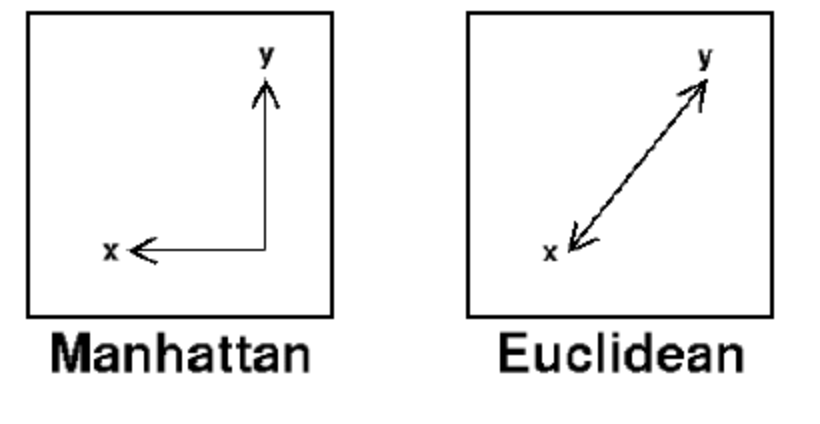
ソース: improvedoutcomes.com
近似最近傍探索における高度な手法の組み込み
近似最近傍探索は、Apache Software Foundation などの組織によるさまざまなソリューションや開発の影響を受けてきました。これらの影響により、多数の近似最近傍探索アルゴリズムのバリエーションが生まれ、それぞれが特定のデータタイプや検索要件に合わせて調整されています。たとえば、データセットが静的なシナリオでは、事前計算された最近傍を含むファイルによって予測フェーズを大幅に高速化できます。
近似最近傍アルゴリズムのパフォーマンスは、データセットの性質と検索タスクの具体的な要件に強く依存します。大規模なデータセットでは特に、近似最近傍アルゴリズムは、特定のクエリ点に対する候補点を効率的に検索し、検索フィールドを絞り込むことで、速度と効率を向上させます。
近似最近傍探索は、データセット内でクエリ点に「ほぼ」最も近いデータ点を識別し、データの性質に応じてユークリッド距離、マンハッタン距離、ハミング距離などの異なる距離メトリクスを利用します。この近似アプローチにより、近似最近傍探索は大規模で複雑なデータセットをすばやくナビゲートできます。これは、KNN のような厳密最近傍探索では計算負荷が高すぎる可能性があるタスクです。
近似最近傍探索(ANN)のパフォーマンスは、適切な距離メトリクスの選択と、多次元機能空間内のデータ点の効率的な表現に左右されます。
次元削減や機能の拡張などの手法は、データの高次元性を管理し、さまざまな機能の影響が均衡するようにするためによく使用されます。
たとえば、主成分分析(PCA)や t-Distributed Stochastic Neighbor Embedding(t-SNE)は、データの重要な特性を維持しながら次元数を削減するために使用され、検索の有効性を妨げる可能性のある疎性の問題を軽減します。
近似最近傍探索アルゴリズムは、完全一致は必要ないものの、近い近似値が大きな価値をもたらす、大規模なデータセットを扱う現実世界のシナリオに特に適しています。そのため、画像認識などのアプリケーションに最適です。このようなアプリケーションでは、近似最近傍探索により、膨大なデータセットから類似した機能を持つ画像を迅速に特定でき、大規模なAIアプリケーションにおける検索の効率と実用性が向上します。
近似最近傍探索の仕組み
近似最近傍探索は、データセット内でクエリの点に「最も近い」、または最も類似しているデータ点を見つけるという原則に基づいて動作します。厳密最近傍探索とは異なり、近似最近傍探索は速度と効率に重点を置いており、少程度の近似を許容することで結果を大幅に高速化します。このアプローチは、最新の AI アプリケーションに典型的な、厳密なマッチングが計算集約型になる高次元空間で特に効果的です。
近似最近傍探索は、データを高次元空間にマッピングし、クエリ点に最も近い点を迅速に識別することで機能します。その際、速度を優先して近似を使用します。
近似最近傍探索が実際にどのように機能するかを示す詳細な例に画像認識システムがあります。ここでは、近似最近傍探索は画像を分析し、それをベクトルに変換して、画像ベクトルのデータベースと比較できます。多次元空間でこれらのベクトル間の距離を計算することにより、類似した機能またはコンテンツを持つ画像を効率的に識別し、オブジェクト認識やコンテンツの類似性に基づく画像の分類などのタスクを促進します。
ベクトルデータベースにおける近似最近傍の役割
ベクトルデータベースにおいて、近似最近傍探索は、高次元データを取り扱う能力があるため、特に重要です。ベクトルデータベースは、従来のデータベースとは異なり、行や列ではなく、多次元空間内のベクトルとしてデータを表現します。この構造は、データ点(ベクトル)が複雑な複数属性の情報をカプセル化するAIおよび機械学習アプリケーションに最適です。
近似最近傍探索アルゴリズムは、指定されたクエリベクトルに最も類似したベクトルを迅速に特定することで機能します。これは、この多次元空間内のベクトル間の「距離」を計算することで実現されます。この近接性計算により、類似したアイテムを高速に取得できるため、画像認識などのタスクで非常に効率的になります。この場合、各画像はこの空間内の点であり、目標は視覚的に最も類似した画像を見つけることです。
結論として、近似最近傍探索がこの多次元ベクトル空間を効率的にナビゲート・検索する能力は、現代のデータ駆動型アプリケーションにおける基盤技術となっています。
出典:DALL-E で作成。
近似最近傍探索を活用するアプリケーション
近似最近傍探索アルゴリズムは、厳密一致よりも近似解を見つけることが重要な実世界のデータセットの処理に優れています。この特性により、さまざまなアプリケーションに最適です。
画像認識
コンピュータービジョンのユースケースでは、近似最近傍探索は膨大なデータセットから類似の特徴を持つ画像を迅速に特定できます。この機能は、オブジェクト認識やコンテンツの類似性に基づく画像の分類などのアプリケーションにおいて非常に貴重です。
音楽ストリーミングサービス
例えば、音楽ストリーミングサービスでは、近似最近傍探索を使用して、完全一致ではない場合でも、ユーザーの嗜好に合った曲を推奨できます。
医療画像
ヘルスケアにおいて、近似最近傍探索(ANN)は、クエリに類似した診断画像を迅速に特定するのに役立ち、患者の診断の速度と精度を向上させます。
近似最近傍探索の利点
ベクトルデータベースにおける近似最近傍探索の有効性は、複雑なデータ構造の処理と、進化するデータサイズへの適応性によって実証されています。利点は次のとおりです。
高次元データに対する有効性
ANN は、データが数百、数千の次元に及ぶ環境で優れています。この機能は、データ点が本質的に多次元で複雑である、ゲノミクスや複雑なシステムシミュレーションといったフィールドにおいて非常に重要です。
セマンティックおよびコンテキストに基づくデータ解釈
近似最近傍探索は、正確なデータ点と一致させるだけでなく、データの機能を掘り下げ、文脈やセマンティクスに基づいて類似性を理解および識別します。この側面は、単語やフレーズの意味や文脈がデータそのものと同じくらい重要である、自然言語処理や感情分析のような領域で特に有益です。
増大するデータに対応するスケーラビリティ
データセットが大きくなっても、近似最近傍探索はパフォーマンスを維持するため、ソーシャルメディアアナリティクスやリアルタイムの市場トレンド分析など、データ量が急速に拡大している業界やアプリケーションにおいて信頼できる選択肢となります。このスケーラビリティにより、データが追加されても、検索プロセスの効率と速度が損なわれることはなく、最も広大なデータセットであっても、タイムリーで関連性の高いデータを取得できます。データの量と規模が拡大するにつれて、近似最近傍探索は、正確さと速度のトレードオフを行い、効率的なレベルのパフォーマンスを維持します。
近似最近傍探索の堅牢性、微妙なニュアンスの理解、スケーラビリティにより、データに基づいた現代の意思決定と AI 開発において不可欠なツールとなっています。
MongoDB Atlas Vector Search と近似最近傍探索の検索クエリ
MongoDB Atlas Vector Search は、結果を検索するための ANN クエリをサポートし、元のデータと共にベクトル埋め込みを保存するため、アーキテクチャが効率化され、開発者のエクスペリエンスが向上します。強力な ANN クエリを活用することで、MongoDB Atlas Vector Search は、セマンティック検索やクロスモーダル検索などの複雑な検索を容易にし、最新の AI 駆動型アプリケーションに柔軟で堅牢なソリューションを提供します。
データが豊富なデジタル時代の環境を進む中、ベクトルデータベースにおける近似最近傍探索は重要な実現要因として注目されています。効率的でスケーラブルかつ文脈に富んだ検索機能を提供することで、開発者は高度で直感的なアプリケーションをビルドできるようになります。検索技術の未来は、単にキーワードを一致させることではなく、データの意味と文脈を理解することにあり、近似最近傍探索がその最前線を切り開いています。
ANN 検索と MongoDB Atlas Vector Search との統合についての詳細はベクトルデータベースページをご覧ください。